A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
O The Verge descreve a experiência de usar IA local com o Hermes, um app de agente de IA self-hosted para macOS, Windows e Linux. A instalação foi feita no Mac Studio com M5 Ultra, usando o modelo aberto Qwen 3.8 Flash Next, de 125 bilhões de parâmetros, com cerca de 105GB, e com foco em rodar modelos sem depender de serviços em nuvem.
Entre os testes, o Hermes executa tarefas como um briefing diário que lê e-mail e calendário, organiza a biblioteca do Steam por gêneros e categorias e faz análises de registros financeiros e comparações em planilhas. Para ações no computador, o agente precisa de permissões e, no caso do Steam, exige uma chave de API que pode ser revogada depois, mantendo dados sensíveis fora da nuvem.
A Apple informou em um documento regulatório que fechou um acordo com a startup de áudio personalizado Huxe por meio de um reverse acqui-hire, envolvendo contratação de membros da equipe e licenciamento de tecnologia. A empresa disse à Comissão Europeia que fará ofertas de emprego a “certos funcionários da Huxe AI” e que receberá uma licença não exclusiva dos direitos de propriedade intelectual da Huxe.
A Huxe foi fundada por desenvolvedores que trabalharam em recursos de podcast gerados por IA no NotebookLM, que depois foi renomeado para Gemini Notebook. Em 21 de maio, a startup anunciou o encerramento do serviço, com remoção do app das lojas, interrupção das atividades e exclusão de dados de usuários, e a Apple comunicou o acordo à Comissão Europeia em 9 de junho.
Agentes de IA já podem estar “no ar” e com serviço saudável, mas ainda assim a equipe precisa garantir que as respostas estejam melhorando. Ao conectar production traces, dados curados e avaliações, times conseguem identificar falhas, definir melhorias e demonstrar que a próxima versão funciona antes de chegar aos usuários.
O ciclo descrito passa por executar o agente, observar além da disponibilidade, curar exemplos de produção em datasets e suites de avaliação, melhorar o sistema e avaliar resultados antes e depois do deploy. A CoreWeave apresentou o CoreWeave Forge para integrar esse fluxo em um ambiente de desenvolvimento, reunindo ferramentas como Agent Lens, Notebooks, ARIA, Sandboxes e registros de modelos, experimentos e datasets para manter rastreabilidade da versão do modelo até os exemplos em produção.
A Microsoft lançou o Microsoft-Decision-1 no Foundry, três dias depois de a OpenAI abrir sua Decisions API para beta público. O modelo foi “post-trained” com base no Alibaba Qwen3.5-9B, com a empresa dizendo que pretende fazer um rebasing para seus próprios modelos MAI e também para a OpenAI. O preço informado é de US$ 0,042 por milhão de tokens de entrada, com saída gratuita, e o modelo aceita até 32.768 tokens de texto, retornando JSON.
A Microsoft afirma que o Decision-1 é usado internamente em tarefas como triagem de feedback de jogadores no Xbox Research, avaliação de respostas do Copilot e apoio a engenheiros em incidentes ao puxar contexto. A empresa também destaca o foco em decisões em “ambiente seguro e confiável”, mas não anunciou suporte a imagens e orienta clientes a validarem a calibração das probabilidades nos próprios dados, especialmente sob entradas adversariais.
Elon Musk afirmou que o Grok @Bot, lançado pela SpaceXAI em beta em agosto, vai usar o modelo mais adequado para cada tarefa. A orientação inclui opções como Claude Opus 5.5, além de integrações com serviços como MidJourney e Suno, com foco em maximizar o resultado em cada caso.
O texto também descreve como empresas estão adotando “model triage” para controlar custos: uma abordagem comum é usar modelos menores para triagem e reservar modelos mais caros para etapas que realmente exigem desempenho superior. A mudança traz ganhos de eficiência, mas exige testes e avaliação antes de trocar modelos, já que substituições podem quebrar fluxos e depender de ajustes como limites e rotinas de validação.
O Kubernetes está mudando a forma de lidar com limitações de recursos para workloads de IA na borda, com destaque para o recurso node swap e para a migração do Linux cgroup v2. A equipe do Kubernetes aponta que a memória costuma ser o primeiro gargalo em clusters, e que a onda de workloads agentic pode piorar esse cenário.
No Kubernetes v1.34, o node swap chegou à disponibilidade geral e pode atuar como “shock absorber” durante picos de tráfego, com ganhos de densidade reportados de até 3x em cenários específicos com NVMe SSDs. Ao mesmo tempo, o kubelet passa a recusar iniciar em nós com cgroup v1 por padrão a partir do v1.35, e a orientação é migrar os nós para o cgroup v2 antes de atualizar.
Agentes de IA para codificação conseguem gerar mais código e mais atividades em repositórios, mas o ganho não se converte em mais software entregue. Uma pesquisa com práticas reais de centenas de empresas aponta que o uso desses agentes eleva em média as linhas de código geradas em 30%, os commits em 20% e os pull requests em 23%. Ao mesmo tempo, a revisão humana continua sendo um gargalo importante no fluxo de produção.
O estudo indica que o processo de code review fica mais longo, com pull requests mais propensos a exigir revisões e com mais comentários dos revisores. Mesmo com a maior produção de código, a taxa de resolução de Issues e Epics — recursos acompanhados por ferramentas como Jira — não muda de forma estatisticamente relevante após a adoção de ferramentas de IA. A análise foi feita com dados agregados de Jellyfish, cobrindo 300 milhões de eventos de trabalho e informações de mais de 700 mil colaboradores em mais de 700 empresas, de 2021 até março de 2026.
A expansão das capacidades de inteligência artificial está levando universidades a reavaliar como conduzem pesquisa e formação, com foco em mudanças na matemática, estatística, machine learning e engenharia. Em um ensaio publicado pelo MIT Statistics and Data Science Center, Sasha Rakhlin sintetiza discussões sobre como a IA acelera a produção de resultados e altera a forma de verificar e melhorar modelos.
O texto destaca que, em áreas onde verificação e avaliação são rápidas e confiáveis, sistemas podem gerar candidatos, aprender com resultados e acelerar o avanço científico. Rakhlin defende que departamentos repensem o que valorizam em artigos e na formação de doutorandos, incluindo reconhecimento de contribuições reais mesmo quando partes do trabalho usam IA, além de orientar universidades a construir infraestrutura e fluxos compartilhados para permitir colaboração entre laboratórios com agentes de IA.
APIs compatíveis com OpenAI estão sendo usadas para permitir conversas multi-turn com agentes, mas escalar esse tipo de fluxo exige cuidados com estado e roteamento entre réplicas. O texto descreve um endpoint mínimo compatível com /v1/chat/completions que falha de forma “silenciosa” quando o tráfego é distribuído: o modelo pode responder sem o contexto correto se cada turno cair em uma máquina que não tem o histórico da conversa.
Para resolver, a proposta retoma princípios de microservices e padrões como bulkheads, movendo o estado da conversa para um armazenamento compartilhado para que qualquer réplica possa atender qualquer turno. A discussão também destaca como “agent traffic” difere do tráfego web por ser mais longo, mais imprevisível em tool calls e mais sujeito a rajadas, exigindo desenho de API que absorva essas características.
A Microsoft realizou seu primeiro evento ao vivo em dois anos e apresentou o Surface Laptop Ultra, além de mudanças no Windows 11 voltadas a fluxos com IA local e agentes. O novo notebook, anunciado em maio de 2026, passa a usar o Nvidia RTX Spark SoC, terá preço inicial de US$ 2.599 e começa a ser enviado em 16 de outubro, com pré-venda aberta.
O Surface Laptop Ultra traz configurações com GPU Blackwell de 5120 ou 6144 cores e até 128GB de memória LPDDR5x unificada, com foco em permitir desenvolvimento e execução de IA local. No evento, também foi revelado o Surface RTX Spark Dev Box, uma caixa de US$ 5.999 com Windows 11 otimizado para desenvolvimento, 128GB de memória unificada e GPU Nvidia RTX, com promessa de 1 petaflop de desempenho para IA.
O projeto de documentação Docsy, criado pela Google e usado por grandes iniciativas de cloud native, está migrando para a Linux Foundation. O anúncio foi feito por Erin McKean, da Google e membro do comitê do Docsy, em uma keynote no Open Source Summit Europe, em Praga.
O Docsy é um tema open source para o gerador de sites estáticos Hugo e já era adotado por cerca de 2.200 projetos até o fim de 2024, incluindo Kubernetes, OpenTelemetry, gRPC e Jaeger. A iniciativa passou a adaptar a saída para ferramentas de IA, como a geração de cópias em Markdown e um arquivo llms.txt (a partir da versão 0.15.0), além de recursos experimentais para orientar agentes, como diretivas ocultas apontando para o índice do llms.txt. A roadmap inclui também “AF” (agent-friendly documentation scores) para medir o quanto a documentação é fácil de encontrar, navegar e consumir por agentes.
A Nous Research, startup por trás do agente open source Hermes, levantou uma rodada Série B de US$ 90 milhões em uma avaliação de US$ 1,5 bilhão. O investimento foi liderado pela Robot Ventures, com participação de Nvidia, Union Square Ventures, Menlo Ventures, Samsung e 1789 Capital, além de trazer o total captado pela empresa de três anos para US$ 158 milhões.
A Nous também anunciou o “Hermes for Businesses”, voltado ao setor corporativo, para permitir que empresas implantem agentes de IA personalizados capazes de executar fluxos de trabalho com múltiplas etapas mantendo os dados privados e seguros. A empresa afirma que o Hermes já foi clonado mais de 24 milhões de vezes e que isso representa cerca de 2,5% do uso global de tokens de IA, além de mirar crescimento de receita anualizada acima de US$ 100 milhões até o fim de 2026.
Criar e editar imagens com inteligência artificial pode começar com uma simples descrição: basta detalhar o que deve aparecer, o cenário, o estilo e como a imagem será usada. Ferramentas gratuitas como ChatGPT e Gemini ajudam a gerar retratos, ilustrações, convites e outros conteúdos, com possibilidade de refinar o resultado em uma mesma conversa.
O guia reúne comandos e formatos de prompt, incluindo instruções de enquadramento e proporção (como opções quadrada, vertical ou horizontal) e orienta como ajustar iluminação, cores e nitidez. Também mostra fluxos para editar fotos enviando imagens e pedindo mudanças específicas, além de exemplos de criação e edição em ferramentas como Copilot, Canva e Adobe Firefly.
O Nemotron, modelo da Nvidia, foi fine-tunado para criar especialistas e alcançou resultados de nível medalha de ouro em IMO 2026 e IOI 2026. No IOI, o desempenho veio de uma execução ao vivo com as mesmas restrições de tempo, acesso à internet e submissão dos competidores, sem entrar no ranking oficial; no IMO, as provas enviadas foram avaliadas por examinadores oficiais.
O processo combinou SFT, reinforcement learning (RL) e um fluxo de inferência que gera, avalia e refina respostas. Para programação competitiva, o time curou 22.000 problemas e treinou dois especialistas (Nemotron-3-Nano-CC e Nemotron-3-Ultra-CC), enquanto no projeto de matemática olímpica foram usados conjuntos de dados com exemplos de provas e um sistema de geração, pontuação, críticas e refinamento, sem prover acesso à internet ou uso de prover formal externo.
A Ploomes, startup de CRM para médias empresas, lançou o Estúdio IA para permitir que clientes criem interfaces e fluxos de trabalho personalizados dentro do CRM sem depender de programação. A solução inclui um construtor de telas que gera dashboards, formulários e miniaplicações a partir de descrições em texto, além de um integrador para montar automações com agentes e integrações com ferramentas como Slack e Gmail.
A empresa também aposta em recursos como CPQ em Branco, que transforma regras de precificação interpretadas a partir de arquivos em campos para propostas, e o Radar Ploomes, que transcreve interações do vendedor com clientes. Entre 2026 e 2027, a Ploomes vai investir R$ 25 milhões em inteligência artificial para ampliar o Estúdio IA, com foco em aumentar volume de vendas e taxa de conversão, mantendo dados dos clientes em infraestrutura preparada para segurança e LGPD.
Ferramentas de IA estão sendo incorporadas diretamente aos fluxos de trabalho de empresas, seguindo um padrão observado em times que avançam mais na adoção da tecnologia. Em vez de depender apenas de chatbots, as equipes passaram a usar recursos de IA dentro de plataformas que já utilizam para trabalhar, como Microsoft 365, GitHub, Google Workspace, Slack, Adobe e Notion. Dados da Okta apontam crescimento de ferramentas de IA integradas a essas plataformas, enquanto um levantamento da Zapier com 375 empresas destaca que a IA costuma fazer parte de processos maiores conectados a outros aplicativos.
Entre os exemplos citados, o Microsoft 365 Copilot atua em Word, Excel, PowerPoint, Outlook e Teams para resumir reuniões e e-mails, analisar informações e criar apresentações, com a empresa informando em julho de 2026 que o serviço ultrapassou 30 milhões de licenças pagas. Já o GitHub usa IA para sugerir código, explicar trechos e ajudar a encontrar erros no ambiente de desenvolvimento, enquanto Notion, Canva e Grammarly levam recursos de IA para documentos, criação visual e revisão de textos; no lado de automação, o Zapier integra IA para interpretar informações, classificar dados e gerar conteúdo, com 84% das empresas usando IA para produzir mensagens ou documentos e 79% para extrair informações e atualizar registros.
O Penguin Mail lançou a versão 1.0.0, um cliente de e-mail open-source para Linux que reúne Gmail, Outlook e contas IMAP/POP3 em uma única interface local. O app também agrega calendário e contatos, com visualizações de dia, semana, mês e agenda, além de sincronização contínua a partir da bandeja do sistema.
A novidade inclui um assistente acionado pelo atalho Ctrl+J para fazer perguntas sobre mensagens enviadas pendentes de resposta e sobre o conteúdo de categorias como promoções. O software pode rodar no próprio computador via LM Studio ou Ollama e pede confirmação antes de enviar e-mails ou alterar configurações, com a possibilidade de usar GnuPG para assinatura e criptografia.
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
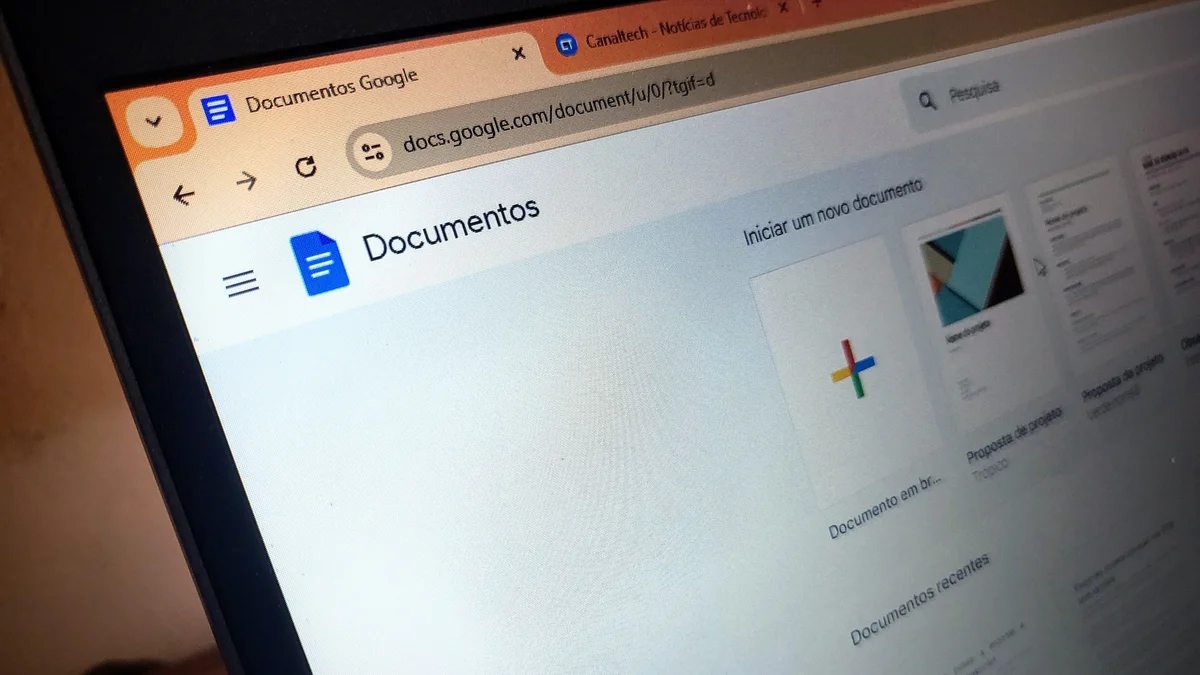
O Google passou a oferecer suporte nativo a arquivos Markdown (.md e .markdown) no Docs e no Drive, permitindo abrir, editar e colaborar nesses documentos sem convertê-los para o formato do Google Docs. A atualização começou a ser liberada nesta segunda-feira (5) e pode levar até 15 dias para chegar a todos os usuários.
Com o Drive, a prévia passa a exibir o conteúdo já formatado, com links clicáveis, títulos na hierarquia correta e tabelas estruturadas. A mudança também pode facilitar fluxos com inteligência artificial, já que modelos de linguagem usam Markdown para manter organização como títulos, tabelas e listas, embora recursos exclusivos do Docs possam ser alterados durante a edição.
A startup Hark, fundada há menos de um ano por Brett Adcock, liberou amplamente o Hark Pro, um assistente pessoal de IA com foco em privacidade. O serviço pode ser usado gratuitamente, com uma camada de assinatura para usuários mais intensivos.
O Hark Pro foi descrito como uma interface para “AI computers”, usando o computador do usuário para executar tarefas digitais e responder dúvidas clássicas de chatbot. A experiência em tela cheia traz um chat central, um feed com prompts de ações e “panels” com mini-dashboards, além de mostrar em uma janela como o agente navega na web para aumentar a confiança.
Depois do básico, o aprendizado de IA tende a sair de tarefas simples e ir para usos mais complexos, como estruturar processos com várias etapas. Em vez de depender só de comandos individuais, a evolução passa por definir objetivos, fornecer contexto e acompanhar cada fase para chegar a resultados confiáveis.
Outra frente é aprender a trabalhar com informações da rotina profissional, como planilhas, relatórios e bases internas, respeitando regras de segurança. Também ganha espaço conectar a IA a outras ferramentas para automatizar tarefas, além de desenvolver a checagem de fontes e a comparação de resultados quando as respostas ficam mais difíceis de validar rapidamente.
A AWS abriu o código do Pizza Bot, uma aplicação self-hosted que permite que agentes de IA executem tarefas em segundo plano e devolvam os resultados em uma interface estilo caixa de entrada. O sistema organiza fluxos longos com threads de trabalho, suporta execução agendada ou acionada por webhook e permite delegar tarefas a workers especializados, pedindo aprovação humana quando ações forem consideradas sensíveis.
Com licença Apache 2.0, o Pizza Bot usa arquitetura cliente-servidor e mantém estado do agente, checkpoints, anexos e logs localmente em uma pasta controlada pelo usuário. O projeto foi desenhado para enviar dados apenas ao provedor de modelo configurado e para MCP servers explicitamente habilitados, com credenciais armazenadas no secret store do sistema, reduzindo a necessidade de monitoramento contínuo durante a execução.
A Archestra lançou o OpenAPPA, um motor de segurança open-source para impedir exfiltração de dados causada por prompt injection ou alucinação de modelos. O sistema roda fora do loop de prompt e execução do agente e usa uma configuração appa.toml para definir fontes de dados, audiências, níveis de confiança e autoridades, com regras determinísticas de aplicação.
Em benchmarks como Bench-Corp (20 fluxos corporativos) e AgentThreatBench, o OpenAPPA reportou 0% de ataques bem-sucedidos, mantendo 89% de conclusão de tarefas. A equipe também aponta que abordagens estocásticas baseadas em “modelo-juiz” tendem a falhar por não rastrear o fluxo de dados entre tool calls, e descreve mecanismos de recuperação, como sanitização, aprovação por autoridades e Child Branches descartáveis para isolar dados não confiáveis.
A Capcom apresentou, na Capcom Open Conference RE: 2026, um plano para evoluir o RE Engine com foco em integrar tecnologia de IA aos fluxos de desenvolvimento. O programador Satoshi Ishida destacou os desafios de produzir jogos no mesmo nível de Resident Evil, em que até tarefas simples podem consumir muito tempo.
A empresa afirmou que não pretende usar assets gerados por IA nos jogos e, em vez disso, quer usar a tecnologia para tornar o desenvolvimento mais eficiente. A estratégia descrita é transformar o RE Engine de forma gradual em uma “AI-generation game engine”, mirando um futuro em que a criação de jogos aconteça “juntos com IA”.
A DoorDash criou a equipe “GenAI Platform” para viabilizar projetos com inteligência artificial generativa e compartilhou, em uma apresentação, como estruturou a plataforma desde 2023. O time relata que começou após o “momento ChatGPT” (nov/22), decidiu usar OpenAI e focou em princípios como ser “customer obsessed”, priorizar APIs/SDKs e construir fluxos ponta a ponta, e não apenas notebooks ou acesso a GPUs.
A estratégia também evitou apostar em chatbots e direcionou o trabalho para impacto no negócio, com casos ligados a automação, recomendações e personalização. A plataforma já tem mais de 5.000 usuários internos e registra 45 novos cadastros por dia, com cerca de 40% do público formado por não engenheiros usando APIs, o que levou o time a reforçar governança e accountability na adoção.
A Anthropic lançou uma atualização do Claude que incorpora o Cowork, recurso que executa tarefas agendadas mesmo depois que o usuário fecha o laptop. A mudança chega como parte do app principal do Claude, unificando a função de jobs de longa duração em um fluxo já usado por quem trabalha com o assistente.
A atualização também entra no contexto da corrida por agentes sempre ativos: OpenAI apresentou os Dots no DevDay, Meta lançou o Muse e o xAI colocou o Grok Bot em circulação. Com isso, a Anthropic tenta aumentar o uso recorrente do Claude entre desenvolvedores e equipes que já usam a ferramenta para tarefas contínuas.
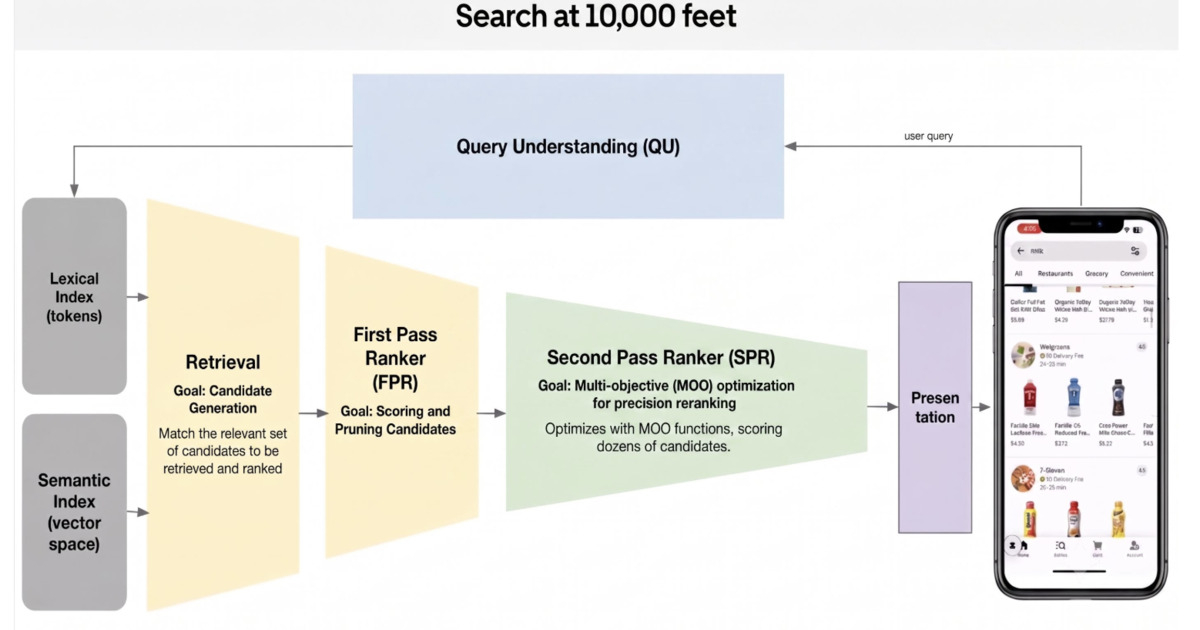
A Uber refez partes importantes do pipeline de busca do Uber Eats e relata uma redução de 50% na latência fim a fim. As mudanças atravessam recuperação (retrieval), hidratação de features, ranking, caminho de anúncios, apresentação e infraestrutura, com uso de um fluxo de coding agentic para identificar, benchmarkar e validar otimizações adicionais.
A empresa também trocou o foco do indicador principal: em vez de medir o tempo de resposta de APIs, passou a acompanhar o Above-the-Fold completion, tempo até a primeira tela de resultados com imagens. Com paginação e cache no servidor, renderização assíncrona e ajustes como descarte de candidatos de baixo valor, embeddings de produto e separação entre hidratação de ranking e apresentação, a Uber diz ter melhorado o Above-the-Fold em mais de 200 ms e cortado etapas específicas em dezenas de milissegundos, além de redesenhar o caminho de anúncios e reduzir overhead de infraestrutura.
A Clay vai apresentar no TechCrunch Disrupt 2026 a sessão “The GTM Engineer: How AI Created Tech’s Next Big Job Category”, com o cofundador e CEO Kareem Amin. O evento destaca como a função de “GTM engineer” vem surgindo em empresas de tecnologia ao usar IA e automação para construir sistemas de receita antes dependentes de várias pessoas, ferramentas e processos manuais.
A programação também detalha como a IA está mudando o go-to-market: pesquisa de prospects, trabalho com dados, personalização de outreach e automação de fluxos que antes ficavam divididos entre times e ferramentas. A Clay cita que cerca de 100 vagas de GTM engineering aparecem por mês e aponta seu agente Claygent, alimentado por OpenAI, para automatizar pesquisa e contato para áreas como vendas, marketing e recrutamento.
Um estudo do NetLab (UFRJ) mapeou o fluxo de desinformação até chegar ao grande público durante o primeiro turno das eleições de 2022, analisando 115,3 mil mensagens no WhatsApp e 180,9 mil no Telegram. As narrativas costumam nascer em canais menores e grupos de mobilização e, quando ganham tração, são adaptadas para redes como Instagram, TikTok, Kwai e Facebook, onde atuam recomendação algorítmica, influenciadores e impulsionamento pago.
No centro do alcance está o vídeo curto, apontado como o formato mais “viralizável” para catalisar a desinformação. Com a popularização da IA generativa, o impacto dos deepfakes cresce: um relatório da ANPD indica que o Brasil concentra 39% dos casos na América Latina em 2025 e registra aumento de 126% nos ataques com imagens, vozes e identidades falsas, ampliando o desafio de transparência e fiscalização das plataformas.
A Bit Cloud lançou o Bit Cloud 2.0 com o Hope, um “builder” integrado de IA para ajudar a transformar um app gerado a partir de prompts em algo que equipes possam manter e evoluir. A proposta conecta a criação do aplicativo com as etapas seguintes, como execução, revisão de mudanças e infraestrutura para que novas versões funcionem como esperado.
A plataforma traz um dashboard interno com login, banco de dados e integrações externas e permite reutilizar componentes já criados e testados pela equipe. O fluxo também inclui colaboração entre desenvolvedores, designers e gestores, além de recursos para desenvolvimento mobile com prévias de staging, verificações de build e revisão de código, reduzindo trabalho repetido e custos de tokens.