12 resultados para Embeddings
Terça · 06 out
2026-10-06
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
#InteligenciaArtificial · #IAgenerativa · #Embeddings · #RAG · #BuscaMultimodal · #AndroidMLKit · #OnDeviceAI
Sexta · 02 out
2026-10-02
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
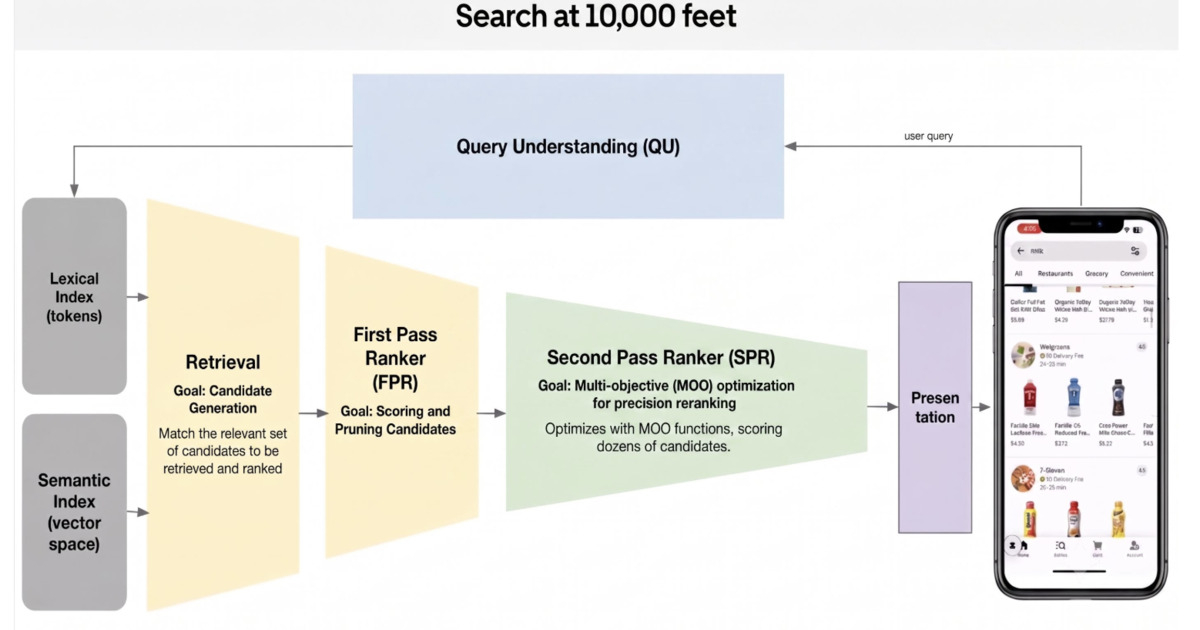
A Uber refez partes importantes do pipeline de busca do Uber Eats e relata uma redução de 50% na latência fim a fim. As mudanças atravessam recuperação (retrieval), hidratação de features, ranking, caminho de anúncios, apresentação e infraestrutura, com uso de um fluxo de coding agentic para identificar, benchmarkar e validar otimizações adicionais.
A empresa também trocou o foco do indicador principal: em vez de medir o tempo de resposta de APIs, passou a acompanhar o Above-the-Fold completion, tempo até a primeira tela de resultados com imagens. Com paginação e cache no servidor, renderização assíncrona e ajustes como descarte de candidatos de baixo valor, embeddings de produto e separação entre hidratação de ranking e apresentação, a Uber diz ter melhorado o Above-the-Fold em mais de 200 ms e cortado etapas específicas em dezenas de milissegundos, além de redesenhar o caminho de anúncios e reduzir overhead de infraestrutura.
#InteligenciaArtificial · #IA · #engenhariaDeSoftware · #latencia · #searchpipeline · #retrieval · #ranking · #GoLang
Segunda · 14 set
2026-09-14
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
Repetir a mesma pergunta em um LLM pode gerar cobranças a cada resposta, mesmo quando nada mudou. A proposta é criar uma chave de cache por “fingerprint” dos insumos e dependências (request, contexto, configurações do modelo e dados subjacentes) e reutilizar a resposta quando ela continuar válida e segura.
O texto descreve uma estratégia em três níveis: cache exato com normalização e hash SHA-256 em um store como Redis; cache semântico com embeddings e busca por similaridade (com limiar de cosseno entre 0,90 e 0,95, ajustável); e um modelo híbrido que tenta o exato primeiro e só faz a busca semântica em caso de “miss”. Em ambos os casos, a chave precisa considerar contexto, versão de fontes e escopo de acesso para evitar reutilização incorreta entre usuários e documentos diferentes.
#InteligenciaArtificial · #IA · #LLM · #Caching · #EngenhariaDeSoftware · #Programacao · #PromptEngineering
Segunda · 07 set
2026-09-07
1 matéria
IA

Pesquisa · IA
O engrim propõe uma “memória episódica” local-first baseada em SQLite para CLIs e agentes de IA, mantendo decisões, restrições e estado do projeto ao alternar entre modelos e ambientes no mesmo repositório. A proposta é evitar a perda de contexto causada por janelas de contexto maiores e pelo custo que cresce a cada turno, substituindo isso por uma memória curada de trabalho.
O engrim combina busca full-text com SQLite FTS5 e embeddings vetoriais (model2vec) em um motor híbrido de recuperação, com suporte a ambientes como Google Antigravity, Claude Code, Cursor MCP e Codex CLI via MCP tools. O projeto também descreve instalação e configuração automática (por exemplo, com engrim setup e engrim setup --all) e testes citados com 105 sessões contínuas e migração não destrutiva de dados ao adicionar campos como origin_agent.
#InteligenciaArtificial · #IAgenerativa · #AgentesDeIA · #LLM · #MCP · #SQLite · #DesenvolvimentoDeSoftware
Domingo · 06 set
2026-09-06
1 matéria
IA
Destaque

Pesquisa · IA
Uma pesquisa apresenta um método para traduzir embeddings de texto entre espaços vetoriais diferentes sem dados pareados, sem encoders e sem conjuntos pré-definidos de correspondências. O trabalho propõe uma abordagem não supervisionada que mapeia embeddings para uma representação latente universal, descrita como uma estrutura semântica conjecturada pela Platonic Representation Hypothesis, preservando a geometria dos vetores. Os autores relatam alta similaridade cosseno entre modelos com arquiteturas, tamanhos de parâmetros e conjuntos de treino distintos.
A capacidade de converter embeddings desconhecidos para outro espaço mantendo sua estrutura é apontada como relevante para a segurança de bases vetoriais. O texto destaca que um adversário que tenha acesso apenas aos vetores pode extrair informações sensíveis dos documentos, o suficiente para classificação e inferência de atributos.
#InteligenciaArtificial · #IA · #MachineLearning · #Embeddings · #Vetores · #SegurancaDeDados · #VectorDatabases
Domingo · 30 ago
2026-08-30
2 matérias
IA
Destaque
Pesquisa · IA
Pesquisas recentes em modelos de difusão contínua para linguagem reacenderam o interesse na abordagem, após alguns anos de pouca atividade. Métodos de difusão totalmente discretos haviam se tornado dominantes, mas a tendência parece começar a mudar com novos trabalhos e atualizações do tema.
O texto relembra a evolução do campo: tentativas discretas surgiram em 2021, enquanto abordagens contínuas apareceram em 2022 com propostas como Diffusion-LM, que usa embeddings contínuos para viabilizar a corrupção com ruído gaussiano. Depois de 2023, a difusão contínua teria “desaparecido” em favor da discreta, e a retomada atual é atribuída a mudanças no foco do desempenho e nas expectativas sobre escalabilidade.
#InteligenciaArtificial · #IA · #IAgenerativa · #DiffusionModels · #ModelosDeLinguagem · #MachineLearning
Eng · Dev com IA
Destaque
Engenharia · Software com IA
A Cloudflare lançou o AI Search, um serviço de busca e recuperação embutido para dar a agentes de IA e aplicações um mecanismo pronto para pesquisar dados customizados. A plataforma integra recursos que antes exigiam montar uma pipeline completa, incluindo crawling, parsing, embeddings, banco vetorial e API de busca, automatizando o fluxo de ponta a ponta.
O AI Search consegue indexar coleções estruturadas ou não e também operar em “discover mode”, descobrindo páginas mesmo sem sitemap. Para criar uma instância, a Cloudflare indica um comando com npx wrangler ai-search create, e a busca pode ser integrada via Workers, ou exposta por endpoints públicos como /mcp e /search, com indexação unificada de fontes como Astro, Vite, Hono e Replicate.
#InteligenciaArtificial · #IA · #AgentesDeIA · #BuscaPorIA · #RAG · #DesenvolvimentoDeSoftware · #Cloudflare
Quarta · 26 ago
2026-08-26
1 matéria
IA
Pesquisa · IA
Muita gente monta sistemas RAG de forma “over-engineered”, indo direto para embeddings, bases vetoriais e pipelines de reranking, mas o texto defende que o ponto de partida pode ser mais direto. A recomendação é escolher a abordagem conforme necessidades como atualização dos dados, características do corpus, padrões de consulta, escala de uso e capacidade do time.
O guia sugere começar pelo “MVP” com busca full-text usando BM25 (como Elasticsearch ou Postgres full-text search) quando as consultas são mais baseadas em palavras-chave e a prioridade é evitar complexidade de ML. Para consultas conversacionais ou com vocabulário desalinhado, a proposta é usar um LLM para reescrever a pergunta em uma busca keyword, e, quando fizer sentido, evoluir para busca híbrida combinando BM25 para candidatos e embeddings para reranking.
#InteligenciaArtificial · #IA · #RAG · #BuscaSemantica · #LLM · #BM25 · #HybridSearch
Domingo · 23 ago
2026-08-23
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
IA em tempo real em escala é mais difícil do que parece: pipelines que funcionam bem no desenvolvimento podem falhar em produção, com problemas como aumento de latência e queda de acurácia. Em um app de trading baseado em ML, a latência P99 disparou para 3 segundos quando o sistema chegou a cerca de 740 mil operações por segundo, apesar de a média parecer aceitável. O diagnóstico apontou que a lentidão não estava no modelo, mas em buscas e contenção sob carga, com o Postgres sendo pressionado no cenário específico.
A precisão também pode piorar quando os dados ficam desatualizados: perfis de usuários (wallet addresses) ultrapassaram uma SLA de 5 minutos por horas, embeddings ficaram obsoletos e métricas offline continuaram boas até a integração com dados online. Além disso, índices vetoriais precisam de manutenção, já que reembeddings degradam a qualidade do índice ao longo do tempo, reduzindo recall para 42% e elevando a latência de consulta. O texto ainda destaca que treinamento e serving devem ser separados quando possível e que retraining é inevitável, exigindo transição para evitar janelas de previsões defasadas.
#InteligenciaArtificial · #IA · #MLOps · #Latencia · #DataPipeline · #VectorSearch · #ML
Domingo · 16 ago
2026-08-16
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
A AWS introduziu a busca vetorial nativa no Amazon DynamoDB, permitindo armazenar embeddings junto aos dados da aplicação e executar consultas de nearest-neighbor aproximadas diretamente no banco, sem depender de um banco vetorial separado. O recurso inclui buscas de similaridade com filtros e índices vetoriais configuráveis para cargas de semantic search.
Com o novo tipo de índice do DynamoDB, desenvolvedores criam um vector index com as dimensões e a função de distância necessárias e consultam via a API SearchVectors. A AWS cita suporte a até 4096 dimensões, funções Euclidean, Cosine e Dot product, além de inline filtering, e mostra um exemplo em Python usando embeddings do Amazon Bedrock para localizar papers por significado. O custo do índice é cobrado por dimensões e também por bytes gravados, processados e armazenados.
#InteligenciaArtificial · #IA · #AWS · #DynamoDB · #VectorSearch · #RAG · #Embeddings
Sexta · 14 ago
2026-08-14
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
O MongoDB anunciou o Atlas Managed MCP Server, uma forma totalmente gerenciada de conectar agentes ao MongoDB Atlas sem exigir que os desenvolvedores montem e mantenham infraestrutura adicional. Com o novo servidor, o Atlas pode ser integrado a ferramentas como Claude Code, Codex, Grok Build e Devin.
A proposta é permitir que agentes e times acessem dados operacionais e memória sem interromper o desenvolvimento para configurar conexões. Além disso, a empresa detalhou novos recursos para trazer modelos de recuperação Voyage AI para o banco, incluindo Automated Embeddings no MongoDB Atlas com Voyage AI, a Atlas Embedding and Reranking API e o voyage-code-4.
#InteligenciaArtificial · #IA · #MongoDB · #AgentesDeIA · #MCP · #DesenvolvimentoDeSoftware · #LLM
Quinta · 06 ago
2026-08-06
1 matéria
IA
Pesquisa · IA
O Google atualizou a documentação do Chrome e informou que a IA local exige cerca de 20 GB de espaço livre para baixar e ativar modelos que rodam no próprio computador. O Gemini Nano, por exemplo, fica em torno de 4 GB após a instalação, mas o navegador precisa de uma reserva maior para concluir o processo. A mudança veio após reclamações de usuários sobre downloads automáticos em segundo plano, como o arquivo weights.bin, associado ao Gemini Nano.
Além do armazenamento, o Google diz que o recurso depende de hardware compatível, desempenho adequado e conexão sem limite de dados, e que a disponibilidade pode variar. Para devs e equipes de TI, o ponto prático é que a gestão deve ser feita pelo menu do Chrome (On-device AI), que remove os modelos ao desativar e evita novos downloads; e, para desenvolvedores, o Chrome também testa uma API de IA local para embeddings sem envio de dados à nuvem.
#IA local · #Chrome · #Google · #Gemini Nano · #on-device AI · #embeddings · #privacidade