A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
Agentes de IA já podem estar “no ar” e com serviço saudável, mas ainda assim a equipe precisa garantir que as respostas estejam melhorando. Ao conectar production traces, dados curados e avaliações, times conseguem identificar falhas, definir melhorias e demonstrar que a próxima versão funciona antes de chegar aos usuários.
O ciclo descrito passa por executar o agente, observar além da disponibilidade, curar exemplos de produção em datasets e suites de avaliação, melhorar o sistema e avaliar resultados antes e depois do deploy. A CoreWeave apresentou o CoreWeave Forge para integrar esse fluxo em um ambiente de desenvolvimento, reunindo ferramentas como Agent Lens, Notebooks, ARIA, Sandboxes e registros de modelos, experimentos e datasets para manter rastreabilidade da versão do modelo até os exemplos em produção.
A Spotify Ads apresentou no QCon AI uma plataforma multiagente que automatiza a criação de anúncios a partir de instruções do anunciante, reduzindo tarefas como copywriting e geração de conteúdo musical. O sistema roda em produção no Spotify Ads Manager e, desde o lançamento do ano passado, mais de 70% dos anúncios passaram a usar ferramentas de IA, com cerca de 20.000 criativos gerados para mais de 7.000 anunciantes.
A arquitetura inclui um gateway de LLM via Vertex AI e um orquestrador de agentes com agentes paralelos, como um para geração de scripts e outro para aplicar guardrails de políticas. A solução também extrai intenções do texto natural para definir segmentação e usa camadas de moderação e padronização do ambiente, com controle de dependências e monitoramento integrado para rodar a IA com baixa latência e segurança.
A Elastic está construindo e operando agentes de IA sobre sua base de dados no Elasticsearch, incluindo ferramentas para descoberta de ataques e chatbots corporativos. Em apresentações, a principal data scientist Susan Chang detalha como a empresa usa tracing para acompanhar dados e respostas, além de criar avaliações para estimar a qualidade e evitar regressões ao mudar os agentes.
Para isso, cada equipe monta seus próprios conjuntos de dados e avaliadores, mas a Elastic busca consolidar tudo em um framework compartilhado. No caso de segurança, a empresa cita métricas como precision e recall para alert IDs, além de scores de similaridade e factualidade ligados a taxonomias como MITRE; já nos chatbots, entram métricas como relevância e completude das respostas, com cenários de consulta e recuperação.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
Agentes de IA que “passam” em demos podem falhar quando chegam ao mundo real por causa de dados inconsistentes, fontes diferentes, mudanças frequentes de informação e desafios como permissões de sistema. Mesmo quando retrieval e RAG funcionam no ambiente controlado, o agente pode não ter o contexto de negócios necessário para tomar ações com base em informações atuais e confiáveis.
No dia 14 de outubro, Ravi Marwaha, COO e Chief Product & Technology Officer da Arango, vai explicar seis requisitos de dados para tirar agentes da fase de demonstração e preparar a arquitetura para produção. O conteúdo inclui exemplos sobre clientes que aparecem de formas diferentes em sistemas distintos, necessidade de entender “por que” uma decisão foi tomada e como manter governança e contexto unificado para reduzir latência, custos e trabalho manual.
Um especialista da OpenAI defendeu que agentes de IA em produção não devem ser avaliados apenas por respostas do modelo, mas sim por como o sistema registra e controla ações persistentes. Ele descreveu um tipo de falha em que a interação parece bem-sucedida para o usuário, porém o “registro durável” por trás da memória do agente fica incompleto, deixando lacunas no contexto das próximas etapas.
O foco do debate foi o “agent harness”: um conjunto de controles que define quem é o dono do estado, qual pipeline/workflow é a fonte da verdade e como a ordem de mutações é garantida. A proposta é que o modelo apenas “proponha”, enquanto o harness decide o que pode ser comprometido e a “receipt” comprove o que foi aprovado e executado na borda visível ao usuário.
Uma arquitetura “governance-first” para personalização em empresas propõe que regras de consentimento, fadiga, sensibilidade do canal, custo e explicabilidade façam parte do caminho de decisão antes de a recomendação ser entregue ao usuário. O modelo pode gerar candidatos, mas políticas selecionam como a inferência acontece e podem mostrar, suavizar, atrasar, suprimir ou usar fallback genérico.
O desenho também inclui memória de jornada entre sessões para que a mesma oferta mude conforme estágio, confiança e fadiga evoluem, além de explicações integradas ao contrato da API. A implementação de referência usa FastAPI, políticas externas em YAML, pontuação modular e escalonamento opcional para LLM, com o objetivo de tornar decisões rastreáveis e auditáveis no ambiente de produção.
O Google lançou o AX, um orquestrador open para executar tarefas agentic em escala. A plataforma cria sandboxes para isolar código não confiável, prepara workspaces com repositórios e dependências e aplica políticas de rede para controlar acesso a hosts e portas.
Na prática, o AX permite declarar workspaces e tarefas em arquivos como o task.yaml, executar comandos via ssh e gerenciar o ciclo de vida com suspend e resume. A proposta é suportar até bilhões de tarefas por cluster, usando um runtime chamado Agent Substrate para suspender agentes ociosos e retomar rapidamente sem “cold start”.
Agentes de IA da Perplexity ajudaram a construir o CobbleDB, um banco de dados key-value em Rust criado para substituir o DynamoDB. A empresa decidiu trocar o serviço depois de considerar que pagava caro e tinha pouca flexibilidade para controlar o desempenho de leitura no seu tráfego de busca.
Com apoio de centenas de agentes de programação ao longo do desenvolvimento, o CobbleDB passou a atender parte do tráfego de produção. A Perplexity reportou latência mediana de batch-read de 5,6 ms (contra 31,4 ms no DynamoDB) e p99 de 24,2 ms (antes 123 ms), além de estimar custo pelo menos 20% menor e planejar abrir o código em algum momento.
A Grab padronizou mais de 500 serviços internos de agentes de IA usando o LLM-Kit, um framework interno que já entrega o “agent loop” básico com avaliação, tracing, tratamento de segredos e conexões com tool-servers. Com isso, novos serviços passam a descobrir ferramentas em tempo de execução a partir de mais de 50 servidores MCP e acessam modelos por um gateway único, permitindo adicionar capacidades e provedores via registro ou configuração, sem redeploy.
Integrar um novo agente em produção na Grab passou a levar cerca de uma hora, antes eram duas semanas ou mais. A empresa atribui a economia principalmente ao “wrapper” de produção — segredos, tracing, service discovery e avaliação — e descreve um fluxo em que um engenheiro preenche um formulário e recebe um repositório GitLab com um serviço FastAPI pronto, módulos LangGraph, OpenTelemetry, Vault e endpoint de avaliação já no primeiro commit.
A pesquisa de tendências tecnológicas da Deloitte para 2026 aponta que 89% dos pilotos de agentes de IA não chegam à produção. Um levantamento da Teradata reforça o contraste: 78% das empresas têm pelo menos um piloto em execução, mas apenas 14% conseguiram escalar para uso em toda a organização.
O gargalo não estaria na capacidade dos modelos, já que os mesmos modelos alimentam pilotos e sistemas em produção, mas sim no que envolve o modelo: acesso a dados, avaliação, definição de responsabilidades e controle de custos. O levantamento também cita falhas recorrentes como expansão de escopo, falta de um “harness” de avaliação automatizada, ausência de um responsável operacional, custos que só aparecem em escala e barreiras de segurança e auditoria.
O GitHub Podcast reuniu Marlene Mhangami, GPS e o time do GitHub para destrinchar termos de IA que estão entrando no desenvolvimento de software, como loop engineering, Ralph loops, squads, harness engineering e hill climbing. A conversa também abordou conceitos como forward deployed engineer e as diferenças entre closed models, open weights e open source models.
Loop engineering, por exemplo, propõe criar sistemas repetíveis para agentes em vez de prompts pontuais, com validação e escalonamento quando algo “trava”. Já squads e fleets descrevem fluxos com múltiplos agentes em papéis diferentes ou em paralelo, enquanto harnesses são o conjunto de ferramentas, permissões, memória e orquestração que colocam o modelo para funcionar; hill climbing entra como a prática de melhorar agentes e harnesses com feedback e evals.
A OpenAI está testando com clientes enterprise um modelo de precificação baseado em resultados, em que a cobrança depende de o sistema de IA concluir o trabalho “certo”, e não apenas da quantidade de tokens ou compute consumidos. A empresa já iniciou os testes, segundo o relato do The Information, mas ainda não divulgou publicamente como define sucesso nem os detalhes do cálculo.
A mudança cria um desafio técnico para quem desenvolve agentes: é preciso determinar quando uma tarefa está realmente concluída, algo mais difícil do que contar tokens. Em cenários como agentes de código e automações com múltiplas etapas, uma execução pode passar em testes, falhar em produção ou completar 90% do fluxo sem ser considerada bem-sucedida, afetando diretamente o que vira cobrança e o risco financeiro do provedor.
Demos de agentes de IA podem impressionar quando a pergunta é clara, os documentos estão atualizados e as ferramentas respondem como esperado. Na prática, porém, surgem situações como registros incompletos, erros de ferramentas, mudanças de política na semana anterior e limites de capacidade — e é aí que o trabalho real começa.
O modelo é apenas uma parte do serviço; o “agent harness” é o restante, a camada que prepara entradas, verifica saídas e cria limites para reduzir falhas. Isso inclui contratos para ferramentas (com schemas, timeouts e estados de erro), separação entre ferramentas de leitura e escrita com validação e confirmação do usuário, além de permissões e rastreabilidade para que erros não se espalhem no ambiente de produção.
IA em tempo real em escala é mais difícil do que parece: pipelines que funcionam bem no desenvolvimento podem falhar em produção, com problemas como aumento de latência e queda de acurácia. Em um app de trading baseado em ML, a latência P99 disparou para 3 segundos quando o sistema chegou a cerca de 740 mil operações por segundo, apesar de a média parecer aceitável. O diagnóstico apontou que a lentidão não estava no modelo, mas em buscas e contenção sob carga, com o Postgres sendo pressionado no cenário específico.
A precisão também pode piorar quando os dados ficam desatualizados: perfis de usuários (wallet addresses) ultrapassaram uma SLA de 5 minutos por horas, embeddings ficaram obsoletos e métricas offline continuaram boas até a integração com dados online. Além disso, índices vetoriais precisam de manutenção, já que reembeddings degradam a qualidade do índice ao longo do tempo, reduzindo recall para 42% e elevando a latência de consulta. O texto ainda destaca que treinamento e serving devem ser separados quando possível e que retraining é inevitável, exigindo transição para evitar janelas de previsões defasadas.
A Synthesized anunciou o Test Data Agent, uma infraestrutura para criar dados de teste realistas e condições de sistema usadas na avaliação de agentes de IA antes da implantação em produção. O produto entrou em disponibilidade limitada para clientes existentes e parceiros do ecossistema, com disponibilidade geral prevista para o terceiro trimestre de 2026. A empresa também está testando a tecnologia com parceiros de design de um banco global de nível 1.
O Test Data Agent foi pensado para funcionar junto a frameworks de desenvolvimento, avaliação, testes e orquestração de agentes, sem focar apenas em pontuar a saída do modelo. Ele prepara dados, relações de negócio, permissões e estados de aplicações para verificar se o agente consegue concluir processos corporativos corretamente, incluindo cenários normais, exceções, falhas e adversariais, com possibilidade de gerar dados sintéticos e preservar regras e integridade referencial.
O projeto Kubeflow divulgou atualizações técnicas para fortalecer IA distribuída e computação de alto desempenho em Kubernetes, incluindo o lançamento do Kale 2.0 e melhorias no Kubeflow SDK. O Kale 2.0 converte notebooks Jupyter anotados em pipelines prontos para produção, com suporte à arquitetura Kubeflow Pipelines v2, sem exigir código do KFP SDK. O Kubeflow Trainer também foi ampliado para unificar treinamento distribuído de IA e workloads de HPC, com suporte a MPI e integração com o Flux Framework.
As mudanças incluem suporte nativo a Spark no SDK, permitindo executar Spark no Kubernetes sem configurar infraestrutura, além de uma interface Python unificada para processamento, orquestração de pipelines, treinamento distribuído e tuning de hiperparâmetros. O projeto também prepara recursos como instrumentação OpenTelemetry e tracking com MLflow para observabilidade, e avança rumo à graduação na CNCF, com novas versões em desenvolvimento para o Kubeflow Notebooks v2 e atualizações em componentes como Hub (antes Model Registry) e o LLMInferenceService no KServe.
Organizações de engenharia estão vendo métricas de “adoção” dispararem — como ativações de assentos e gasto com tokens — mas, ao observar reuniões e rotinas, quase nada muda no processo de desenvolvimento. O texto critica que indicadores de uso (tokens, commits, “% de código gerado por IA”) medem atividade, não melhoria real do trabalho. Também destaca que “adoção” pode significar desde uso pontual até mudanças permanentes de workflow, sendo que só a última tende a sobreviver a prazos e troca de pessoas.
A implicação para times dev é direta: dashboards podem virar incentivo para “jogar o jogo” da métrica, sem garantir qualidade, entrega ou aprendizado. Em vez de focar em licenças e volume de uso, a recomendação é avaliar o que quebra se a ferramenta sumir, e tratar prompts e fluxos como artefatos versionados e revisados no repositório — além de definir com clareza o que pode ser delegado a agentes com checagem leve e o que exige revisão mais cuidadosa.
Coinbase, Shopify e Ramp estão desenvolvendo agentes internos para apoiar o desenvolvimento de software, mas sem abandonar totalmente ferramentas comerciais. A Coinbase criou o Forge para transformar relatos de bugs em pull requests com integração a Slack, GitHub e Linear, incluindo validação e até build para revisão no mobile. A Shopify desenvolveu o River, que atua em um ambiente de engenharia reproduzível e já participa de 1 a cada 8 pull requests mescladas. A Ramp criou o Inspect, que executa em sandboxes com máquinas virtuais parecidas com o ambiente local e integra Datadog, Sentry e LaunchDarkly.
A tendência é que as empresas passem a “insourcer” o harness do agente — o ambiente de execução com contexto, permissões, orquestração de workflow e verificação — enquanto modelos de fundação continuam sendo fornecidos por players como Anthropic, OpenAI e Google. Na prática, isso muda o jogo para devs: o controle de custos, segurança e roteamento do modelo fica mais centralizado na plataforma, e os assistentes comerciais tendem a complementar fluxos interativos no editor/terminal.
O episódio do podcast da InfoQ, baseado no relatório anual Culture and Methods Trends 2026, reúne QCon e colaboradores para discutir como a adoção de IA está mudando a engenharia. O painel destaca a necessidade de avaliar maturidade, riscos e objetivos reais antes de integrar IA aos produtos e times. Também aponta transformações na estrutura das equipes, com papéis se misturando e colaboração precisando ser redesenhada para funcionar com times menores.
A matéria ressalta que o aumento de código gerado por IA exige processos novos para qualidade, gestão de carga cognitiva e responsabilização. Além disso, reforça que práticas ágeis como feedback rápido, observabilidade e entrega do valor certo continuam essenciais para evitar riscos “catastróficos” quando a base ágil é ignorada. Por fim, sugere que engenheiros devem atuar mais como “custodiadores”, criando guardrails e validando agentes de IA, enquanto a indústria enfrenta lacunas de accountability e impactos ambientais.
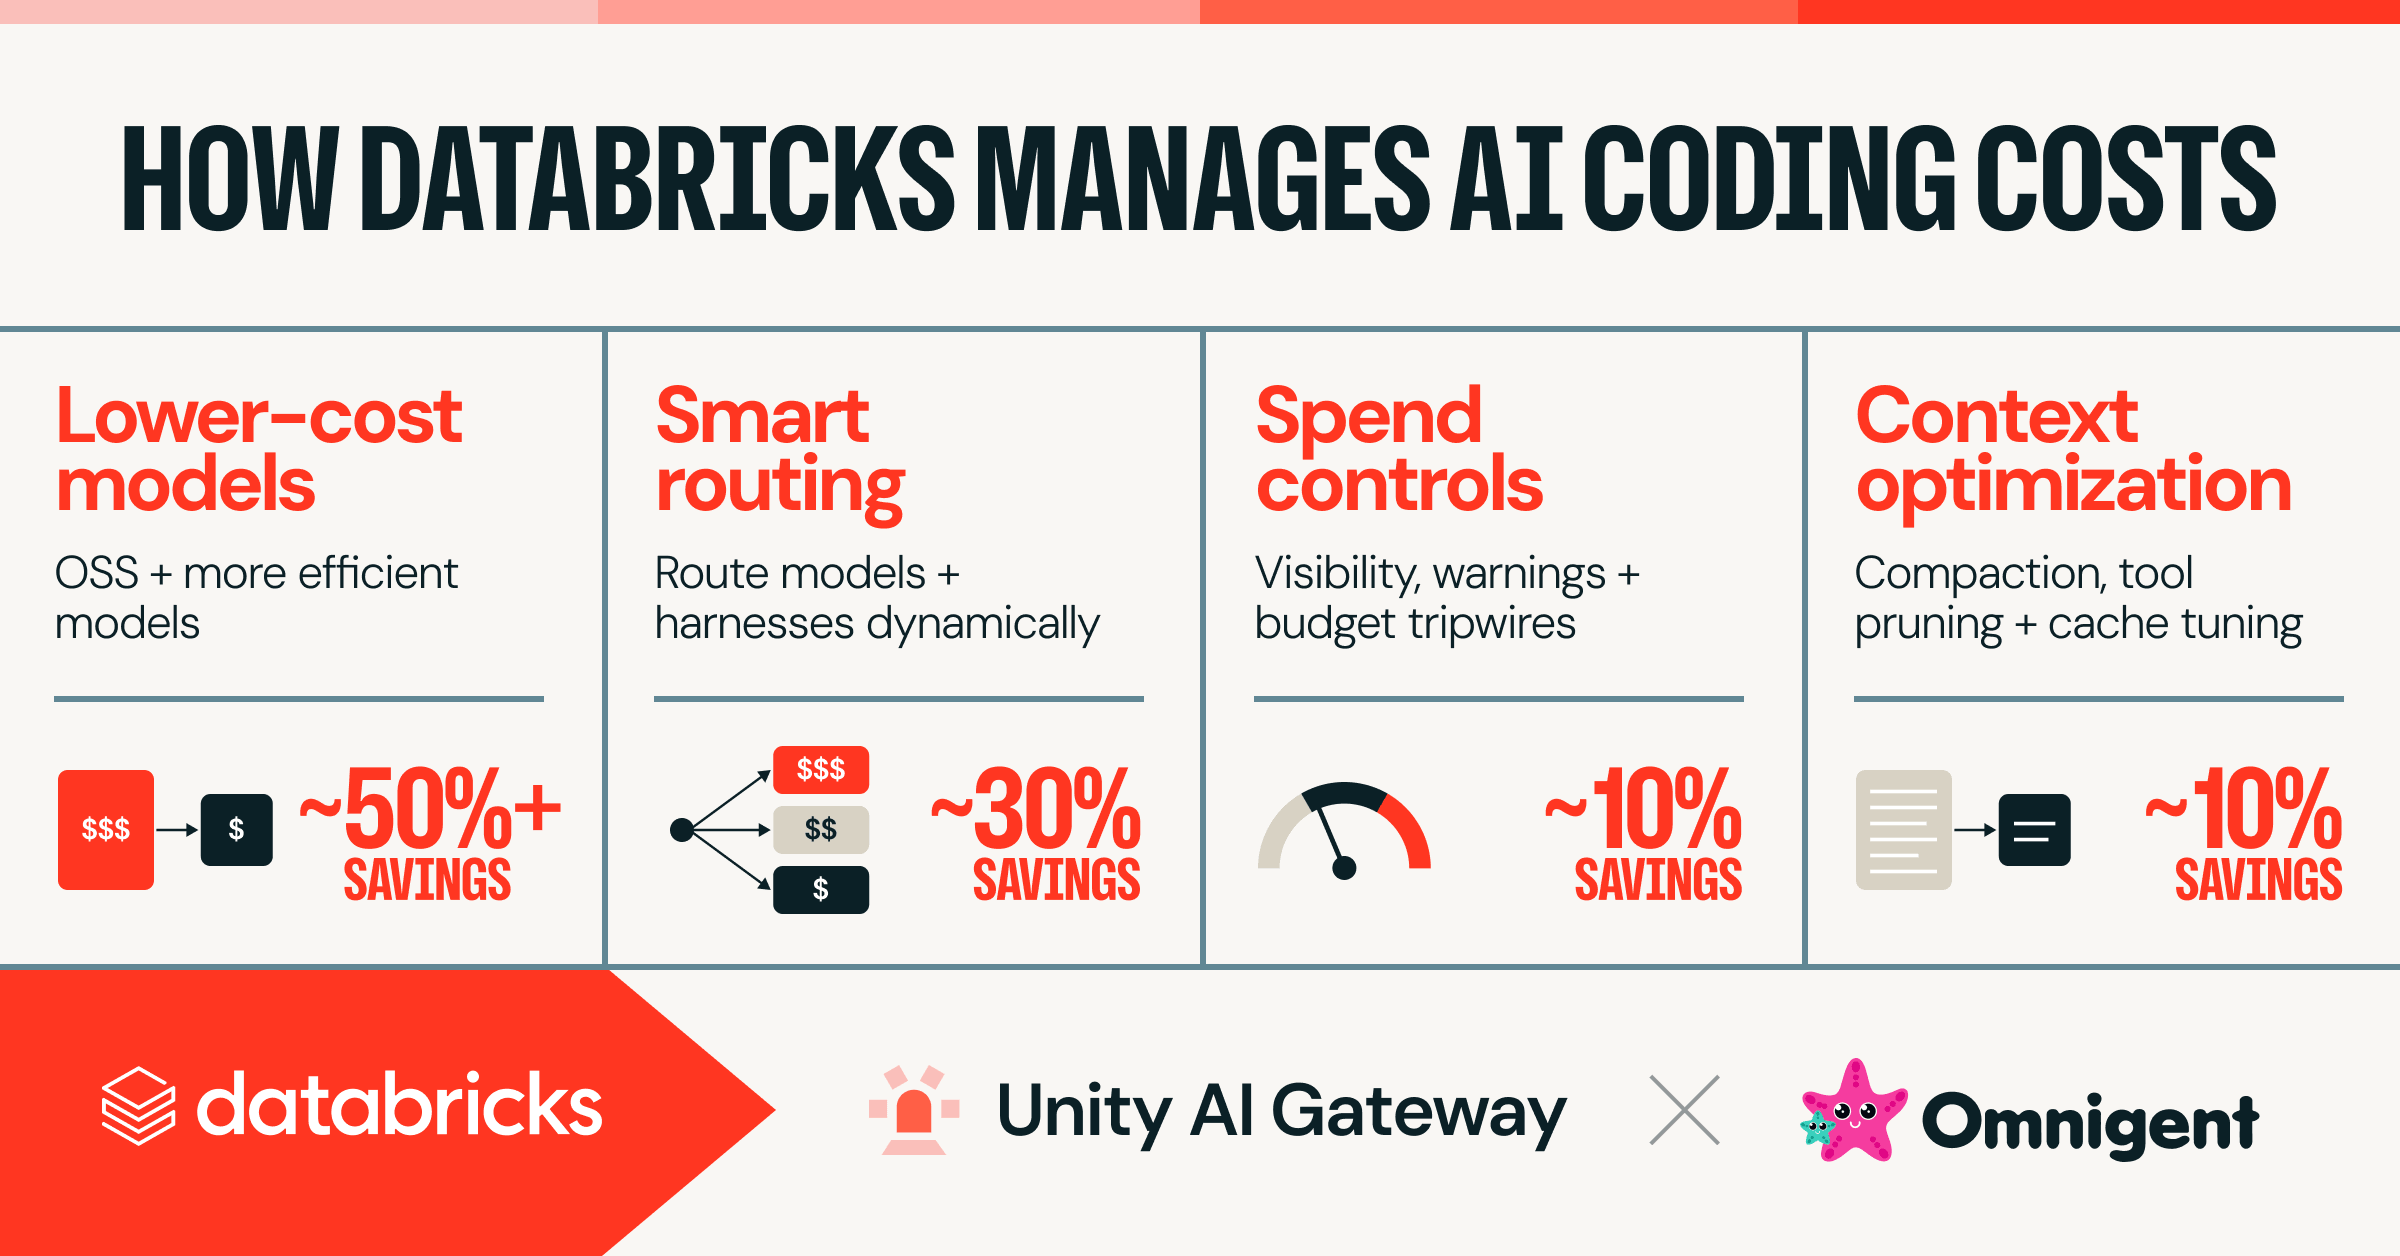
Ferramentas de “AI coding” estão acelerando o desenvolvimento: a Databricks afirma que a adoção de coding agentic melhorou métricas de velocidade e, em alguns times, elevou a produção em até uma ordem de grandeza. Porém, empresas que escalam o uso enfrentam custos que crescem rápido e podem superar a receita, levando a um desafio de manter a transformação em andamento sem inviabilizar o gasto.
A solução, segundo a Databricks, passa por uma “dupla missão”: dar acesso amplo com baixa fricção e manter o custo agregado por usuário em um envelope estável. Entre as estratégias estão trocar para modelos mais eficientes assim que saem, usar avaliações internas para evitar regressões de custo/qualidade (casos citados: Stripe e Databricks ao comparar versões), e adotar flexibilidade via harnesses ou meta-harness para reduzir lock-in e permitir migração para modelos mais baratos.
AMD, Supermicro e Spectro Cloud anunciaram o AMD Instinct Coder, uma solução “turnkey” para escalar o desenvolvimento de software com assistência de IA em ambientes corporativos. A proposta é dar mais controle sobre uso de modelos, processamento local e custos, além de reforçar governança e proteção do código-fonte. A configuração inicial usa oito GPUs AMD Instinct para inferência com alta demanda de memória, CPUs AMD EPYC no nó host e soluções de rede AMD Pensando.
Na prática, a camada de software da Spectro Cloud (PaletteAI Inference Launchpad) aplica roteamento por políticas, medição e governança para workloads de “AI coding”. Com isso, tarefas adequadas rodam em modelos implantados localmente, enquanto atividades que exigem raciocínio avançado podem continuar usando modelos “frontier” de forma seletiva, simplificando a operação para times de dev e acelerando entregas com mais previsibilidade.
Um artigo do SD Times defende que “AI testing” não descreve corretamente o trabalho necessário para sistemas baseados em IA. O texto argumenta que testes tradicionais assumem saídas determinísticas para as mesmas entradas, mas modelos e sistemas com recuperação (como RAG) podem variar respostas por mudanças no contexto e no conhecimento disponível. Como exemplo, o autor cita um assistente bancário que aprova reembolsos na terça-feira mesmo com a mesma suíte passando na segunda, porque a base recuperada muda sem alteração de código.
A proposta é tratar o tema como “AI Validation Engineering”, uma disciplina separada de QA determinístico, focada em consistência, grounding em fatos, calibração de confiança, detecção de drift e monitoramento de falhas que testes verdes não capturam. Para times dev, isso significa criar processos, métricas e papéis específicos para validar comportamento probabilístico e, no futuro, também ações de agentes autorizados — reduzindo surpresas em produção.
A Workhelix anunciou o Nucleus, uma plataforma SaaS voltada a medir continuamente o impacto de iniciativas de IA no negócio. O produto foi desenvolvido com base em pesquisas de especialistas de MIT, Stanford e Wharton e busca conectar “oportunidades” com “resultados”, reunindo dados de adoção e efeitos mensuráveis em um painel único.
Segundo a empresa, muitas organizações não conseguem responder se o uso de IA está gerando valor: elas veem atividade e acesso, mas não se a adoção está virando ganhos concretos. A Workhelix também cita que companhias podem deixar até 98% do valor potencial identificado “na mesa” e apresenta casos como uma empresa de infraestrutura em nuvem que gerou mais de US$ 85 mil e economizou mais de 800 horas com apenas seis usuários de IA, além de um aumento expressivo de tempo economizado em uma bolsa financeira.
Para o público tech, a mudança é direta: em vez de dashboards de uso, o Nucleus promete transformar dados de adoção em métricas de valor (em horas e dólares), ajudando times a priorizar onde investir e quais equipes realmente impulsionam resultados. Isso pode acelerar decisões de produto, orientar governança e tornar a estratégia de IA mais “auditável” para liderança e board.
A Doist, empresa por trás do Todoist e do Twist, diz que “menos IA pode entregar mais” ao desenhar automações com um fluxo híbrido: o modelo de linguagem entra apenas na fase de entender o pedido em linguagem natural e gerar um “manifest” de execução. Depois disso, a automação roda com código comum em gatilhos ou jobs recorrentes, buscando previsibilidade e consistência — já que modelos tendem a variar quando precisam executar repetidamente. A empresa afirma que vai levar o serviço Automations do beta fechado para lançamento em agosto ou início de setembro, e que a abordagem também reduz custos por evitar chamar modelos caros a cada execução.
A estratégia faz parte de uma filosofia de produto chamada “subtraction over addition”: facilitar o uso de IA não significa que toda ideia deve virar feature. A Doist também destaca que não quer depender de um único provedor de modelos, usando testes e avaliações para verificar se mudanças em modelos alteram o comportamento, além de controlar custos ao migrar de modelos maiores para menores sem perder o padrão de qualidade. Para times dev, o recado é claro: usar IA onde ela é melhor (interpretação/planejamento) e manter a execução determinística com software tradicional.
Uma equipe da Brex descreveu um padrão para construir workflows de IA que funcionam tanto em produção quanto em rotinas de avaliação (evals) offline. A ideia é separar a “lógica de orquestração” (passos, ordem e ramificações) do runtime: a mesma lógica roda sem mudanças em ambientes duráveis e também em loops leves para testar centenas de variações. O artigo explica por que engines focadas em execução durável (com persistência e replay) tornam as evals caras e lentas, enquanto harnesses leves não garantem resiliência para agentes longos.
Na prática, isso reduz bugs causados por divergência entre o que foi avaliado e o que vai para o ar—já que existe apenas uma versão da lógica. Para devs, a arquitetura precisa “forçar” o caminho correto (build falha se alguém escrever código não-agnóstico) e aceitar um custo: a orquestração perde acesso direto a recursos nativos de cada runtime, exigindo uma camada intermediária para novas capacidades. O resultado é um fluxo mais confiável para ajustar prompts e modelos sem sacrificar estabilidade em produção.
Agentes de IA voltados a coding já estão sendo usados para desenvolver software corporativo: eles leem repositórios, escrevem código, executam testes e até abrem pull requests, com revisão humana antes do deploy em algumas empresas. O ponto levantado é que, apesar do ganho de produtividade, a infraestrutura e a governança ainda não acompanham o uso mais autônomo — o que pode abrir brechas como vazamento de credenciais, acesso indevido a dados e risco de inserir segredos no código.
A recomendação é tratar agentes como “infra de produção”: limitar o acesso por padrão (especialmente rede e ferramentas), rodar em ambientes temporários e controlados em vez do laptop do dev, e delegar autoridade com identidade rastreável. Com least privilege, proxies e auditoria detalhada de prompts, chamadas a ferramentas e mudanças geradas, times conseguem reduzir o “raio de impacto” e aumentar a confiança no que vai para o ambiente real.
A Cloudflare anunciou o Cloudflare OS, um workspace de IA open source para todos os funcionários, com acesso a sistemas internos e ferramentas de automação, sem exigir nova infraestrutura ou meses de desenvolvimento sob medida. O projeto já está disponível no repositório público da empresa e, em breve, poderá ser implementado via Cloudflare ou com parceiros de implantação, como Presidio e Happy Cog.
A proposta inclui um acesso via navegador, agentes com permissões “zero trust” por padrão (via Cloudflare Access), conectores governados para controlar o que a IA pode ver e alterar e necessidade de aprovação humana quando necessário. Para devs e times de engenharia, a plataforma também promete integração com qualquer provedor de modelo via Cloudflare AI Gateway, com visibilidade de custos e limites por pessoa, time ou app, além de roteamento para modelos mais baratos em tarefas rotineiras.
Um artigo da The New Stack aponta que modelos como Claude, Gemini e GPT-5 conseguem executar tarefas do SDLC (planejamento, coding, testes, validação e documentação), mas “quase nenhum” deveria ser usado para tudo. A discussão migra de preocupações de segurança e privacidade para um risco mais estrutural: quando a IA chega à produção, o problema tende a ser a arquitetura do sistema de entrega, não o texto gerado pelo modelo.
A proposta é tratar a entrega de software com IA como uma “cadeia de suprimentos” (supply chain), com agentes e modelos especializados por etapa — por exemplo, um para unit tests, outro para code review, outro para validação e conformidade — orquestrados com governança e visibilidade. Para times dev, isso muda a prática: em vez de um único modelo “faz-tudo”, a eficiência, o custo e o controle passam a depender de orquestração, especialização e políticas aplicadas ao pipeline.
Líderes de engenharia de software estão sendo pressionados a criar aplicações e agentes com IA, e a matéria traz um guia para escalar iniciativas com segurança. O texto explica o “espectro” de complexidade da AI engineering e diferencia aplicações com IA — que seguem fluxos definidos e chamam modelos com entradas/saídas previsíveis — de agentes, que controlam o fluxo, planejam, escolhem ferramentas e tomam decisões em múltiplas etapas. Também destaca que agentes tendem a exigir mais testes, governança e controles de risco, além de supervisão proporcional ao nível de autonomia.
O artigo orienta como montar e capacitar equipes, incluindo planejamento de workforce, identificação de gaps de habilidades e entendimento de custos (como tokens e computação), além de critérios de vendor e decisões build-versus-buy. Para escalar na empresa, recomenda medir impacto no dia a dia (e não só quantidade de modelos/agents), começar por problemas de negócio recorrentes e reduzir atrito integrando a IA às ferramentas existentes, construindo confiança com validações, indicadores e opções de supervisão humana.