A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A Elastic está construindo e operando agentes de IA sobre sua base de dados no Elasticsearch, incluindo ferramentas para descoberta de ataques e chatbots corporativos. Em apresentações, a principal data scientist Susan Chang detalha como a empresa usa tracing para acompanhar dados e respostas, além de criar avaliações para estimar a qualidade e evitar regressões ao mudar os agentes.
Para isso, cada equipe monta seus próprios conjuntos de dados e avaliadores, mas a Elastic busca consolidar tudo em um framework compartilhado. No caso de segurança, a empresa cita métricas como precision e recall para alert IDs, além de scores de similaridade e factualidade ligados a taxonomias como MITRE; já nos chatbots, entram métricas como relevância e completude das respostas, com cenários de consulta e recuperação.
Nesta quarta-feira (23), desenvolvedoras de inteligência artificial alertaram o Conselho de Segurança da ONU sobre os riscos que a tecnologia representa para a humanidade. Dario Amodei, CEO da Anthropic, e Sam Altman, da OpenAI, defenderam um apelo por cooperação global.
O debate coloca a segurança internacional no centro da discussão sobre IA, com a tecnologia sendo tratada como um tema que exige coordenação entre países. A iniciativa reforça a pressão por governança e respostas conjuntas diante dos impactos da IA.
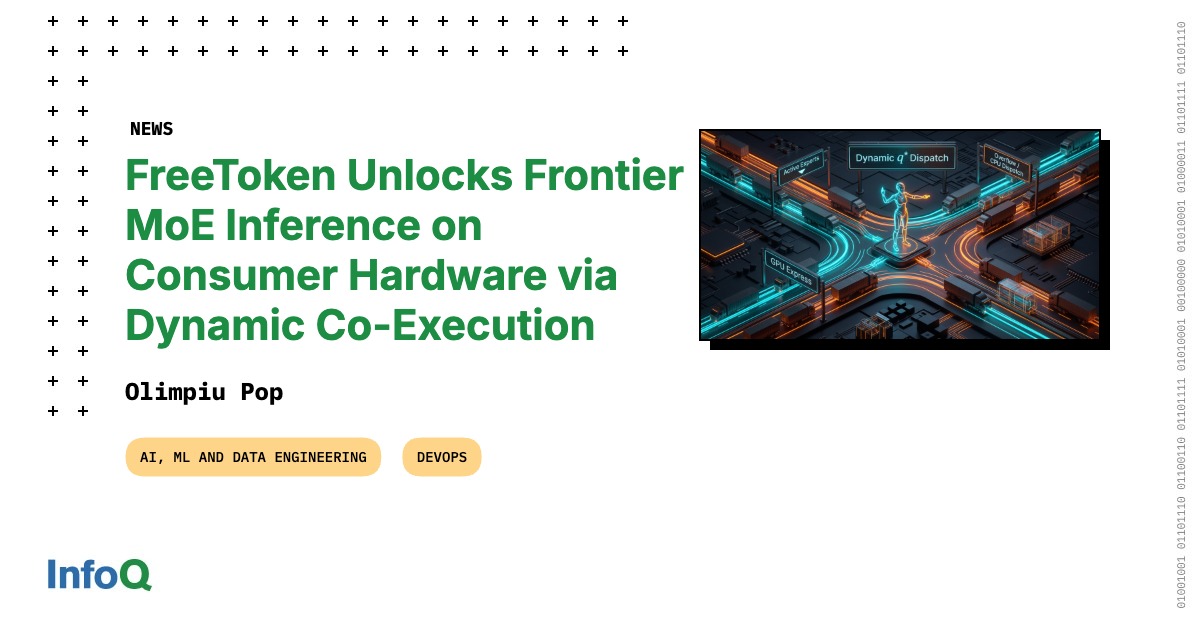
O projeto FreeToken, open-source, foi apresentado por pesquisadores da UC Berkeley e do MIT como uma engine de inferência para aproximar modelos MoE de ponta do uso em hardware consumidor. A proposta trata o PC do usuário como uma “fábrica” de computação elástica e heterogênea, em vez de apenas um nó de datacenter com limitações.
Para reduzir gargalos de decodificação em MoE, o FreeToken substitui o offloading estático por uma política dinâmica (q*) que divide a computação entre CPU e GPU conforme a taxa de interconexão. O sistema usa um formato de pesos (FTW) e double buffering para sobrepor streaming via PCIe com camadas ativas, além de gerenciar VRAM em tempo de execução sem recarregar o modelo, com ganhos reportados como ~39 tokens/s no Qwen3.6-35B em um RTX 4060 de 8GB.
Muita gente monta sistemas RAG de forma “over-engineered”, indo direto para embeddings, bases vetoriais e pipelines de reranking, mas o texto defende que o ponto de partida pode ser mais direto. A recomendação é escolher a abordagem conforme necessidades como atualização dos dados, características do corpus, padrões de consulta, escala de uso e capacidade do time.
O guia sugere começar pelo “MVP” com busca full-text usando BM25 (como Elasticsearch ou Postgres full-text search) quando as consultas são mais baseadas em palavras-chave e a prioridade é evitar complexidade de ML. Para consultas conversacionais ou com vocabulário desalinhado, a proposta é usar um LLM para reescrever a pergunta em uma busca keyword, e, quando fizer sentido, evoluir para busca híbrida combinando BM25 para candidatos e embeddings para reranking.