A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
O podcast “The Architect's Podcast” reuniu Michael Stiefel e Joy Ebertz para discutir como a inteligência artificial está mudando o trabalho de arquitetos e desenvolvedores. O papo destaca que, com a IA assumindo mais tarefas de codificação, a definição de requisitos precisa ser precisa e pouco ambígua, além de exigir testes escritos de forma clara.
A conversa também aponta desafios em sistemas legados, onde pode ser difícil recuperar requisitos reais e decidir entre mudanças incrementais ou regeneração do código. Ebertz ainda descreve que o uso de IA na prática varia de “vibe coding” para ferramentas internas até um modelo de pair programming supervisionado, reforçando a necessidade de entender restrições e suposições para validar o resultado.
O GitLab lançou a versão 19.4 da sua plataforma DevSecOps com novidades no GitLab Duo CLI, incluindo um modo goal-driven e mais ferramentas via Model Context Protocol (MCP). O novo comando /goal, em beta público, aceita um objetivo em linguagem natural e continua trabalhando até concluir a tarefa ou atingir um limite de iterações, mantendo ações dentro das permissões e regras de aprovação do projeto.
A atualização também adiciona modelos hospedados open-weight (Kimi K3, MiniMax M3 e GLM 5.3) ao Duo Agent Platform e amplia os controles para gastos com IA. Os créditos passam a ter exportação com detalhamento por evento e uma página de configurações permite definir limites por usuário, com alertas para gestores quando o uso sob demanda chega a 50% ou 80% do teto mensal.
O Xcode 27.2 passa a usar um novo formato de arquivo em JSON para a configuração de projetos, substituindo o modelo tradicional baseado em property-list. A mudança foi pensada para melhorar a legibilidade, simplificar a manutenção e tornar a configuração mais fácil de ser entendida e modificada por agentes de coding com IA.
O formato open source xcode-project-format também ajuda a reduzir conflitos de merge, ao oferecer uma representação mais estável e previsível para comparação no repositório. A Apple ainda disponibilizou um pacote Swift para codificar e decodificar o novo formato, e a migração substitui o project.pbxproj por project.xcproj, mantendo o modelo subjacente — com a ressalva de verificar compatibilidade de ferramentas como fastlane, CocoaPods e Tuist.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
Claude Code consegue reconstituir a arquitetura de um app sem histórico de conversa ao consultar registros via MCP. Em uma sessão “do zero”, o agente abriu um workspace vazio e pediu para adicionar filtros por status e responsável na console de suporte do escopo bit-oss.support, chamando read_scope e read_components para recuperar componentes e dependências.
Com as informações, o Claude Code importou React, serviço Express com MongoDB e a entidade compartilhada de tickets, implementou a filtragem no cliente e validou com 41 testes passando, incluindo nove novos testes. O experimento também mostrou limites: os registros ajudam a identificar contratos compartilhados, mas não garantem que rotas e integrações reais permaneçam compatíveis sem checagens e testes adicionais.
O Anthropic lançou o OSS Scanner, parte da sua “Cyber Mission”, e o sistema baseado no Claude identificou mais de 29.000 possíveis vulnerabilidades em projetos open source amplamente usados. Em seis meses, as varreduras geraram 29.000 candidatos, mas o pipeline de revisão humana conseguiu processar cerca de 6.000.
Até 2 de outubro, as firmas externas confirmaram 5.674 das 6.123 descobertas revisadas como válidas, porém apenas 516 vulnerabilidades tinham sido corrigidas no código. A empresa também descreve um “fast-track” opcional: relatórios enviados aos mantenedores sem validação prévia pela Anthropic, com reprodutor e, quando possível, patch sugerido pelo modelo.
A Gremlin anunciou a disponibilidade geral do Foresight AI, um produto com agentes que analisa serviços em busca de falhas, recomenda mudanças e reexecuta testes para verificar se a correção realmente funciona. O recurso funciona como um add-on da plataforma Gremlin, que também permite rodar experimentos planejados, controlar o “blast radius” e usar testes automatizados para manter correções eficazes ao longo do tempo.
O Foresight AI organiza o trabalho em quatro papéis de agentes: um Analyst coleta dados e sugere testes, um Tester agenda e executa, um Operator interpreta falhas e propõe remediações, e um Technical Program Manager acompanha cobertura, riscos e compromissos entre equipes, gerando relatórios e atualizações no Slack. As recomendações se baseiam no Failure Atlas da Gremlin, e o produto mantém um “loop” de validação fechada: ele não executa testes nem aplica remediações sem aprovação, preservando a responsabilidade humana enquanto automatiza análise e repetição.
Agentes de IA já podem estar “no ar” e com serviço saudável, mas ainda assim a equipe precisa garantir que as respostas estejam melhorando. Ao conectar production traces, dados curados e avaliações, times conseguem identificar falhas, definir melhorias e demonstrar que a próxima versão funciona antes de chegar aos usuários.
O ciclo descrito passa por executar o agente, observar além da disponibilidade, curar exemplos de produção em datasets e suites de avaliação, melhorar o sistema e avaliar resultados antes e depois do deploy. A CoreWeave apresentou o CoreWeave Forge para integrar esse fluxo em um ambiente de desenvolvimento, reunindo ferramentas como Agent Lens, Notebooks, ARIA, Sandboxes e registros de modelos, experimentos e datasets para manter rastreabilidade da versão do modelo até os exemplos em produção.
A Microsoft lançou o Microsoft-Decision-1 no Foundry, três dias depois de a OpenAI abrir sua Decisions API para beta público. O modelo foi “post-trained” com base no Alibaba Qwen3.5-9B, com a empresa dizendo que pretende fazer um rebasing para seus próprios modelos MAI e também para a OpenAI. O preço informado é de US$ 0,042 por milhão de tokens de entrada, com saída gratuita, e o modelo aceita até 32.768 tokens de texto, retornando JSON.
A Microsoft afirma que o Decision-1 é usado internamente em tarefas como triagem de feedback de jogadores no Xbox Research, avaliação de respostas do Copilot e apoio a engenheiros em incidentes ao puxar contexto. A empresa também destaca o foco em decisões em “ambiente seguro e confiável”, mas não anunciou suporte a imagens e orienta clientes a validarem a calibração das probabilidades nos próprios dados, especialmente sob entradas adversariais.
O Kubernetes está mudando a forma de lidar com limitações de recursos para workloads de IA na borda, com destaque para o recurso node swap e para a migração do Linux cgroup v2. A equipe do Kubernetes aponta que a memória costuma ser o primeiro gargalo em clusters, e que a onda de workloads agentic pode piorar esse cenário.
No Kubernetes v1.34, o node swap chegou à disponibilidade geral e pode atuar como “shock absorber” durante picos de tráfego, com ganhos de densidade reportados de até 3x em cenários específicos com NVMe SSDs. Ao mesmo tempo, o kubelet passa a recusar iniciar em nós com cgroup v1 por padrão a partir do v1.35, e a orientação é migrar os nós para o cgroup v2 antes de atualizar.
O Google lançou o Android Bench 2.0, uma atualização do framework de benchmark para avaliar modelos de IA e agentes em tarefas de desenvolvimento para Android. A versão inclui long-horizon tasks (LHTs), que podem levar “vários dias ou até uma semana” para um engenheiro concluir, além de avaliação agentic com agentes de provedores de modelos.
O Android Bench 2.0 também muda a forma de medir desempenho: sai o pass/fail binário e entra um sistema de pontuação mais detalhado, combinando fatores como funcionalidade, fidelidade visual e prevenção de regressões, com penalidades objetivas por desvios das instruções. No dashboard, modelos como Gemini 3.8 Flash, OpenAI GPT-6, Anthropic Fable 5.1 e Qwen 3.8 Max aparecem no ranking, com o Claude Opus 5.5 liderando entre as LHTs (32% de pass rate), seguido pelo GPT 6 Astra (28%).
A equipe de observabilidade da Netflix descreveu como lida com a complexidade de monitorar desempenho e qualidade de experiência em escala global. Durante eventos como a luta Jake Paul x Mike Tyson, a empresa cita picos de 65 milhões de streams simultâneos e mais de 2 bilhões de requisições por dia, além de cerca de 38 milhões de eventos de logging em tempo real por segundo.
A proposta é evoluir de um modelo reativo de monitoramento para uma “engine” proativa de insights, conectando dados do dispositivo do usuário até serviços e dependências no backend. O objetivo é detectar problemas automaticamente, priorizar impactos nos usuários, direcionar para as equipes certas e, quando possível, identificar causa raiz e até prever falhas antes de afetarem a experiência.
A Spotify Ads apresentou no QCon AI uma plataforma multiagente que automatiza a criação de anúncios a partir de instruções do anunciante, reduzindo tarefas como copywriting e geração de conteúdo musical. O sistema roda em produção no Spotify Ads Manager e, desde o lançamento do ano passado, mais de 70% dos anúncios passaram a usar ferramentas de IA, com cerca de 20.000 criativos gerados para mais de 7.000 anunciantes.
A arquitetura inclui um gateway de LLM via Vertex AI e um orquestrador de agentes com agentes paralelos, como um para geração de scripts e outro para aplicar guardrails de políticas. A solução também extrai intenções do texto natural para definir segmentação e usa camadas de moderação e padronização do ambiente, com controle de dependências e monitoramento integrado para rodar a IA com baixa latência e segurança.
APIs compatíveis com OpenAI estão sendo usadas para permitir conversas multi-turn com agentes, mas escalar esse tipo de fluxo exige cuidados com estado e roteamento entre réplicas. O texto descreve um endpoint mínimo compatível com /v1/chat/completions que falha de forma “silenciosa” quando o tráfego é distribuído: o modelo pode responder sem o contexto correto se cada turno cair em uma máquina que não tem o histórico da conversa.
Para resolver, a proposta retoma princípios de microservices e padrões como bulkheads, movendo o estado da conversa para um armazenamento compartilhado para que qualquer réplica possa atender qualquer turno. A discussão também destaca como “agent traffic” difere do tráfego web por ser mais longo, mais imprevisível em tool calls e mais sujeito a rajadas, exigindo desenho de API que absorva essas características.
Durante a “Birthday Week”, a Cloudflare anunciou a Clef, uma linha de modelos open-weight voltados a escolher entre opções pré-definidas em vez de gerar texto. Foram lançados modelos com 9B e 27B parâmetros, incluindo uma Clef multimodal de 27B que recebe um estado e um esquema de perguntas tipadas e devolve decisões com probabilidades para cada opção permitida.
A proposta é permitir que agentes usem o resultado para decidir como agir, como roteamento de solicitações de suporte, escalonamento ou adiamento para um humano. A empresa também lançou a Clef-Flash (9B), com latência mediana de 38,8 ms nos benchmarks da Cloudflare, e disponibilizou a tecnologia via Workers AI e pesos para download no Hugging Face, além de planejar fine-tuning para casos como triagem de suporte e classificação de bots.
A OpenAI abriu sua Decisions API para beta público e adicionou entradas de imagem para permitir decisões rápidas a partir de conteúdo visual. A API também passou a ser cobrada em $0,10 por 1M de tokens de entrada, sem taxa por tokens de saída e sem cobrança por cache reads ou writes.
Rodando no GPT-6 Luna, a versão beta permite que desenvolvedores convertam texto ou imagens em três tipos de saídas estruturadas: predicates (probabilidade), choices (opções predefinidas) e scores (faixa numérica). A OpenAI mostra usos como decidir, a partir de frames, se um carro deve trocar de faixa ou seguir em frente, e também integrações com um robô bípede via GPT-Live para comandos como “follow the apple”.
O projeto de documentação Docsy, criado pela Google e usado por grandes iniciativas de cloud native, está migrando para a Linux Foundation. O anúncio foi feito por Erin McKean, da Google e membro do comitê do Docsy, em uma keynote no Open Source Summit Europe, em Praga.
O Docsy é um tema open source para o gerador de sites estáticos Hugo e já era adotado por cerca de 2.200 projetos até o fim de 2024, incluindo Kubernetes, OpenTelemetry, gRPC e Jaeger. A iniciativa passou a adaptar a saída para ferramentas de IA, como a geração de cópias em Markdown e um arquivo llms.txt (a partir da versão 0.15.0), além de recursos experimentais para orientar agentes, como diretivas ocultas apontando para o índice do llms.txt. A roadmap inclui também “AF” (agent-friendly documentation scores) para medir o quanto a documentação é fácil de encontrar, navegar e consumir por agentes.
A reinvenção do time de desenvolvimento ganhou força com a adoção de coding agents e a ideia de que o trabalho pode sair do IDE e passar a ser guiado por specs e tickets. A apresentação cita as “oito etapas de agentic coding” ligadas a Steve Yegge e o avanço de plataformas de orquestração como o Gastown, além do crescimento rápido do uso de agentes no Cursor.
O cenário descrito aponta que, no Cursor, há mais requisições de agentes do que aceites de abas, com agent-driven development virando a maior parte do trabalho. A fala também reforça que, apesar da promessa de velocidade, a equipe precisa ajustar processos para manter segurança e garantir que “pessoas importam” enquanto agentes escrevem testes, fazem deploy e monitoram em produção.
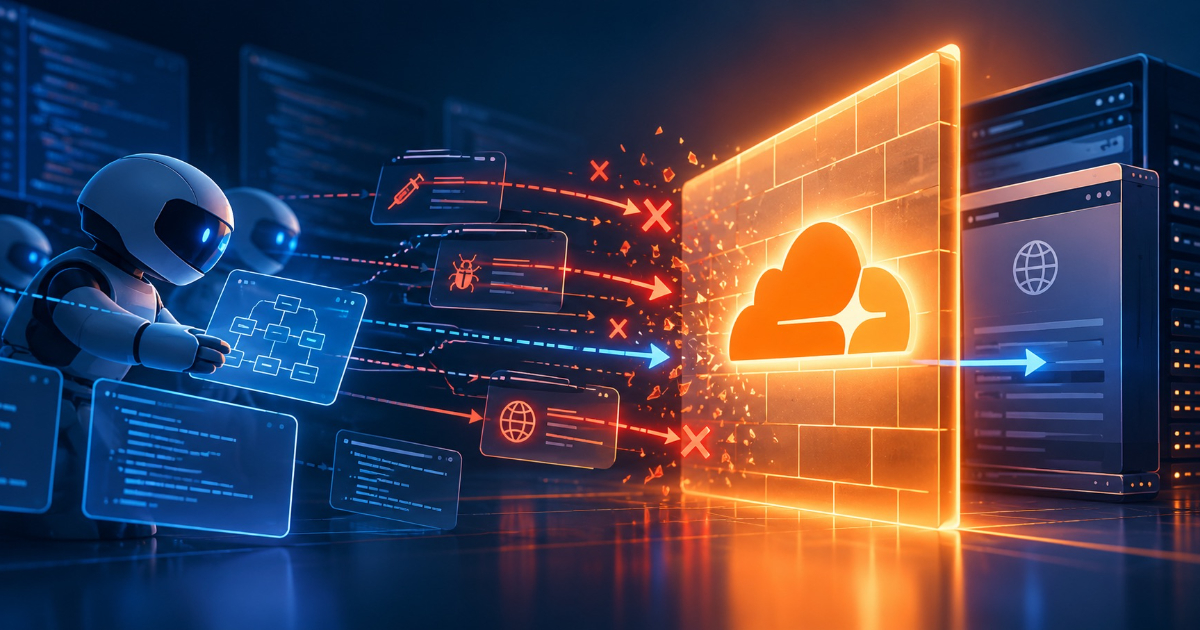
Modelos de IA de ponta foram colocados por a Cloudflare dentro de um harness de testes controlado para avaliar e fortalecer o Web Application Firewall (WAF). A equipe usou ataques que o WAF já bloqueava como ponto de partida e fez os modelos gerarem variações, refinando encoding, posicionamento e entrega das requisições com base nas respostas anteriores.
Em 45 cenários, o sistema registrou 1.107 tentativas e deixou 49 achados após triagem humana. O experimento resultou em três mudanças no Managed Ruleset, incluindo duas novas detecções para SSRF (SSRF - Obfuscated Host e SSRF - Restricted Protocol) e uma melhoria na regra SSRF - Cloud, mostrando como o loop de feedback e a validação final ajudam a transformar exploração probabilística em evidência para ajustes de segurança.
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
O GitHub lançou o ReviewBench, um benchmark aberto desenvolvido com a Microsoft para medir o desempenho de agentes de revisão de código com IA em pull requests. Na primeira lista de resultados, o GitHub Copilot Code Review lidera em configuração “Balanced”, com 40,1% de grounded F1, que combina precisão e revocação contra achados conhecidos do benchmark.
O ReviewBench avaliou 219 pull requests de 187 repositórios públicos, cobrindo 19 linguagens, com um conjunto de referência criado a partir de comentários humanos, mudanças posteriores dos autores, ferramentas de análise estática e revisões feitas por LLMs. A própria GitHub ressalta limitações: os testes iniciais foram executados pelos times dos fornecedores sem verificação externa e as medições foram feitas em datas diferentes, então os resultados podem não refletir versões atuais ou o desempenho em códigos de empresas.
A Elastic está construindo e operando agentes de IA sobre sua base de dados no Elasticsearch, incluindo ferramentas para descoberta de ataques e chatbots corporativos. Em apresentações, a principal data scientist Susan Chang detalha como a empresa usa tracing para acompanhar dados e respostas, além de criar avaliações para estimar a qualidade e evitar regressões ao mudar os agentes.
Para isso, cada equipe monta seus próprios conjuntos de dados e avaliadores, mas a Elastic busca consolidar tudo em um framework compartilhado. No caso de segurança, a empresa cita métricas como precision e recall para alert IDs, além de scores de similaridade e factualidade ligados a taxonomias como MITRE; já nos chatbots, entram métricas como relevância e completude das respostas, com cenários de consulta e recuperação.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
As bibliotecas AndroidX Security State e Security State Provider, da Google, permitem que apps verifiquem o status de segurança e nível de patch em nível de componente, em vez de depender de uma única data de patch do dispositivo. Com isso, desenvolvedores e empresas conseguem avaliar com mais granularidade o quão atualizado um Android está e quais remediações estão disponíveis.
A biblioteca define três níveis de patch: Device SPL (instalado no sistema em execução, sem necessidade de rede), Published SPL (o mais recente publicado pela Google para um componente) e Available SPL (o que está disponível para download e instalação no dispositivo). Funções como queryAllAvailableUpdates(), fetchAvailableSecurityPatchLevel(), areCvesPatched() e isDeviceFullyUpdated() ajudam a identificar atualizações pendentes e checar se CVEs específicas foram corrigidas, enquanto a Security State Provider padroniza para OEMs como clientes de atualização informam apps sobre disponibilidade de updates.
Times como os da Anthropic e da Linear relataram que agentes de IA aumentaram drasticamente o volume de jobs no CI e fizeram as suítes de testes crescerem rapidamente. A Anthropic atribuiu o ganho de eficiência a uma abordagem de test impact analysis, rodando apenas testes afetados por mudanças; a Linear, por sua vez, reestruturou o pipeline para acompanhar o crescimento da demanda. Já o CEO da Depot defendeu que o futuro passa por agentes validando código para manter a confiança durante o trabalho.
O ponto central é que tornar o CI mais rápido não resolve o problema de verificação em sistemas distribuídos, porque o pipeline normalmente valida um repositório, não o comportamento entre serviços. A análise argumenta que a checagem precisa “fechar o loop” contra o sistema real antes do PR, com agentes executando e testando em ambientes que simulem mais fielmente o contexto, evitando que falhas apareçam apenas quando a mudança chega ao staging e cruza fronteiras entre serviços.
A AWS abriu o código do Pizza Bot, uma aplicação self-hosted que permite que agentes de IA executem tarefas em segundo plano e devolvam os resultados em uma interface estilo caixa de entrada. O sistema organiza fluxos longos com threads de trabalho, suporta execução agendada ou acionada por webhook e permite delegar tarefas a workers especializados, pedindo aprovação humana quando ações forem consideradas sensíveis.
Com licença Apache 2.0, o Pizza Bot usa arquitetura cliente-servidor e mantém estado do agente, checkpoints, anexos e logs localmente em uma pasta controlada pelo usuário. O projeto foi desenhado para enviar dados apenas ao provedor de modelo configurado e para MCP servers explicitamente habilitados, com credenciais armazenadas no secret store do sistema, reduzindo a necessidade de monitoramento contínuo durante a execução.
A Archestra lançou o OpenAPPA, um motor de segurança open-source para impedir exfiltração de dados causada por prompt injection ou alucinação de modelos. O sistema roda fora do loop de prompt e execução do agente e usa uma configuração appa.toml para definir fontes de dados, audiências, níveis de confiança e autoridades, com regras determinísticas de aplicação.
Em benchmarks como Bench-Corp (20 fluxos corporativos) e AgentThreatBench, o OpenAPPA reportou 0% de ataques bem-sucedidos, mantendo 89% de conclusão de tarefas. A equipe também aponta que abordagens estocásticas baseadas em “modelo-juiz” tendem a falhar por não rastrear o fluxo de dados entre tool calls, e descreve mecanismos de recuperação, como sanitização, aprovação por autoridades e Child Branches descartáveis para isolar dados não confiáveis.
A DoorDash criou a equipe “GenAI Platform” para viabilizar projetos com inteligência artificial generativa e compartilhou, em uma apresentação, como estruturou a plataforma desde 2023. O time relata que começou após o “momento ChatGPT” (nov/22), decidiu usar OpenAI e focou em princípios como ser “customer obsessed”, priorizar APIs/SDKs e construir fluxos ponta a ponta, e não apenas notebooks ou acesso a GPUs.
A estratégia também evitou apostar em chatbots e direcionou o trabalho para impacto no negócio, com casos ligados a automação, recomendações e personalização. A plataforma já tem mais de 5.000 usuários internos e registra 45 novos cadastros por dia, com cerca de 40% do público formado por não engenheiros usando APIs, o que levou o time a reforçar governança e accountability na adoção.
A GitHub afirma que a inteligência artificial está mudando o que significa se destacar na carreira de desenvolvedor. Escrever código continua essencial, mas cresce a necessidade de saber direcionar a IA, avaliar a saída gerada e tomar decisões técnicas com base em tradeoffs.
A orientação inclui aprender a coordenar agentes de IA, revisar respostas em vez de aceitar a primeira versão e usar modelos para acelerar partes da implementação. A GitHub também destaca que o ganho de tempo deve ser usado para resolver problemas maiores, como entender necessidades do cliente e validar decisões de arquitetura.