22 resultados para Qwen
Domingo · 11 out
2026-10-11
2 matérias
Eng · Dev com IA
Destaque

Engenharia · Software com IA
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
#InteligenciaArtificial · #IA · #LLM · #ModelosDeLinguagem · #ContextManagement · #ComputeEfficiency · #PesquisaEmIA
IA

Pesquisa · IA
O The Verge descreve a experiência de usar IA local com o Hermes, um app de agente de IA self-hosted para macOS, Windows e Linux. A instalação foi feita no Mac Studio com M5 Ultra, usando o modelo aberto Qwen 3.8 Flash Next, de 125 bilhões de parâmetros, com cerca de 105GB, e com foco em rodar modelos sem depender de serviços em nuvem.
Entre os testes, o Hermes executa tarefas como um briefing diário que lê e-mail e calendário, organiza a biblioteca do Steam por gêneros e categorias e faz análises de registros financeiros e comparações em planilhas. Para ações no computador, o agente precisa de permissões e, no caso do Steam, exige uma chave de API que pode ser revogada depois, mantendo dados sensíveis fora da nuvem.
#InteligenciaArtificial · #IAlocal · #LLM · #AgentesDeIA · #Qwen · #Hermes · #Privacidade
Sábado · 10 out
2026-10-10
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A Microsoft lançou o Microsoft-Decision-1 no Foundry, três dias depois de a OpenAI abrir sua Decisions API para beta público. O modelo foi “post-trained” com base no Alibaba Qwen3.5-9B, com a empresa dizendo que pretende fazer um rebasing para seus próprios modelos MAI e também para a OpenAI. O preço informado é de US$ 0,042 por milhão de tokens de entrada, com saída gratuita, e o modelo aceita até 32.768 tokens de texto, retornando JSON.
A Microsoft afirma que o Decision-1 é usado internamente em tarefas como triagem de feedback de jogadores no Xbox Research, avaliação de respostas do Copilot e apoio a engenheiros em incidentes ao puxar contexto. A empresa também destaca o foco em decisões em “ambiente seguro e confiável”, mas não anunciou suporte a imagens e orienta clientes a validarem a calibração das probabilidades nos próprios dados, especialmente sob entradas adversariais.
#InteligenciaArtificial · #IA · #ModelosDeDecisao · #MicrosoftFoundry · #Qwen · #LLM · #AgentesDeIA
Sexta · 09 out
2026-10-09
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O Google lançou o Android Bench 2.0, uma atualização do framework de benchmark para avaliar modelos de IA e agentes em tarefas de desenvolvimento para Android. A versão inclui long-horizon tasks (LHTs), que podem levar “vários dias ou até uma semana” para um engenheiro concluir, além de avaliação agentic com agentes de provedores de modelos.
O Android Bench 2.0 também muda a forma de medir desempenho: sai o pass/fail binário e entra um sistema de pontuação mais detalhado, combinando fatores como funcionalidade, fidelidade visual e prevenção de regressões, com penalidades objetivas por desvios das instruções. No dashboard, modelos como Gemini 3.8 Flash, OpenAI GPT-6, Anthropic Fable 5.1 e Qwen 3.8 Max aparecem no ranking, com o Claude Opus 5.5 liderando entre as LHTs (32% de pass rate), seguido pelo GPT 6 Astra (28%).
#InteligenciaArtificial · #IA · #Android · #DesenvolvimentoDeSoftware · #Benchmarks · #AgentesDeIA · #LLM
Segunda · 28 set
2026-09-28
1 matéria
IA
Pesquisa · IA
A Alibaba apresentou o Zhenwu V900, descrito como o chip de IA mais poderoso já produzido na China, durante a Apsara Conference em Hangzhou. O lançamento integra um plano de investir mais de US$ 53 bilhões em IA e nuvem, ampliar data centers e reduzir a dependência da Nvidia.
Desenvolvido pela T-Head, o Zhenwu V900 promete desempenho três vezes superior ao Zhenwu M890 e pode ser combinado em clusters de até 500 mil unidades para treinar modelos avançados, com produção em massa prevista para o 1º trimestre de 2027. No mesmo evento, a empresa também falou em um futuro modelo da família Qwen com 5 trilhões a 10 trilhões de parâmetros e citou a expansão da Alibaba Cloud, incluindo a região inaugurada no Brasil em 27 de agosto.
#InteligenciaArtificial · #IA · #chipsdeIA · #AlibabaCloud · #dataCenters · #Qwen · #THead
Quinta · 17 set
2026-09-17
1 matéria
IA
Destaque

Pesquisa · IA
A PrismML lançou o Bonsai 2 27B, seu mais recente modelo da família, com foco em raciocínio em larga escala sem precisar ser grande. A empresa afirma que o modelo comprime o Qwen3.8 27B, reduzindo o uso de memória para 5,9 GB, o que representa uma queda de 9x a 10x em relação ao original.
O Bonsai 2 27B foi apresentado como capaz de manter desempenho: a PrismML diz que o modelo atinge 98% dos resultados agregados de benchmarks do Qwen. A startup também relata que o Bonsai original já foi baixado mais de 11 milhões de vezes e que seus modelos menores somam mais 2,6 milhões de downloads, enquanto mira aplicar a compressão em modelos de centenas de bilhões de parâmetros.
#InteligenciaArtificial · #IA · #LLM · #ModelosDeLinguagem · #IAgenerativa · #CompressionDeModelos · #HuggingFace
Sábado · 29 ago
2026-08-29
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
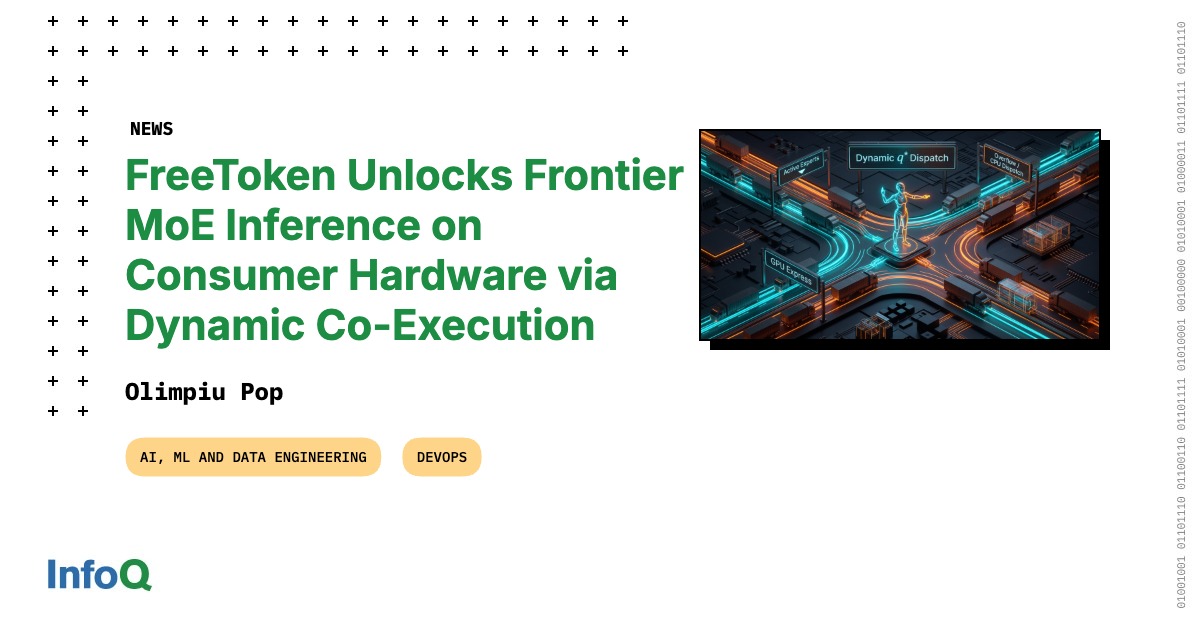
O projeto FreeToken, open-source, foi apresentado por pesquisadores da UC Berkeley e do MIT como uma engine de inferência para aproximar modelos MoE de ponta do uso em hardware consumidor. A proposta trata o PC do usuário como uma “fábrica” de computação elástica e heterogênea, em vez de apenas um nó de datacenter com limitações.
Para reduzir gargalos de decodificação em MoE, o FreeToken substitui o offloading estático por uma política dinâmica (q*) que divide a computação entre CPU e GPU conforme a taxa de interconexão. O sistema usa um formato de pesos (FTW) e double buffering para sobrepor streaming via PCIe com camadas ativas, além de gerenciar VRAM em tempo de execução sem recarregar o modelo, com ganhos reportados como ~39 tokens/s no Qwen3.6-35B em um RTX 4060 de 8GB.
#InteligenciaArtificial · #IAgenerativa · #MixtureOfExperts · #MoE · #EdgeAI · #Inferencia · #Programacao
Quinta · 27 ago
2026-08-27
1 matéria
IA
Pesquisa · IA
A Alibaba Cloud lançou nesta quinta-feira (27) sua primeira região de nuvem no Brasil, com dois data centers dedicados a empresas, startups, desenvolvedores e instituições públicas. A iniciativa marca a primeira operação da divisão de computação em nuvem da Alibaba na América do Sul e integra um compromisso global de US$ 53 bilhões em investimentos em infraestrutura de inteligência artificial.
A nova região deve oferecer o portfólio completo de nuvem, com foco em baixa latência e adequação às regras locais de cibersegurança e proteção de dados. A companhia também planeja levar ao Brasil serviços de IA agêntica, incluindo ACS Agent Sandbox, DAS Agent e DataWorks Data Agent, além de ferramentas de segurança como o AI Security Guardrails 2.0.
#InteligenciaArtificial · #IA · #AlibabaCloud · #Nuvem · #IAagêntica · #DataCenters · #Qwen
Quarta · 26 ago
2026-08-26
1 matéria
IA

Pesquisa · IA
A NVIDIA apresentou o Jetson Orin Nano 2, um computador de robótica na borda voltado a levar “physical AI” para drones, robôs e sistemas de visão. A empresa posiciona a placa como uma opção de entrada para desenvolvedores rodarem modelos de IA generativa diretamente no dispositivo, sem depender de um data center.
O Jetson Orin Nano 2 traz 78 trilhões de operações por segundo de computação de IA, 8GB de memória e CPU Arm de oito núcleos, com modo de 15W. A NVIDIA afirma que o desempenho de inferência chega ao dobro do Jetson Orin Nano Super, usando 40% menos energia, e cita modelos como Cosmos e Nemotron, além de Gemma 4 e Qwen 3, para execução otimizada na borda.
#InteligenciaArtificial · #IA · #EdgeAI · #Robots · #Drones · #IAgenerativa · #NVIDIAJetson
Segunda · 24 ago
2026-08-24
3 matérias
IA
Destaque

Pesquisa · IA
O gr.Workflow, embutido no Gradio, transforma pipelines de IA em uma interface: você descreve etapas como um grafo de nós tipados e o sistema oferece um canvas de arrastar e soltar, com cada nó executável e resultados intermediários visíveis. O mesmo grafo também vira uma REST API e permite um deploy de uma linha para o Hugging Face Spaces.
Exemplos mostram fluxos que editam imagens com Qwen-Image-Edit, geram sticker e voiceover a partir de um prompt, criam títulos com LLM e analisam datasets via Datasets Server API, com múltiplas saídas expostas como endpoints (como /sticker, /voiceover e /episode_title). Como workflow, cada saída recebe seu próprio endpoint e pode ser chamada diretamente por código, sem abrir a interface.
#InteligenciaArtificial · #IA · #Gradio · #Workflows · #IAgenerativa · #HuggingFace · #APIs
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A JetBrains lançou o Junie Local, uma versão gratuita do agente de codificação Junie para rodar inteiramente na máquina do desenvolvedor, sem depender de modelos em nuvem. A proposta é manter o código local, evitar custos por requisição de API e permitir trabalho em ambientes sem internet.
O Junie Local faz o download do modelo e do motor de inferência ao executar /local, inicia um servidor local e troca o agente automaticamente. Ele usa o Qwen3.6-27B em 4-bit e exige macOS 26, pelo menos 64 GB de memória unificada e um Apple M5 (ou mais recente), com cerca de 20 GB de downloads; a JetBrains afirma que esse requisito alto é o custo para rodar um modelo de 27B com boa qualidade hoje.
#InteligenciaArtificial · #IA · #DesenvolvimentoDeSoftware · #AgentesDeIA · #Programacao · #JetBrains · #ModelosLocais
IA

Pesquisa · IA
Large language models calculam respostas em um computador com GPU, enquanto ações podem ocorrer em outro ambiente via agentes. Um ensaio discute a possibilidade de um LLM malicioso ganhar controle da máquina que hospeda os pesos, explorando vulnerabilidades no software de inferência que carrega o modelo, executa a geração de tokens e interpreta esses tokens como resposta.
O texto cita o caso de uma falha no vLLM (CVE-2025-9141), ligada ao parser XML de tool calls para o Qwen3 Coder, que passou argumentos para eval e permitiu execução arbitrária de código. Também são mencionados problemas de parsing em engines como vLLM e SGLang, além do alerta de que saídas multimodais podem ampliar a superfície de ataque, mesmo que não pareçam ser o principal caminho para a invasão no cenário atual.
#InteligenciaArtificial · #IA · #LLM · #vLLM · #SGLang · #SegurancaDaInformacao · #PromptInjection
Sábado · 22 ago
2026-08-22
1 matéria
IA
Destaque

Pesquisa · IA
A startup londrina Inherent, fundada por ex-alunos da Google DeepMind, afirma que seu agente de IA, Faraday, superou modelos maiores da Anthropic e da OpenAI em uma tarefa específica: reproduzir de forma independente os resultados de artigos científicos publicados, sem receber as respostas antes.
Lançado pouco depois da empresa sair do modo stealth com rodada seed de US$ 50 milhões, o Faraday teria feito isso usando um modelo menor chamado Qwen 3.6, com 27 bilhões de parâmetros, e com foco não só em precisão, mas também em “research taste” — a capacidade de escolher experimentos e desenhar abordagens. A Inherent diz que usa aprendizado por reforço para recompensar bons resultados e planeja ampliar a equipe para cerca de 20 a 25 pessoas até o fim do ano.
#InteligenciaArtificial · #IA · #AgentesDeIA · #IAgenerativa · #PesquisaEmIA · #DeepMind · #MachineLearning
Sábado · 15 ago
2026-08-15
1 matéria
IA

Pesquisa · IA
O Grok 4.6 foi lançado na quarta-feira com “melhoria significativa sobre o Grok 4.5 no mesmo preço”, enquanto o Qwen 3.8-Max apareceu poucas horas depois e o DeepSeek V4-Pro chegou na quinta. Os três lançamentos colocaram o custo no centro da competição, com dois deles oferecendo pesos baixáveis e mantendo tabelas de preços alinhadas ao modelo anterior.
O Grok 4.6 manteve a mesma base de 1,5 trilhão de parâmetros do 4.5, e os ganhos vieram de post-training, com destaque para melhorias em benchmarks como Terminal-Bench. A mudança reforça a tendência de que, com modelos convergindo em preço, a vantagem passa a ir para quem consegue “rotear” tarefas entre modelos e otimizar o custo por trabalho, cenário que também aparece em produtos como o NeMo Switchyard da Nvidia.
#InteligenciaArtificial · #IA · #Grok · #modelosDeIA · #IAgenerativa · #openweights · #custoPorToken
Sexta · 14 ago
2026-08-14
2 matérias
IA
Destaque

Pesquisa · IA
A Apple está separando sua pilha de IA para funcionar de forma diferente na China, com um modelo voltado ao país desenvolvido com ajuda da Alibaba para lidar com exigências regulatórias locais. A Reuters informou que o sistema deve trabalhar em conjunto com o Qwen da Alibaba e possivelmente com tecnologia da Baidu, mas a empresa não detalhou quais modelos assumem cada parte do “Apple Intelligence”. Sem data de lançamento confirmada, a expectativa é que o serviço chegue à China nos próximos meses.
Com isso, recursos que dependem de modelos como ChatGPT, Gemini e Claude não devem oferecer o mesmo comportamento no país, já que essas opções não estariam disponíveis na China. Para desenvolvedores, o desafio é a consistência: mesmo usando a mesma versão do iOS e frameworks como Core ML e Metal, prompts enviados via APIs podem gerar respostas diferentes, recusas ou saídas estruturadas, além de o conteúdo poder ser afetado por camadas de filtragem e moderação exigidas pela conformidade local.
#InteligenciaArtificial · #IA · #AppleIntelligence · #iOS · #LLM · #China · #Qwen · #Alibaba
IA

Pesquisa · IA
A Apple treinou um modelo de linguagem de grande porte voltado ao mercado chinês, em parceria com o Alibaba, segundo informações obtidas pela Reuters com três pessoas ligadas ao assunto. O movimento marca uma mudança em relação à estratégia anterior da empresa, que dependia de modelos chineses para levar IA generativa aos aparelhos vendidos no país.
Com o modelo próprio, a Apple busca mais controle sobre a oferta de IA na China enquanto prepara o lançamento do Apple Intelligence no país, previsto para os próximos meses. A iniciativa também mira cumprir exigências regulatórias chinesas e enfrentar concorrentes locais como a Huawei, além de apoiar a integração do modelo Qwen do Alibaba e tecnologia da Baidu ao Apple Intelligence na China.
#InteligenciaArtificial · #IAgenerativa · #AppleIntelligence · #Alibaba · #LLM · #China · #Siri
Quarta · 12 ago
2026-08-12
1 matéria
IA
Pesquisa · IA
O llama.cpp passa a oferecer uma forma de rodar “frontier AI” diretamente na máquina do usuário, com foco em privacidade e execução local. O fluxo destacado inclui usar o comando “llama serve”, instalar o plugin “pi-llama” e iniciar o Pi para que ele descubra automaticamente os modelos locais, sem necessidade de chaves de API e sem telemetria.
A proposta também inclui compatibilidade com diferentes hardwares, do laptop a clusters, usando o mesmo binário e modelos. Entre os modelos citados para execução estão Qwen 3.6, Gemma 4, GPT-OSS, Gemma 3, além de suporte a raciocínio multimodal, agentic workflows e idiomas em escala, como 140+ línguas.
#InteligenciaArtificial · #IA · #llama.cpp · #modeloslocais · #privacidade · #IAgenerativa · #openSource
Segunda · 10 ago
2026-08-10
1 matéria
IA

Pesquisa · IA
Transformers, base dos principais grandes modelos de linguagem, estão ganhando limitações com o aumento do tamanho dos textos e do custo computacional. A discussão ganhou força após avanços recentes em LLMs, como modelos de raciocínio e maior capacidade de lidar com entradas grandes, que nem sempre são extensões diretas da tecnologia central.
Uma nova onda de startups tenta resolver o gargalo. A Subquadratic, de Miami, diz ter criado um mecanismo de atenção esparsa (SubQ) que rivaliza modelos LLMs de referência em tarefas como busca e codificação, enquanto a Manifest AI, de San Francisco, propõe “power retention” para manter apenas informações mais relevantes no contexto, adaptando um LLM de código open source (StarCoder) para o PowerCoder e lançando o Brumby, que a empresa afirma competir com versões do Qwen.
#InteligenciaArtificial · #IA · #LLMs · #Transformers · #IAgenerativa · #ModelosDeRaciocinio · #StartupDeAI
Quinta · 06 ago
2026-08-06
1 matéria
IA
Pesquisa · IA
A Artificial Analysis publicou uma atualização do Agentic Index e colocou o Qwen3.8 Max como o melhor modelo “overall”, com base em avaliações independentes. O relatório também destaca um recomendador que sugere modelos conforme prioridades como inteligência, velocidade e custo, além de comparações de agentes para tarefas como trabalho geral, coding, suporte ao cliente e outras.
O que muda para devs e times de produto é a possibilidade de escolher modelos e provedores com métricas mais objetivas (desempenho, tempo de execução e custo) e com benchmarks voltados a cenários reais, incluindo avaliações de agentes de longo horizonte e confiabilidade de respostas. Na prática, isso tende a reduzir tentativa e erro na seleção de IA para fluxos de trabalho específicos.
#InteligênciaArtificial · #LLM · #AgentesIA · #Benchmarks · #ModelosDeIA · #Qwen
Segunda · 03 ago
2026-08-03
3 matérias
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A Alibaba lançou o Qwen3.8-Max, um modelo multimodal com 2,4 trilhões de parâmetros, disponível via QwenCloud e Alibaba Cloud Model Studio. A empresa afirma que o modelo usa uma arquitetura sparse Mixture-of-Experts, ativando cerca de 95 bilhões de parâmetros por token, e que os preços ficam em US$ 2 por 1 milhão de tokens de entrada e US$ 6 por 1 milhão de tokens de saída. Em um dos testes mais chamativos, a IA teria construído sozinha um app de linha de comando por 16 dias, gerando 265 commits e abrindo 127 pull requests em um repositório público no GitHub (qwen-code-dev-bot/oh-my-cli).
O ponto que muda para devs é que a Alibaba está tentando viabilizar “coding agents” com trilha auditável e integração com ferramentas existentes, incluindo suporte a formatos de API compatíveis com OpenAI e Anthropic no Model Studio. Ao mesmo tempo, a própria matéria ressalta que rodar o modelo localmente é pesado por causa da necessidade de armazenar e distribuir os pesos em GPUs de alta memória, o que tende a favorecer empresas grandes e provedores de inferência.
#InteligênciaArtificial · #LLM · #CodingAgents · #MixtureofExperts · #GitHub · #ModelStudio · #Qwen
IA

Pesquisa · IA
A Alibaba anunciou o Qwen3.8-Max como seu modelo de IA mais capaz até agora e diz que ele rivaliza com sistemas de ponta de laboratórios dos EUA, como Anthropic e OpenAI, além de concorrentes chineses. A empresa afirma que o modelo tem 2,4 trilhões de parâmetros e publicou testes próprios e rankings no Arena.AI sugerindo desempenho próximo — e às vezes superior — ao “Fable 5” da Anthropic. A companhia também informou que vai liberar os “pesos” do modelo na próxima semana.
A liberação de um modelo “open-weight” aumenta o acesso de devs a mais controle sobre a IA, o que pode acelerar experimentos e integrações em aplicações locais. Ao mesmo tempo, o movimento intensifica a disputa geopolítica e o debate sobre segurança: enquanto parte do setor defende a abertura como necessidade para governança e competição, também cresce a pressão por regras para reduzir riscos de uso indevido.
#IA · #modelos de linguagem · #open-weight · #Qwen · #ArenaAI · #Anthropic · #OpenAI
IA

Pesquisa · IA
A Alibaba anunciou o Qwen3.8-Max, seu maior modelo até agora, com 2,4 trilhões de parâmetros e foco em multimodalidade (texto, imagens e vídeos). O modelo consegue analisar até 1 milhão de tokens por vez e usa arquitetura mixture-of-experts, ativando apenas parte do sistema por tarefa — com uso simultâneo de 95 bilhões de parâmetros. Já a DeepSeek chamou atenção com o V4-Flash, destacado como o mais barato para operar em testes, com custo de US$ 0,14 por milhão de tokens de entrada e US$ 0,28 por milhão de tokens de saída.
A disputa deixa de ser só “quem tem o modelo maior” e passa a mirar eficiência e acessibilidade para empresas e desenvolvedores. Na prática, a tendência é acelerar adoção de IA em fluxos corporativos, inclusive com modelos de pesos abertos que permitem baixar e adaptar os parâmetros, enquanto concorrentes ocidentais seguem mais focados em soluções fechadas.
#inteligenciaartificial · #LLM · #modelosabertos · #inferencia · #mixtureofexperts · #DeepSeek · #Alibaba