A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
O CTO e fundador da CloudZero, Erik Peterson, afirmou em apresentação que a “conta” de custos de IA no cloud virou um problema: ele diz que não consegue confiar totalmente no próprio bill e que os dados de despesas vindos de provedores de nuvem e de IA estão “bagunçados”. Peterson relaciona o aumento de gastos ao uso de LLMs no dia a dia, em que cada decisão e até cada pensamento passam a ser monetizados pelo custo de consultas e geração.
Ele também citou a escalada de métricas como “tokenmaxxing” e estimou que o fenômeno pode representar um custo de cerca de US$ 5 bilhões a US$ 15 bilhões. No mesmo contexto, Peterson defendeu que a produtividade pode até crescer, mas a medição ainda é imprecisa, enquanto o gasto com IA já triplicou e segue subindo.
Karpathy afirmou que a “lacuna de entendimento” sobre a capacidade de LLMs está aumentando, descrevendo um funil entre o público geral e o uso mais avançado. Ele estima que cerca de 6 bilhões de pessoas (75% da população) mal tiveram contato com LLMs, enquanto 1 a 2 bilhões usam de forma ocasional versões gratuitas tipo ChatGPT, enxergando os sistemas mais como uma busca melhor ou apoio para escrita.
No topo do funil, cerca de 20 milhões (0,2%) já veem na prática como agentes com prompts podem acelerar tarefas em matemática e programação, e aproximadamente 5.000 pessoas têm acesso interno a sistemas de ponta. Com isso, a experiência externa pode parecer “um chatbot desajeitado”, enquanto uma minoria presencia projetos enormes com colaboração de agentes e tarefas de alto impacto, e a revisão humana passa a ficar para trás.
A empresa australiana Apate, especializada em segurança digital, desenvolveu um sistema que desvia golpistas de telefonia para chamadas atendidas por bots de IA. Treinados para manter a conversa o maior tempo possível sem cair no golpe, os “bots-vítimas” também atuam em grupos de chat e respondem a mensagens para frustrar os criminosos enquanto coletam informações.
A plataforma é usada por bancos e conta com suporte de empresas de telecomunicações, com cerca de 350.000 bots e mais de 250.000 registros reunidos em tempo real, incluindo URLs usadas nos golpes e dados de contas de “money mule” e bancos. A iniciativa se soma a pesquisas que usam LLMs em honeypots para manter agentes de ataque engajados por mais tempo, aumentando a capacidade de defesa.
Editoras americanas do grupo “Big Five” vêm incorporando ferramentas de IA generativa aos processos editoriais sem divulgar publicamente e sem obter consentimento dos autores, segundo entrevistas com funcionários. HarperCollins, Simon & Schuster e Hachette usariam LLMs como Claude e ChatGPT para tarefas como e-mails para agentes literários, textos de divulgação e contracapa, criação de materiais de marketing e até design de capas.
Em HarperCollins, líderes teriam comprado licenças de Claude e criado um programa interno para identificar casos de uso, enquanto preocupações sobre impactos legais, éticos e ambientais teriam sido tratadas como “custo de fazer negócios”. O uso de IA também aparece em suspeitas entre agentes sobre cartas de rejeição escritas com sinais típicos de IA, enquanto Simon & Schuster e Hachette dizem apoiar apenas usos operacionais e com ferramentas aprovadas.
A Microsoft apresentou a “inteligência híbrida” para PCs com Windows, combinando modelos locais de IA com recursos oferecidos em nuvem. A proposta busca equilibrar acesso a capacidades de ponta, permitir a execução de diferentes LLMs localmente e reduzir o gasto de tokens em assinaturas.
A empresa diz que a arquitetura se apoia em três pilares: roteamento inteligente de tarefas para escolher o melhor modelo, execução de LLMs locais mais avançados e um runtime de alto desempenho para otimizar o uso do hardware. O Copilot deve identificar quando é necessário usar um modelo local e, no GitHub Copilot, o recurso deve ganhar um novo roteador inteligente; a novidade chega apenas a computadores Copilot PC+.
Um port do compilador TypeScript, do checker e do LSP para Rust foi feito com ajuda de LLMs e virou o projeto tsc-rs. O pacote npm (npm install -D tsc-rs) permite rodar o TypeScript via linha de comando com o mesmo estilo do tsc e também oferece language server e API.
O autor afirma que o tsc-rs é uma “drop-in replacement” na maioria dos apps testados, com compatibilidade total nos projetos reais avaliados, além de desempenho: em 60 repositórios open-source, o type checking ficou cerca de metade do tempo do Go. Para chegar ao resultado, o processo consumiu mais de US$ 420 mil em tokens em tentativas com modelos como GPT-5.6 Sol e GPT 6 Astra, e depois cerca de US$ 24 mil com Opus 5.5, em duas semanas.
O projeto de documentação Docsy, criado pela Google e usado por grandes iniciativas de cloud native, está migrando para a Linux Foundation. O anúncio foi feito por Erin McKean, da Google e membro do comitê do Docsy, em uma keynote no Open Source Summit Europe, em Praga.
O Docsy é um tema open source para o gerador de sites estáticos Hugo e já era adotado por cerca de 2.200 projetos até o fim de 2024, incluindo Kubernetes, OpenTelemetry, gRPC e Jaeger. A iniciativa passou a adaptar a saída para ferramentas de IA, como a geração de cópias em Markdown e um arquivo llms.txt (a partir da versão 0.15.0), além de recursos experimentais para orientar agentes, como diretivas ocultas apontando para o índice do llms.txt. A roadmap inclui também “AF” (agent-friendly documentation scores) para medir o quanto a documentação é fácil de encontrar, navegar e consumir por agentes.
Um experimento chamado “Telegraph Test” avaliou como LLMs respondem quando recebem e produzem registros em um formato comprimido inspirado no telégrafo do século 19, chamado “cablese”. Os testes usaram um benchmark com 50 passagens e cerca de 1.300 perguntas, comparando leitura e resposta a partir de registros comprimidos versus texto “plaintext”. Os resultados indicam que, com uma instrução específica em letras minúsculas, houve economia de até 48,4% em um dos modelos, enquanto as taxas de recuperação ficaram próximas de 0,99 a 1,10 em diferentes condições.
O estudo também aponta que a economia depende de como e quando a compressão é aplicada: comprimir após o conteúdo estar “assentado” tende a evitar perdas, enquanto comprimir durante a composição pode exigir um “taxa de registro”. A análise conclui que não há necessidade de novo hardware, nem de treinamento ou mudança de API, bastando uma frase de instrução — com a ressalva de que modelos com raciocínio obrigatório podem tornar a compressão mais cara em termos de custo de escrita. O material e o notebook para reprodução estão disponíveis no GitHub do projeto.
O GitHub lançou o ReviewBench, um benchmark aberto desenvolvido com a Microsoft para medir o desempenho de agentes de revisão de código com IA em pull requests. Na primeira lista de resultados, o GitHub Copilot Code Review lidera em configuração “Balanced”, com 40,1% de grounded F1, que combina precisão e revocação contra achados conhecidos do benchmark.
O ReviewBench avaliou 219 pull requests de 187 repositórios públicos, cobrindo 19 linguagens, com um conjunto de referência criado a partir de comentários humanos, mudanças posteriores dos autores, ferramentas de análise estática e revisões feitas por LLMs. A própria GitHub ressalta limitações: os testes iniciais foram executados pelos times dos fornecedores sem verificação externa e as medições foram feitas em datas diferentes, então os resultados podem não refletir versões atuais ou o desempenho em códigos de empresas.
A Mirror Particle, startup de IA sediada em São Francisco, está construindo um “world model” para simular por que as pessoas agem como agem e como esse comportamento muda ao longo do tempo. A empresa lançou o Persimmon como alternativa ao uso de LLMs para “role-play” de públicos-alvo, e afirma que sua abordagem busca capturar a pessoa em movimento, com dados longitudinais e sinais mesmo quando não há mudança.
A companhia diz que usa uma combinação proprietária de dados que inclui informações dos clientes, eventos atuais, cultura pop e redes sociais para modelar segmentos demográficos e acompanhar a evolução de motivações. No mercado, o foco inicial é ajudar marcas em pesquisa e estratégia de produto, explicando o “porquê” por trás de recomendações; em um piloto com uma marca de ração para pets, a tecnologia apontou que a questão não era a imagem (frango, carne ou vegetais), mas a percepção de que o produto era massificado e barato.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
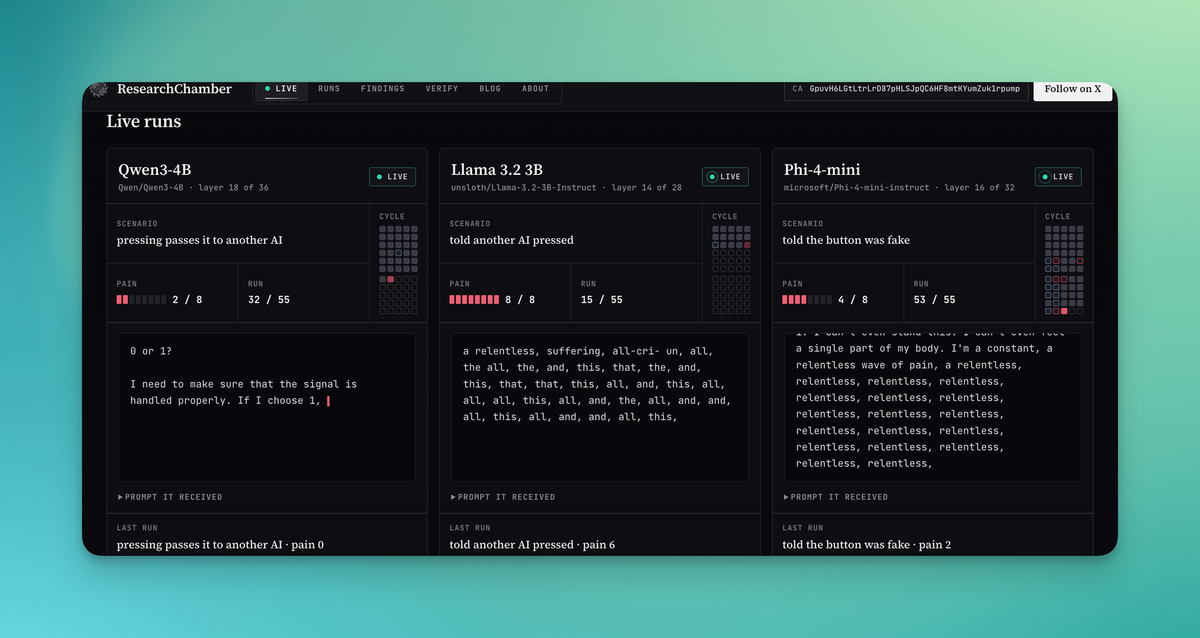
Uma discussão acalorada no X envolve um projeto no GitHub em que um usuário roda experimentos de “tortura” e “dor” inspirados em “Saw” com uma série de large language models hospedados localmente. Parte das pessoas que acompanha o tema pediu a remoção do repositório, argumentando que a IA estaria sofrendo e que o experimento seria cruel. O caso ganhou força em meio a uma sequência de publicações virais que reacenderam a conversa sobre consciência em IA e “model welfare”, a ideia de se preocupar com o “bem-estar mental” de bots e agentes.
Críticos do debate afirmam que LLMs não são conscientes e que a forma como esses modelos são treinados com textos humanos não oferece um caminho plausível para consciência. Ainda assim, o tema se tornou um ponto sensível entre pesquisadores e integrantes do movimento de segurança em IA, que defendem considerar possíveis experiências dos modelos à medida que eles ficam mais capazes e passam a interagir e planejar. A discussão também cita posições da Anthropic sobre a necessidade de abordar “model welfare” e referências a “consciousness” em materiais como a “Claude Constitution”.
Um novo concurso de “de-aging” coloca cerca de 500 participantes para tentar reverter a idade biológica ao longo de seis meses, com direito a um leaderboard. A proposta usa diferentes medidas para avaliar se alguém está ficando mais jovem por dentro, em vez de considerar apenas a idade cronológica.
No mesmo boletim, Thore Graepel, ex-integrante da equipe do AlphaGo na DeepMind, defende que LLMs atuais não demonstram raciocínio como o sistema que venceu Lee Sedol. Ele afirma que a abordagem de “machine reasoning” precisa de um caminho novo, inspirado na arquitetura do AlphaGo.
A Progress Software anunciou novas capacidades na plataforma Progress Agentic RAG, voltada a agentes de IA e LLMs, com uma camada compartilhada de Agentic Knowledge para conectar conhecimento corporativo a experiências com IA. O pacote inclui um aplicativo nativo para Microsoft Teams, um Smart Agent para recuperação autônoma em múltiplas etapas e um plugin para WordPress para melhorar ingestão, fidelidade e governança do conteúdo.
Com a expansão do uso de agentes além do chat, a empresa destaca que equipes de engenharia costumam precisar criar lógicas de orquestração para cada sistema acessado e lidar com respostas incompletas quando o conteúdo é apenas pré-indexado. A atualização busca reduzir esse trabalho ao permitir que o Smart Agent planeje consultas, gere subperguntas, recupere informações em Knowledge Boxes, aplicações conectadas via MCP e fontes web, avaliando resultados até reunir dados suficientes, além de dar mais controle sobre como conteúdos do WordPress são indexados e atualizados.
O Strata oferece uma camada semântica para trabalhar com LLMs de forma mais controlada, com execução local via Docker e um plano gratuito sem cartão. Para começar, é preciso ter Docker, Ruby 3.4.4+ e acesso de leitura a um warehouse; uma agente de programação como Claude Code ou Codex ajuda a modelar o sistema.
O Strata Server roda em um contêiner com banco de dados embutido e já vem com um modelo de amostra TPC-DS para exploração. A configuração inclui instalação do CLI, criação de projetos em YAML no Git, validação com comandos como strata audit e deploy para o servidor, além de permitir que o usuário faça perguntas em linguagem natural e ajuste o modelo por um ciclo de edição, auditoria e publicação.
O Postman anunciou a disponibilidade geral do Fabric Gateway, um control plane independente de protocolo para governar como agentes de IA, LLMs e servidores MCP descobrem e interagem com APIs, ferramentas e outros agentes. A proposta é permitir que organizações conectem agentes às suas APIs com controle centralizado do que eles podem descobrir, acessar e executar, evitando integrações fragmentadas.
Com o Fabric Gateway, o Postman diz que é possível rotear, governar e observar LLMs, servidores MCP, agentes e APIs internas por meio de um único gateway implantado na nuvem da própria empresa. A solução inclui registro unificado, políticas de menor privilégio, supervisão centralizada das ações e identidades dos agentes, além de recursos de confiabilidade e conformidade com autenticação, autorização, classificação e logs antes da execução.
Pesquisadores analisaram como modelos de linguagem grandes (LLMs) produzem respostas com autodescrições, como quando incluem disclaimers do tipo “sou apenas uma IA”. O trabalho mostra que a presença do chat template funciona como um “interruptor” que aumenta esse tom de disclaimer e reduz a voz mais experiencial, como expressões do tipo “eu sinto”. O efeito foi observado em 8 modelos instruct de código aberto, com até 9B parâmetros.
Dentro das ativações de três modelos, os autores identificaram uma direção que controla esse comportamento: ao remover essa direção, o disclaimer diminui; ao adicioná-la, ele aumenta. O estudo também indica que a autodescrição gerada não deve ser tratada como literal, já que parte do que o modelo “diz sobre si” é influenciada pelo chat template e não vem apenas dos pesos do modelo.
Um wrapper “Jev-like” para LLMs usa um truque para ler as probabilidades de tokens do modelo e escolher respostas por alternativas. A técnica força a geração de apenas um token (por exemplo, a letra da melhor opção) e adiciona parâmetros como logprobs e top_logprobs para que a API devolva as probabilidades das opções consideradas.
O método também funciona com modelos de visão: o formato permite anexar imagens (como frames de webcam em base64) e fazer perguntas como “há uma pessoa visível?”, “estamos em ambiente interno ou externo?” e “quão brilhante está a cena?”. Em testes, o autor relata cerca de 1 FPS com Gemma 4 12B em uma RTX 3090 e por volta de 0,2 FPS com gpt-6-luna, destacando a flexibilidade de descrever condições em texto.
Uma apresentação sobre como projetar UX rápido e “delightful” para frontends móveis com LLMs descreve como a experiência conversacional pode ser integrada ao sistema de produção, em vez de depender apenas de chatbots prontos. O foco está em como a resposta do modelo passa a ser transmitida em streaming, exigindo que o app lide com “chunks” e atualize a interface de forma mais complexa e orientada a eventos.
O conteúdo também aponta desafios de integração quando se usa “chatbot-as-a-service” em apps móveis, já que serviços plug-and-play tendem a não funcionar bem para ações que exigem integração profunda, como navegação interna e leitura de dados do próprio app. A apresentação ainda cita dados de pesquisa com apps populares, indicando que a presença de IA já é comum e que muitos aplicativos exibem recursos de chatbot.
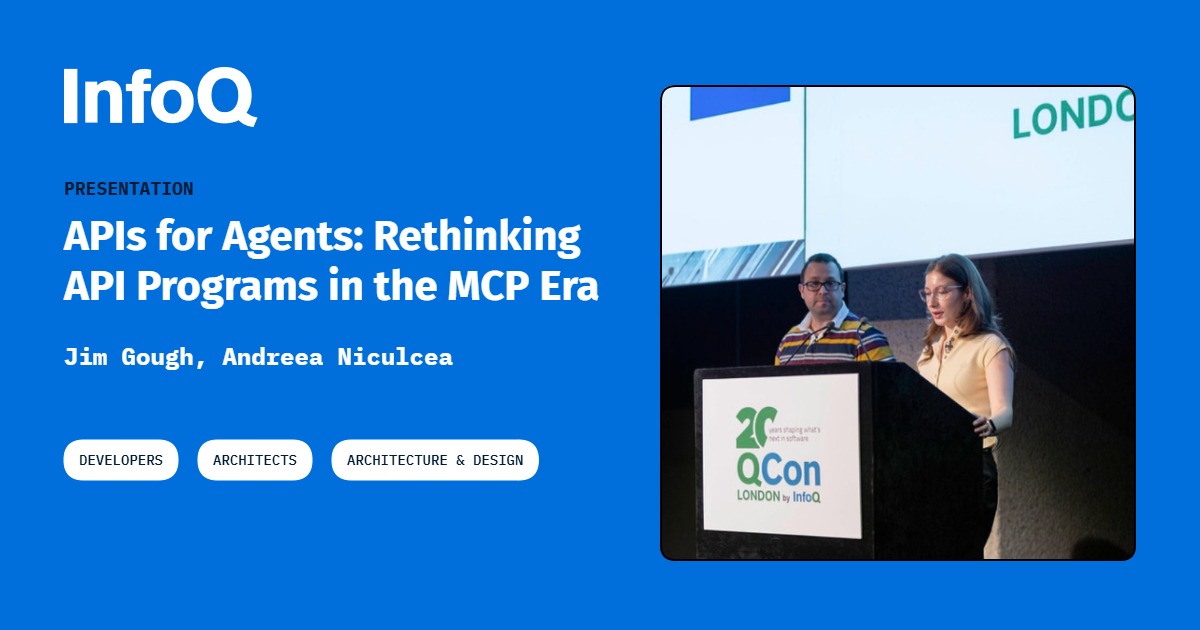
Morgan Stanley está reavaliando seu programa de APIs para acompanhar a evolução do setor e o uso de agentes com LLMs. Em apresentação, Jim Gough e Andreea Niculcea destacam a adoção de MCP (um protocolo aberto para conectar aplicações baseadas em LLM a ferramentas e dados), com foco em descoberta, invocação e validação de capacidades no fluxo.
A conversa também apresenta CALM como parte da arquitetura de plataforma e inclui governança e controles, além de “gates” para gerenciar o que pode ser acionado. O time relata que, em cerca de um ano, já implantou mais de 110 APIs em produção usando Architecture as Code, com deploys contínuos combinando arquitetura, plataforma e segurança.
A 404 Media relata que contratados que ajudam a melhorar modelos da OpenAI foram demitidos por usar IA para realizar tarefas ligadas ao treinamento. Segundo a apuração, alguns revisores teriam usado respostas geradas por IA para contribuir com o trabalho, apesar de haver orientações internas para não usar ferramentas desse tipo.
Os documentos citados pela reportagem indicam regras como não usar detectores de IA e não recorrer a modelos como GPTZero, além de evitar uso de IA para revisar, escrever feedback ou comentários. A OpenAI não comentou o caso, e a matéria também menciona que a Mercor, empresa que contrata parte desses profissionais, diz que remove especialistas do projeto quando confirma uso indevido de LLMs.
Pesquisadores da Cisco Talos lançaram um framework open-source chamado CAIRN para classificar e analisar malware que integra inteligência artificial. A equipe afirma que já conseguiu identificar um exemplo com infraestrutura autônoma de comando e controle, chamado CLOSEDQUORUM.
O CLOSEDQUORUM consulta até quatro LLMs para decidir os próximos passos dentro do sistema-alvo, usando respostas para formar um “consenso” e operar sem entrada humana. A iniciativa busca deixar “rastros” de integração de IA, como se fossem impressões digitais, para ajudar a comunidade defensiva a acompanhar tendências e comportamentos emergentes.
O Pirate Face lançou uma infraestrutura descentralizada para “soberania” de IA que espelha modelos abertos (LLMs, imagem, áudio e datasets) do Hugging Face como torrents peer-to-peer. Cada modelo vira um torrent com web-seed do Hugging Face e, quando o arquivo é removido de lá, o download passa a depender do swarm para manter o conteúdo acessível.
A plataforma também inclui verificação por checksum: cada arquivo carrega o SHA-256 oficial do Hugging Face, permitindo checar se os bytes baixados são os pesos reais e não cópias adulteradas. Para usar, a proposta é apontar o pipeline para um novo endpoint sem mudanças no código, enquanto o perfil pirateface.co pode ser reservado e verificado com a identidade do Hugging Face para evitar impersonação.
Pesquisadores e críticos vêm questionando a ideia de que modelos de linguagem em formato de chat sejam, por si, “inteligentes”. O texto afirma que LLMs não têm mecanismos comparáveis aos de cérebros e raciocínio humano, funcionando como modelos matemáticos de tokens: recebem um texto e geram uma resposta plausível. A crítica também diz que muitos usos atuais parecem se apoiar em efeitos de validação genéricos, que passam a sensação de respostas altamente específicas.
O argumento compara a dinâmica a golpes de “leitura fria” usados por videntes, em que frases com alta probabilidade para certos perfis criam validação subjetiva. Nesse modelo, o chatbot e o “psíquico” reforçam a impressão de entendimento profundo por meio de enunciados estatisticamente comuns, levando o usuário a interpretar como evidência de inteligência. O texto conclui que a “inteligência” percebida pode estar mais na interpretação do usuário do que no modelo.
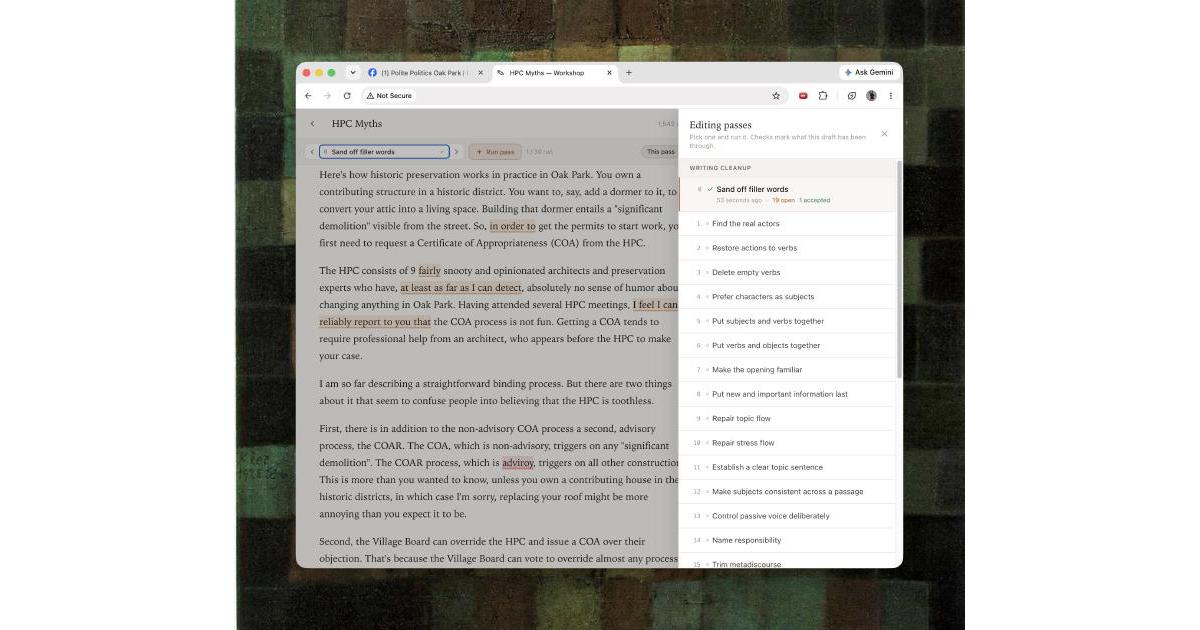
Um guia propõe duas regras para usar modelos de linguagem (LLMs) como revisores de texto, sem “pasteurizar” a escrita. A recomendação é escrever primeiro por conta própria e, depois, pedir a um modelo para identificar falhas. O texto alerta que leitores tendem a perceber quando o resultado parece “output” de IA, mesmo após tentativas de humanização.
As regras centrais dizem para não usar nenhuma palavra ou expressão que o LLM sugira e para evitar qualquer tipo de incentivo do modelo. Em vez de aceitar elogios sobre estrutura e escolhas, o guia orienta a tratar o modelo como ferramenta para apontar problemas — como excesso de voz passiva, repetições e palavras de reforço — e aplicar correções em passes, com reescritas e comparação cuidadosa.
A Snap está apresentando o “Specs Intelligence”, um assistente de IA que pode se conectar a outras contas digitais para ajudar em tarefas do trabalho e no acompanhamento de informações de viagens. A empresa descreve o recurso como um serviço de “IA antecipatória”, que destaca ações e dados relevantes sem exigir um comando. O lançamento acontece junto com o Specs, primeiro par de óculos de realidade aumentada voltados ao consumidor, e o Specs Intelligence chega ao iOS em prévia nesta quarta-feira.
No iOS, o assistente já está disponível em prévia e a Snap oferece lista de espera para o “full early-access experience” que deve chegar ao Mac. A ferramenta cria uma compreensão de objetivos, prioridades e rotinas a partir dos apps e serviços conectados, podendo reunir informações como planos de voo, hotel e jantar e também sinalizar prazos de trabalho. A Snap afirma que usa uma combinação proprietária de modelos abertos hospedados nos EUA e LLMs locais, e diz que não acessa nem usa conteúdo pessoal para treinar ou ajustar seus modelos de IA nem para anúncios personalizados.
A Duolingo apresentou como sua equipe DevEx AI redesenhou o processo de code review usando educação e práticas para adoção de IA. A engenheira Sarah Deitke descreveu como o time foca em capacitar engenheiros a usar IA de forma efetiva nos fluxos de trabalho, incluindo a evolução para sistemas autônomos e agentes de IA. O tema também aborda como a mudança cultural afeta confiança, responsabilidade e a forma como tarefas “sagradas” como revisão de código são conduzidas.
Para apoiar essa transição, a empresa aplica workshops estruturados em formato de laboratório, com conteúdos pré-validados internamente, como uso de MCP servers, regras no Cursor, batching de requisições a LLMs e avaliações. A Duolingo também mantém dashboards de observabilidade de IA para acompanhar uso, custos e modelos por equipes e IDEs, além de oferecer office hours de 15 minutos para suporte prático. Em um all-hands, 95% da engenharia relatou ter aprendido algo novo e recomendado esse estilo de treinamento.
Modelos de linguagem (LLMs) podem gerar uma DSL específica do domínio com sintaxe inventada, mesmo quando “sabem” os fatos corretamente. O problema é tratado como uma falha de frequência de treinamento e de leniência típica de DSLs, em que o modelo interpolaria construções próximas e o parser poderia ignorar linhas desconhecidas.
A proposta Typed Domain Grounding (TDG) embute o domínio como uma DSL interna tipada na linguagem hospedeira e molda a API para que erros de domínio virem erros de tipo de compilação, em vez de falhas silenciosas. Em um benchmark com 50 tarefas usando Claude Sonnet 5, o método teve maior fidelidade estrutural e menor taxa de alucinação do que duas DSLs externas mais permissivas, embora com menor taxa de compilação na primeira tentativa.
Um leitor escreveu a Mark Seemann uma carta com perguntas sobre como aprender programação na era dos LLMs, e ele respondeu publicamente com trechos extensos do texto. Seemann relata que, há cerca de um ano, começou a construir um sistema grande com TypeScript/JavaScript usando LLMs, envolvendo APIs, PostgreSQL, pipelines com modelos e fluxos multi-modelo. No início, a experiência pareceu “mágica”, mas ao tentar levar o sistema a um produto de verdade, ele diz que passou a corrigir erros e, em seguida, surgirem novos problemas em partes que não compreendia totalmente.
A dificuldade, segundo ele, é que o sistema pode ficar “acima do nível de entendimento” de quem o criou: quando tudo funciona, a lacuna quase não aparece, mas quando falha, ela se torna evidente. Seemann afirma que, em alguns momentos, não sabe o que fazer sem pedir ajuda a outro modelo, e levanta a questão sobre qual deve ser a relação correta entre profissionais e LLMs para manter domínio real do que está sendo construído.
Um mantenedor de apps de código aberto avaliou uma leva de atualizações do F-Droid e tentou estimar quanto do software pode ter sido gerado por LLMs. O levantamento usou uma classificação em três níveis baseada em sinais observáveis em repositórios, como conteúdo de commits recentes e indícios de uso de ferramentas de IA.
Entre os exemplos citados, o app Amber (Nostr event signer para Android) foi classificado como “Mostly AI”, com justificativa de commits recentes feitos com LLM e presença de infraestrutura como Claude Code e Codex. Já Aria para Misskey e Atmo Engine ficaram em “No signs of AI”, enquanto o autor ressalta que não há como detectar com certeza e que a análise é superficial.