A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A experiência de pesquisadores que saem da teoria para aplicações no mundo real ganhou um novo impulso com o MIT-IBM Computing Research Lab, que conecta ex-alunos do MIT e um ex-postdoc hoje na IBM. Entre os temas trabalhados estão quantum machine learning, reinforcement learning e agentes de IA, além de foco em IA confiável e justa.
Na IBM, Zhang-Wei Hong desenvolveu técnicas para dar mais contexto e feedback de recompensa a agentes, aplicando ideias em robótica, LLMs e reinforcement learning para ciência. Irene Ko, por sua vez, trabalha em métodos para acessar sinais internos do modelo durante a inferência com o vLLM Hook, usando essas informações para analisar riscos como prompt-injection e alucinação, com uma proposta de plugin leve para reduzir custos.
Large language models calculam respostas em um computador com GPU, enquanto ações podem ocorrer em outro ambiente via agentes. Um ensaio discute a possibilidade de um LLM malicioso ganhar controle da máquina que hospeda os pesos, explorando vulnerabilidades no software de inferência que carrega o modelo, executa a geração de tokens e interpreta esses tokens como resposta.
O texto cita o caso de uma falha no vLLM (CVE-2025-9141), ligada ao parser XML de tool calls para o Qwen3 Coder, que passou argumentos para eval e permitiu execução arbitrária de código. Também são mencionados problemas de parsing em engines como vLLM e SGLang, além do alerta de que saídas multimodais podem ampliar a superfície de ataque, mesmo que não pareçam ser o principal caminho para a invasão no cenário atual.
A Meta colocou o modelo Muse Glimmer em circulação com foco em uso local, agente e multimodal, trazendo suporte “day-0” para integrações em bibliotecas como transformers, llama.cpp e vLLM. O Muse Glimmer é um modelo denso de 30B parâmetros, com encoder de visão estilo ViT de 2B para percepção e um decoder de texto com 28B.
Além do modelo principal, há um módulo opcional de speculative decoding implementado no DFlash, que pode acelerar a geração com custo adicional de memória, especialmente em conteúdo estruturado como código. O lançamento também inclui instruções para carregar o modelo via AutoModelForMultimodalLM e AutoProcessor, com exemplos de inferência apenas por texto, entrada de imagens e tool calling multimodal.
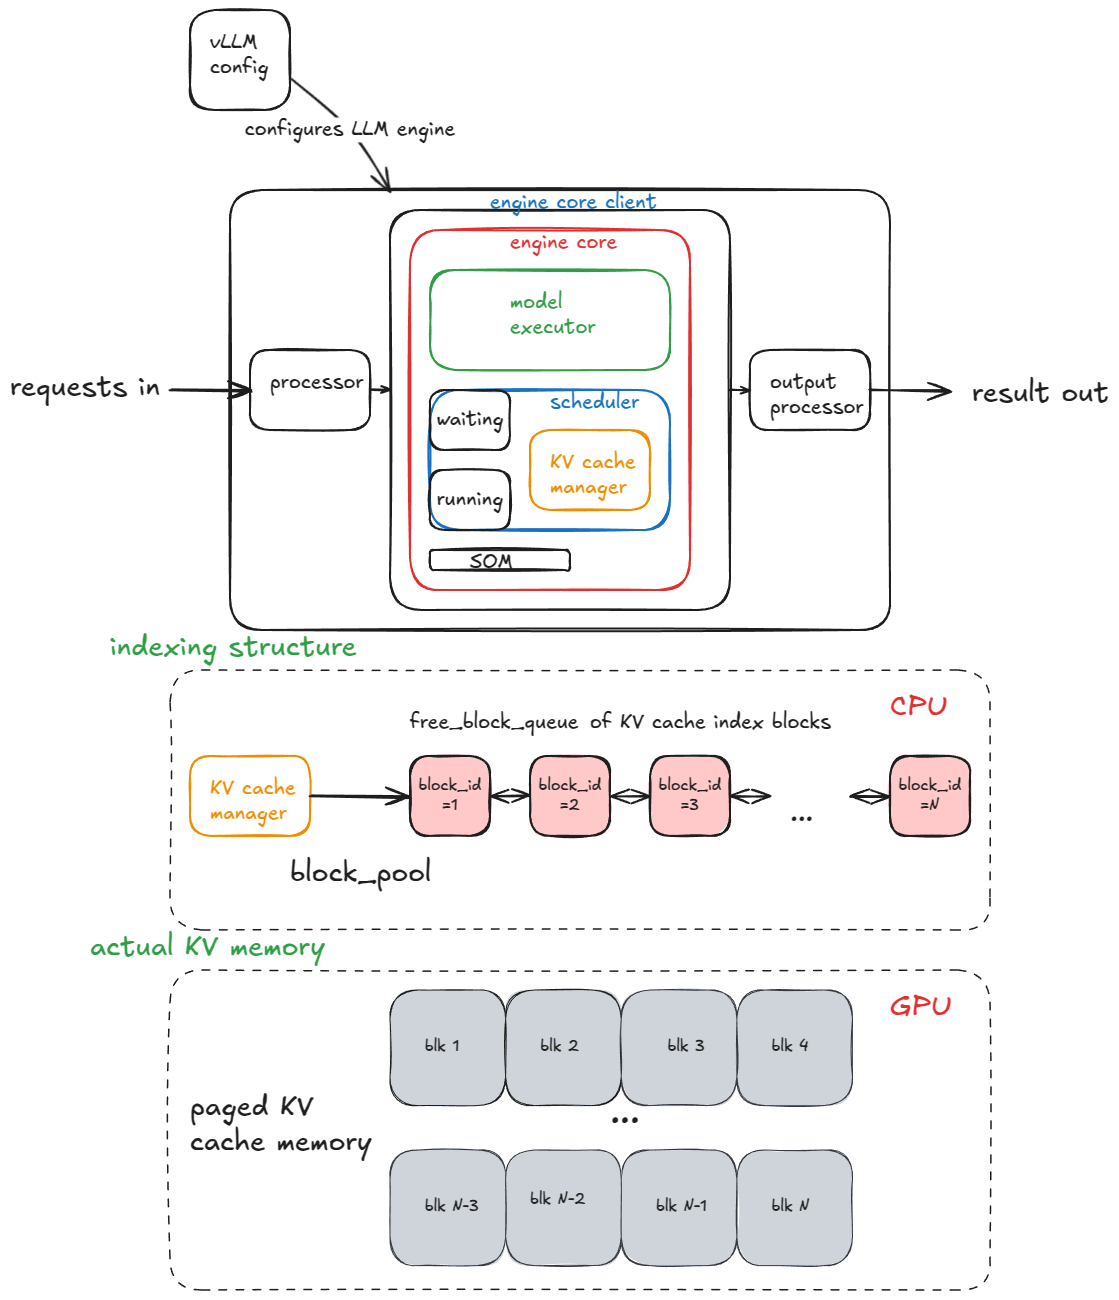
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.