vLLM destrincha como funciona a inferência LLM de alta vazão
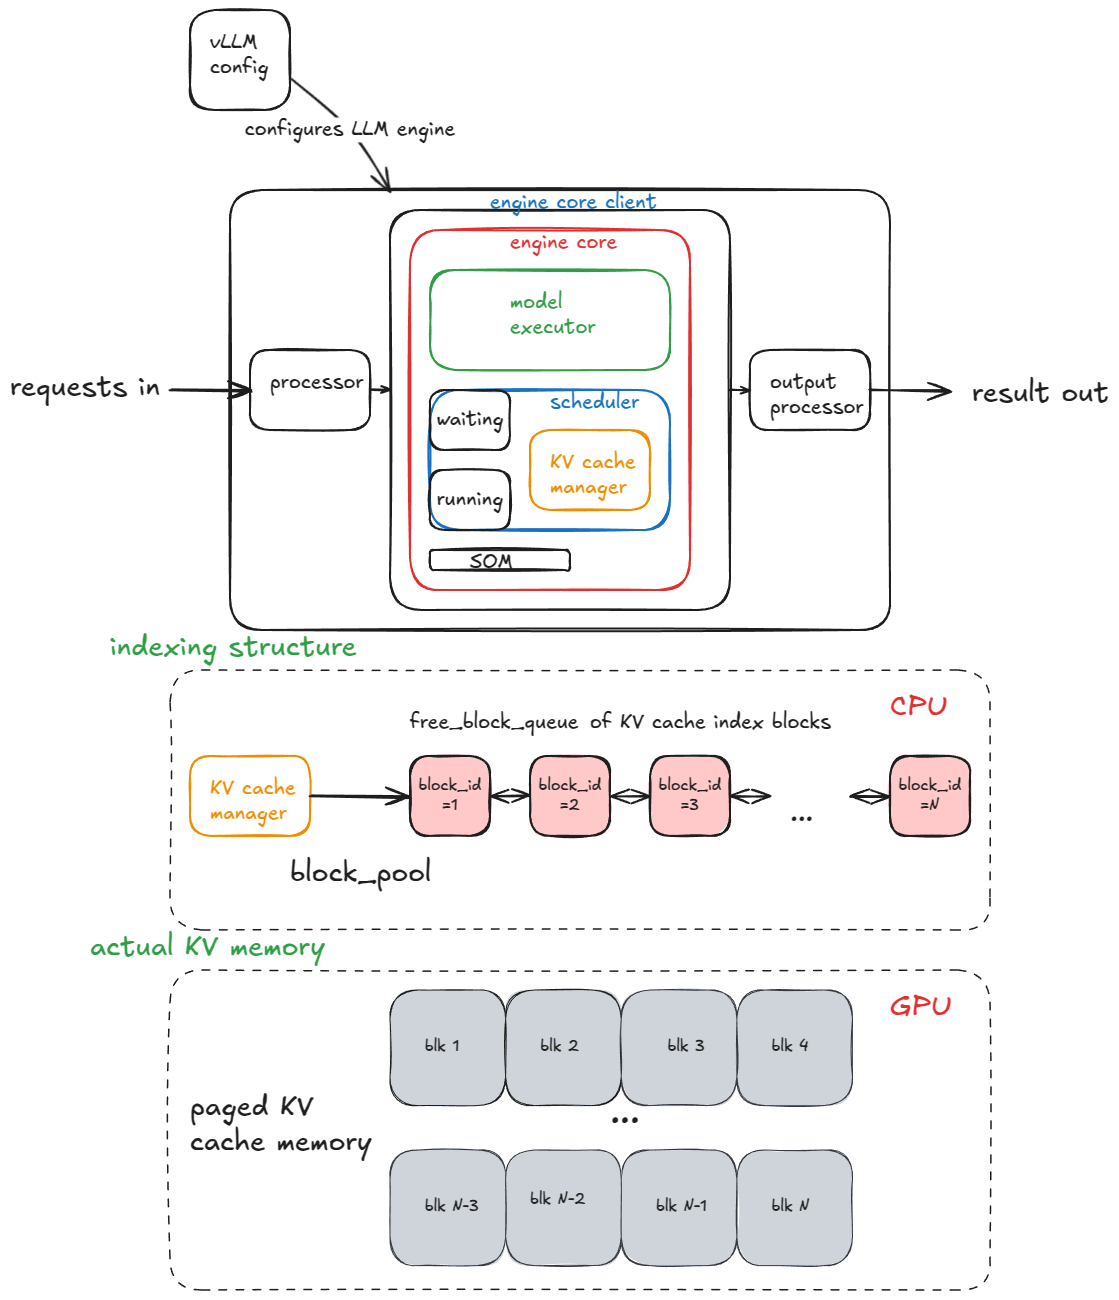
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.
Hacker News
O texto acima é um resumo reescrito. A apuração, o texto integral e os créditos são da fonte — abra o original para ler na íntegra.
Ler matéria original ↗Resumo gerado por IA a partir da matéria original e revisto pelo método descrito em como funciona a curadoria. Em caso de divergência, vale o texto da fonte. Achou um erro? Fale com a gente.