14 resultados para custos de inferência
Segunda · 12 out
2026-10-12
2 matérias
IA
Pesquisa · IA
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
#InteligenciaArtificial · #IAagente · #InfraestruturaDeTI · #GPUs · #CPUs · #ArquiteturaDeComputadores · #APIs
IA
Pesquisa · IA
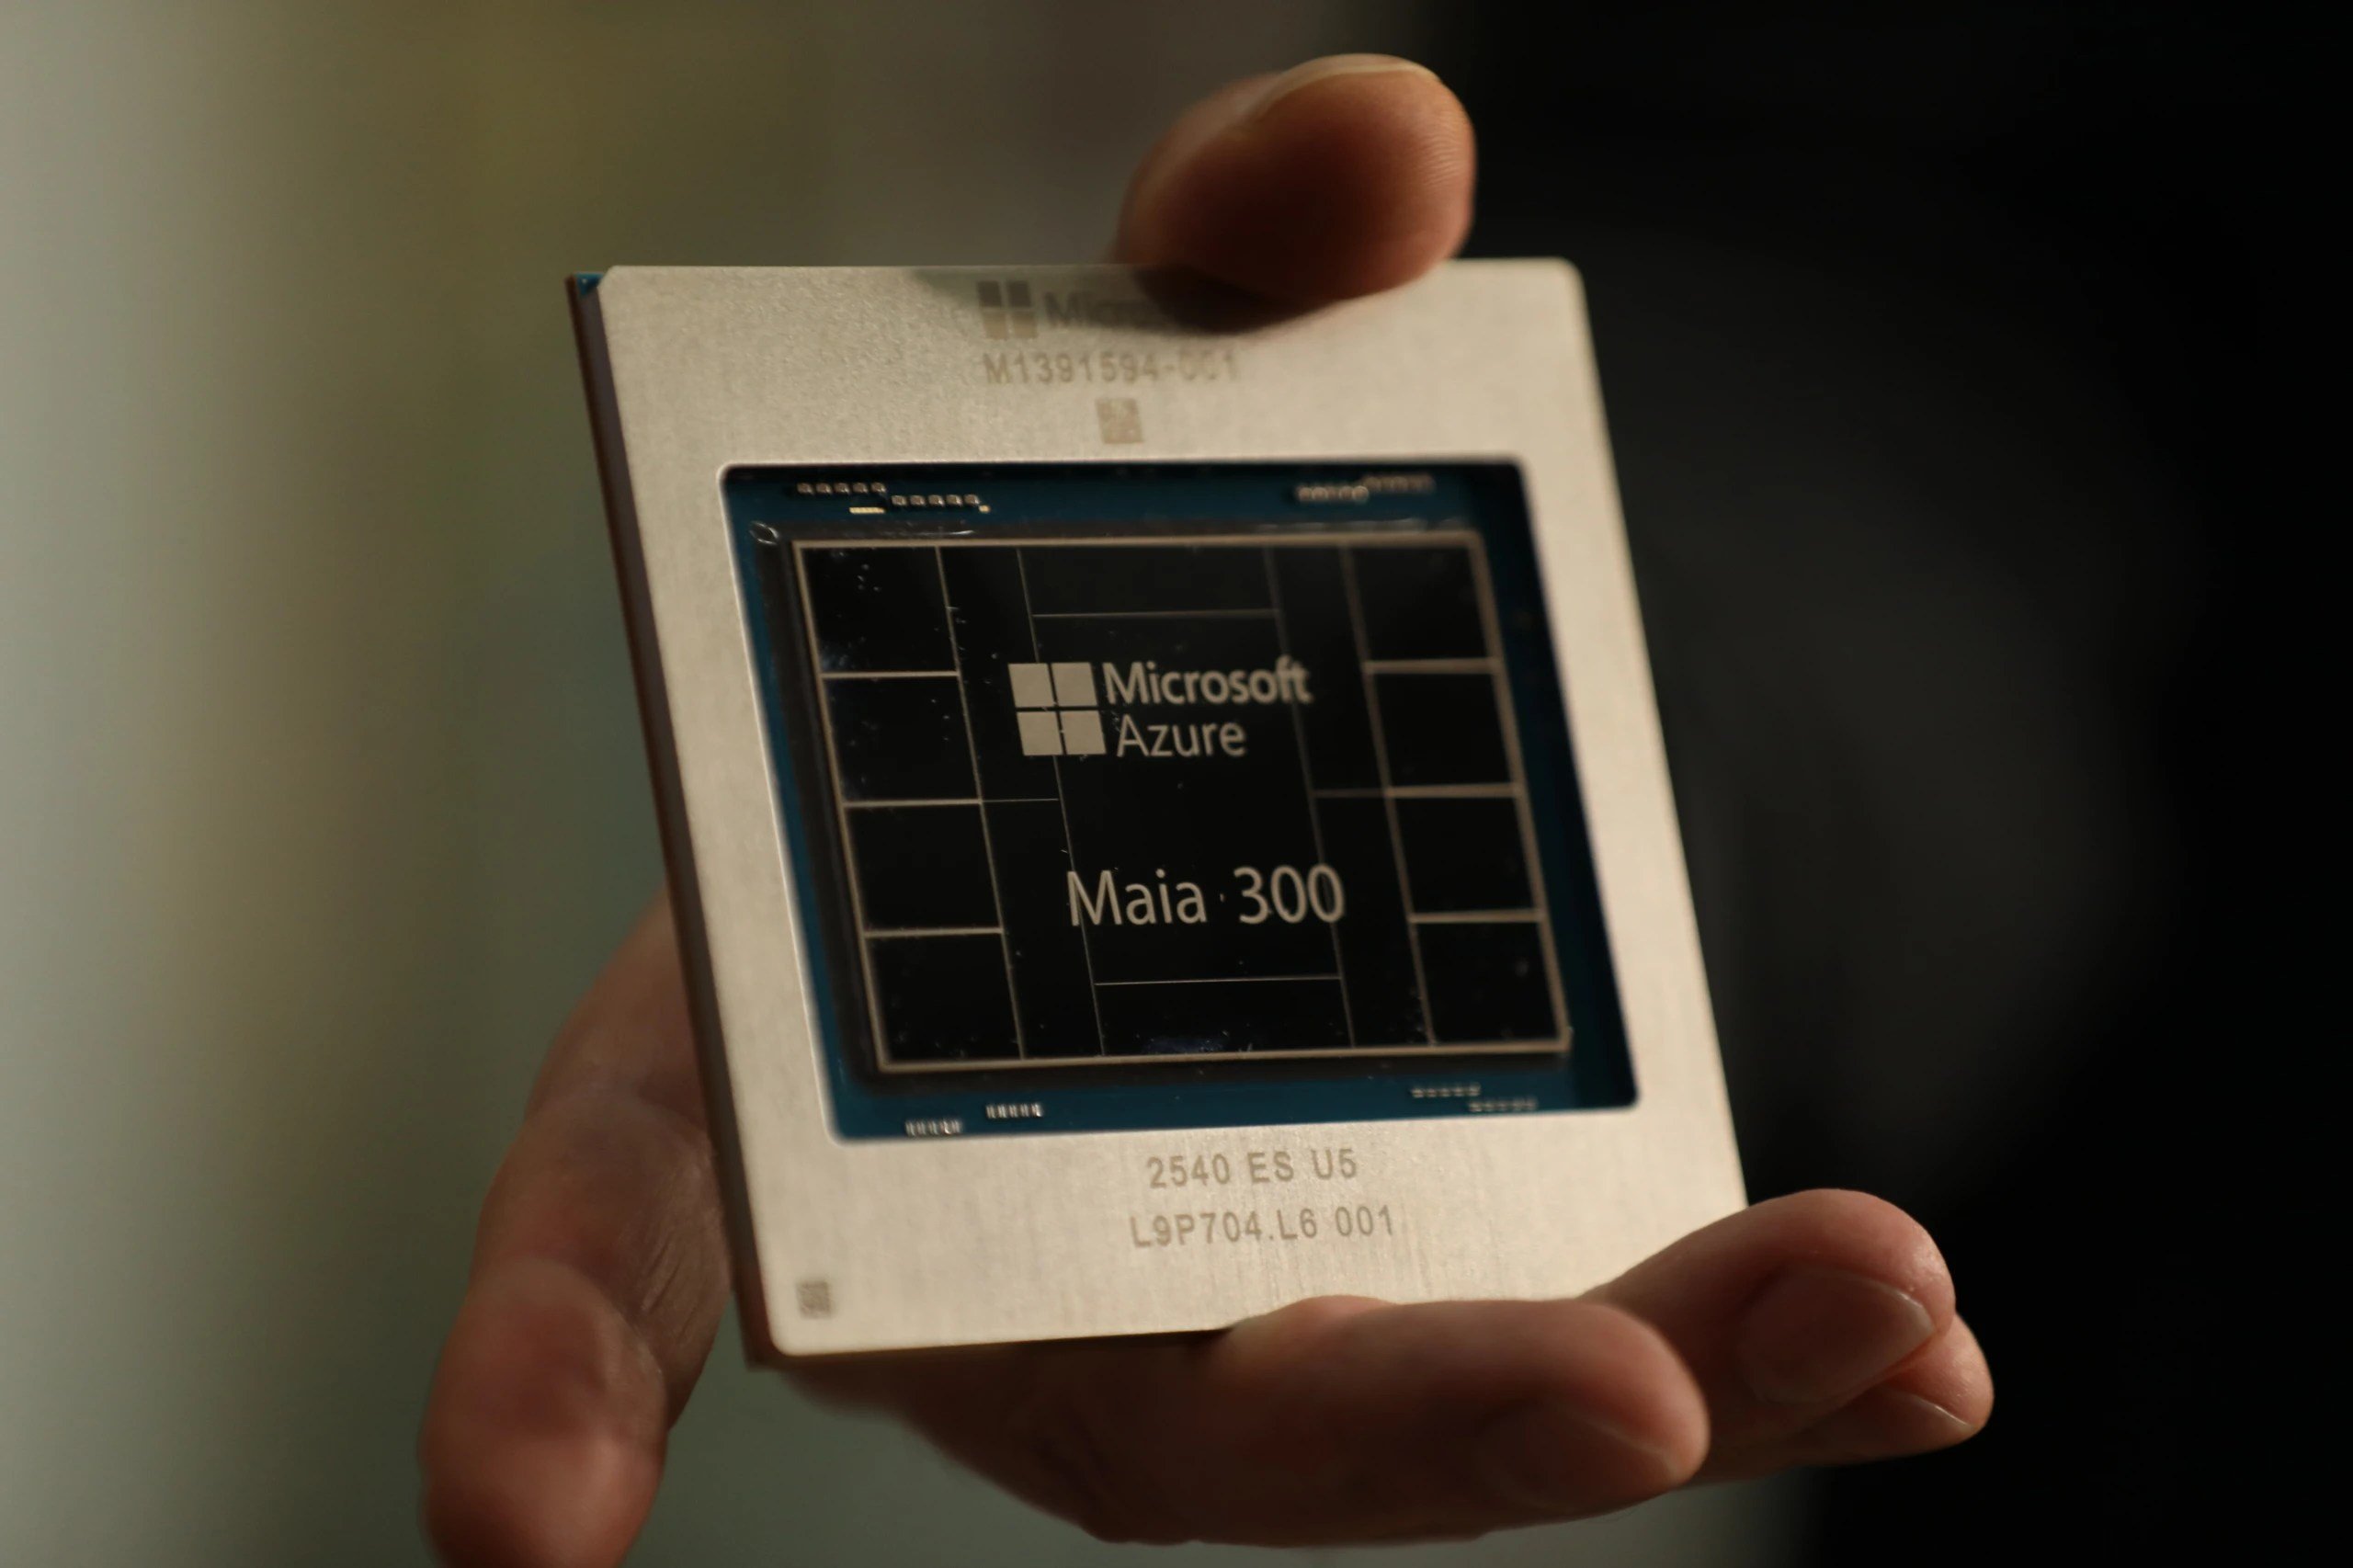
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
#InteligenciaArtificial · #IA · #Microsoft · #Azure · #ChipDeIA · #AgentesDeIA
Quarta · 23 set
2026-09-23
1 matéria
Eng · Dev com IA

Engenharia · Software com IA
A OpenAI lançou o GPT-6 Sol e o GPT-6 Luna com preços de tokens reduzidos: a empresa cortou em 50% o custo de entrada em relação aos equivalentes do GPT-5.6, e a Luna teve 58% de queda nos tokens de saída. Os novos modelos também buscam ficar mais próximos do alinhamento do GPT-6 Astra, embora ainda não alcancem o modelo principal.
Além da redução de preços, a OpenAI destaca melhorias em caching e inferência para baixar ainda mais os custos no uso via API. O GPT-6 Sol e o Luna vêm com maior taxa de acerto de cache por padrão, permitem preservar contexto anterior mesmo com mudanças em esforço de raciocínio e disponibilidade de ferramentas e incluem um Prompt Caching Dashboard para monitorar e diagnosticar o desempenho do caching, com desconto de 90% para leituras de tokens de entrada em cache.
#InteligenciaArtificial · #IAgenerativa · #OpenAI · #PromptCaching · #LLM · #DesenvolvimentoDeSoftware · #AgentesDeIA
Segunda · 14 set
2026-09-14
1 matéria
IA
Destaque

Pesquisa · IA
A Samsung investiu na startup holandesa de chips de IA Euclyd, que busca criar uma alternativa às GPUs da Nvidia. A empresa levantou US$ 231 milhões (R$ 1,2 bilhão) na rodada Série A, de 200 milhões de euros, liderada pela própria Samsung e por investidores como Somerset Capital Partners, Scaleup Europe Fund (EQT) e Innovation Industries.
Fundada em 2024, a Euclyd desenvolve chips para inferência de IA, usando modelos já treinados para executar tarefas. A arquitetura proposta difere das GPUs por envolver processador e arquitetura de memória, com a promessa de reduzir energia e custos de data centers; a startup ainda não comprovou uso comercial em larga escala, mas pretende distribuir sistemas físicos a partir de 2028 e atender milhares de clientes corporativos até 2030.
#InteligenciaArtificial · #IA · #chipsdeIA · #GPUs · #dataCenters · #inferenciaIA · #semicondutores
Sábado · 05 set
2026-09-05
1 matéria
IA
Pesquisa · IA
Meryem Arik, cofundadora da Doubleword e especialista em inference de alta vazão, apresentou no QConAI 2030 uma série de previsões sobre o que empresas vão priorizar até 2030. Ela citou que, após o lançamento do ChatGPT, já havia alertado em 2021 sobre a “crise” de hardware para inferência e disse que a evolução do mercado confirmou parte do cenário.
No painel, Arik destacou que o gasto com tokens e os custos de inferência estão virando um problema mais imediato para organizações, citando exemplos como o consumo de créditos do Claude por uma empresa não identificada e a aceleração de despesas de TI em bancos. Ela também mencionou dados da Deloitte, segundo os quais 23% das empresas dizem usar agentic AI ao menos moderadamente, e discutiu a ideia de que laboratórios de IA estariam subsidiando tokens, defendendo que a tendência observada é de tokens mais baratos.
#InteligenciaArtificial · #IA · #Tokens · #Inferencia · #AgenticAI · #QConAI · #InfraestruturaDeIA
Quarta · 02 set
2026-09-02
1 matéria
IA
Pesquisa · IA
A experiência de pesquisadores que saem da teoria para aplicações no mundo real ganhou um novo impulso com o MIT-IBM Computing Research Lab, que conecta ex-alunos do MIT e um ex-postdoc hoje na IBM. Entre os temas trabalhados estão quantum machine learning, reinforcement learning e agentes de IA, além de foco em IA confiável e justa.
Na IBM, Zhang-Wei Hong desenvolveu técnicas para dar mais contexto e feedback de recompensa a agentes, aplicando ideias em robótica, LLMs e reinforcement learning para ciência. Irene Ko, por sua vez, trabalha em métodos para acessar sinais internos do modelo durante a inferência com o vLLM Hook, usando essas informações para analisar riscos como prompt-injection e alucinação, com uma proposta de plugin leve para reduzir custos.
#InteligenciaArtificial · #IA · #AgentesDeIA · #ReinforcementLearning · #LLMs · #IAConfiavel · #vLLM
Terça · 01 set
2026-09-01
1 matéria
IA
Destaque
Pesquisa · IA
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
#InteligenciaArtificial · #IA · #LLM · #InferenciaDeLLM · #Quantizacao · #Latencia · #Throughput
Segunda · 24 ago
2026-08-24
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A JetBrains lançou o Junie Local, uma versão gratuita do agente de codificação Junie para rodar inteiramente na máquina do desenvolvedor, sem depender de modelos em nuvem. A proposta é manter o código local, evitar custos por requisição de API e permitir trabalho em ambientes sem internet.
O Junie Local faz o download do modelo e do motor de inferência ao executar /local, inicia um servidor local e troca o agente automaticamente. Ele usa o Qwen3.6-27B em 4-bit e exige macOS 26, pelo menos 64 GB de memória unificada e um Apple M5 (ou mais recente), com cerca de 20 GB de downloads; a JetBrains afirma que esse requisito alto é o custo para rodar um modelo de 27B com boa qualidade hoje.
#InteligenciaArtificial · #IA · #DesenvolvimentoDeSoftware · #AgentesDeIA · #Programacao · #JetBrains · #ModelosLocais
Sexta · 14 ago
2026-08-14
1 matéria
IA
Pesquisa · IA
O Claude Code orienta como maximizar o valor de cada sessão para gastar menos tokens e evitar desperdício de contexto. A recomendação inclui limpar o histórico entre tarefas, iniciar novas sessões para reduzir contexto irrelevante e usar o prompt cache com atenção, já que ele expira após uma hora.
O texto detalha como a cobrança por token reflete o tempo de inferência e que tokens de saída custam cerca de 5x mais que tokens de entrada, além de explicar o papel do esforço (/effort) e do MAX_THINKING_TOKENS para controlar o quanto o modelo “pensa”. Também é mostrado que o prompt caching só funciona quando o início do pedido é idêntico ao que o servidor acabou de receber, evitando picos de custo ao manter a estrutura das requisições.
#InteligenciaArtificial · #IA · #ClaudeCode · #promptcache · #LLM · #tokeneconomy
Sexta · 07 ago
2026-08-07
2 matérias
IA
Destaque
Pesquisa · IA
A DeepSeek avisou clientes que vai reajustar os preços de todos os serviços de API em breve, com aumento considerado “relativamente grande” pela própria empresa, segundo a Bloomberg. O comunicado não traz percentuais e diz que o novo esquema será divulgado separadamente, sem data para entrar em vigor. Hoje, o V4 Flash custa US$ 0,14 por milhão de tokens de entrada e US$ 0,28 por milhão de tokens de saída, valores bem abaixo de concorrentes como Moonshot, Anthropic e Google.
O reajuste pode reduzir a vantagem de custo-benefício que ajudou a DeepSeek a pressionar rivais a baratear ofertas. A mudança também ocorre em meio a testes públicos do V4 Flash e a expectativas de lançamento do V4 Pro, além de um plano reportado de construir um data center de grande porte na Mongólia Interior para garantir capacidade de processamento. Para devs e empresas que consomem APIs, a tendência é repensar custos de inferência e projeções de uso conforme a nova tabela chegar.
#DeepSeek · #APIs de IA · #LLMs · #custos de inferência · #data center · #AI pricing
IA
Pesquisa · IA
Especialistas defendem que o Brasil não precisa necessariamente vencer a corrida por chips, modelos e data centers para capturar ganhos com IA. Paulo Ernani, diretor de operações da AVEX AI Lab, afirma que o maior risco para empresas brasileiras é a demora em adotar a tecnologia, já que ganhos de produtividade podem surgir mesmo usando ferramentas disponíveis. Ele também destaca que a disputa atual concentra capital na infraestrutura de grandes players como Amazon, Alphabet, Meta e Microsoft.
A leitura é que o valor tende a migrar para quem aplica IA para automatizar atendimento, processos comerciais e operações, reduzindo custos e ampliando receitas. Com a guerra de preços entre infraestrutura e modelos e a queda do custo de inferência, empresas usuárias podem se beneficiar ainda mais em cenários de correção do mercado. No Brasil, o país também tenta atrair data centers, mas a aposta mais decisiva, segundo Ernani, é aprender a usar IA antes dos concorrentes.
#inteligenciaartificial · #IAgenerativa · #data centers · #custo de inferencia · #automacao · #produtividade
Quinta · 06 ago
2026-08-06
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
AMD, Supermicro e Spectro Cloud anunciaram o AMD Instinct Coder, uma solução “turnkey” para escalar o desenvolvimento de software com assistência de IA em ambientes corporativos. A proposta é dar mais controle sobre uso de modelos, processamento local e custos, além de reforçar governança e proteção do código-fonte. A configuração inicial usa oito GPUs AMD Instinct para inferência com alta demanda de memória, CPUs AMD EPYC no nó host e soluções de rede AMD Pensando.
Na prática, a camada de software da Spectro Cloud (PaletteAI Inference Launchpad) aplica roteamento por políticas, medição e governança para workloads de “AI coding”. Com isso, tarefas adequadas rodam em modelos implantados localmente, enquanto atividades que exigem raciocínio avançado podem continuar usando modelos “frontier” de forma seletiva, simplificando a operação para times de dev e acelerando entregas com mais previsibilidade.
#AI coding · #enterprise AI · #LLM · #on-premise · #MLOps · #inference
Terça · 04 ago
2026-08-04
2 matérias
IA

Pesquisa · IA
A OpenAI anunciou uma atualização de pesquisa sobre o Astra, seu modelo de “frontier reasoning”, dizendo que uma versão interna conseguiu produzir provas verificadas por máquina para 10 problemas antigos de matemática e ciência da computação teórica. A empresa estimou que o consumo de tokens para esse tipo de raciocínio ficou em torno de US$ 2.000, usando uma referência de preços da API do GPT-5.6 Sol. Apesar do avanço, os resultados ainda precisam passar por revisão de matemáticos humanos.
O ponto que mais muda para times tech é a possibilidade de tratar “raciocínio” como um orçamento de inferência, ajudando a planejar experimentos e a decidir quanto vale tentar resolver uma conjectura. Se esse acesso via API se concretizar, universidades e laboratórios menores podem comparar custos de execução e testar hipóteses sem depender de construir infraestrutura própria.
#OpenAI · #Astra · #AI reasoning · #provas matemáticas · #theoretical computer science · #API · #tokens
IA

Pesquisa · IA
A Runware, empresa de infraestrutura para IA, anunciou o Sonic Inference Pod: um data center modular e transportável para rodar inferência. A proposta é permitir expansão rápida criando novos “pods” em vez de ampliar uma instalação fixa, com foco em reduzir custo e manter qualidade de inferência acima de alternativas como plataformas serverless e GPU clouds.
Segundo a empresa, os pods podem ser implantados onde houver energia e usam resfriamento em circuito fechado (sem uso de água), com montagem em dias — enquanto data centers tradicionais podem levar meses ou anos. A Runware informou que já tem 10 pods em operação nos EUA, Europa e Ásia-Pacífico, atende clientes como Higgsfield AI e Wix e afirma ter 160 sites disponíveis para suportar a capacidade.
A notícia ganha força num cenário de corrida por capacidade de IA, com grandes players construindo data centers em larga escala. Para o público dev/tech, a mudança pode acelerar entregas de inferência com mais flexibilidade de capacidade e potencialmente reduzir pressão sobre infraestrutura local (como água e custos de utilidades), influenciando como modelos passam a ser servidos em produção.
#infraestruturaIA · #dataCenters · #inferencia · #GPUcloud · #edgecompute · #AIinfrastructure