A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
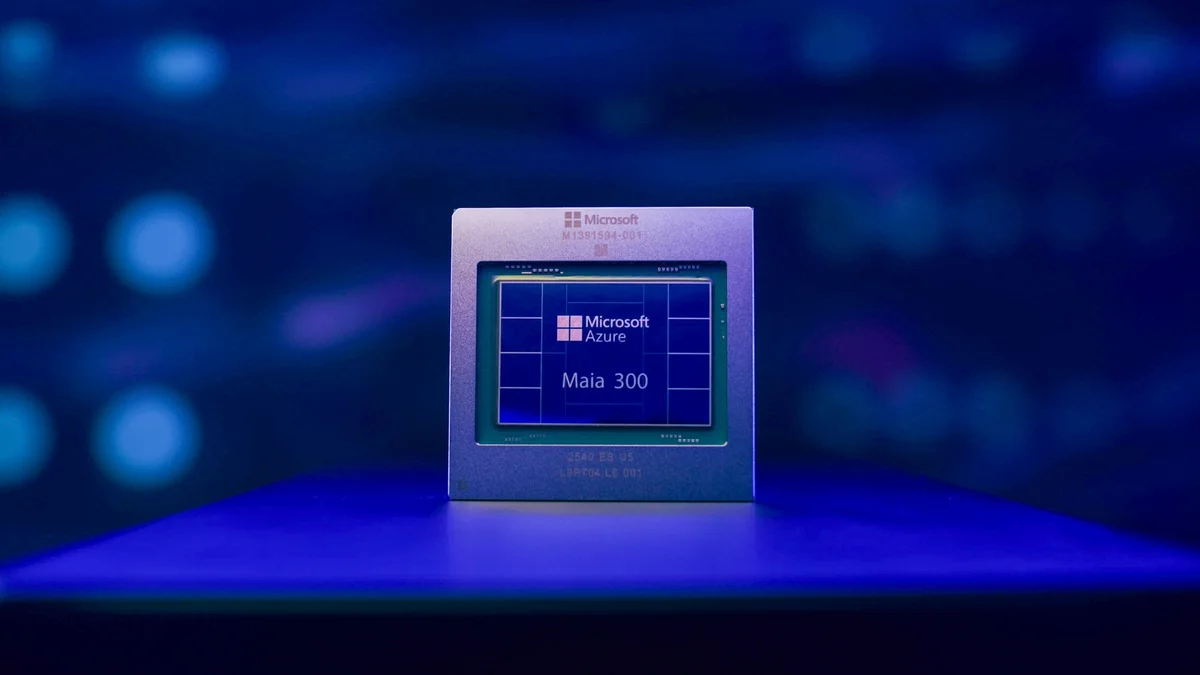
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
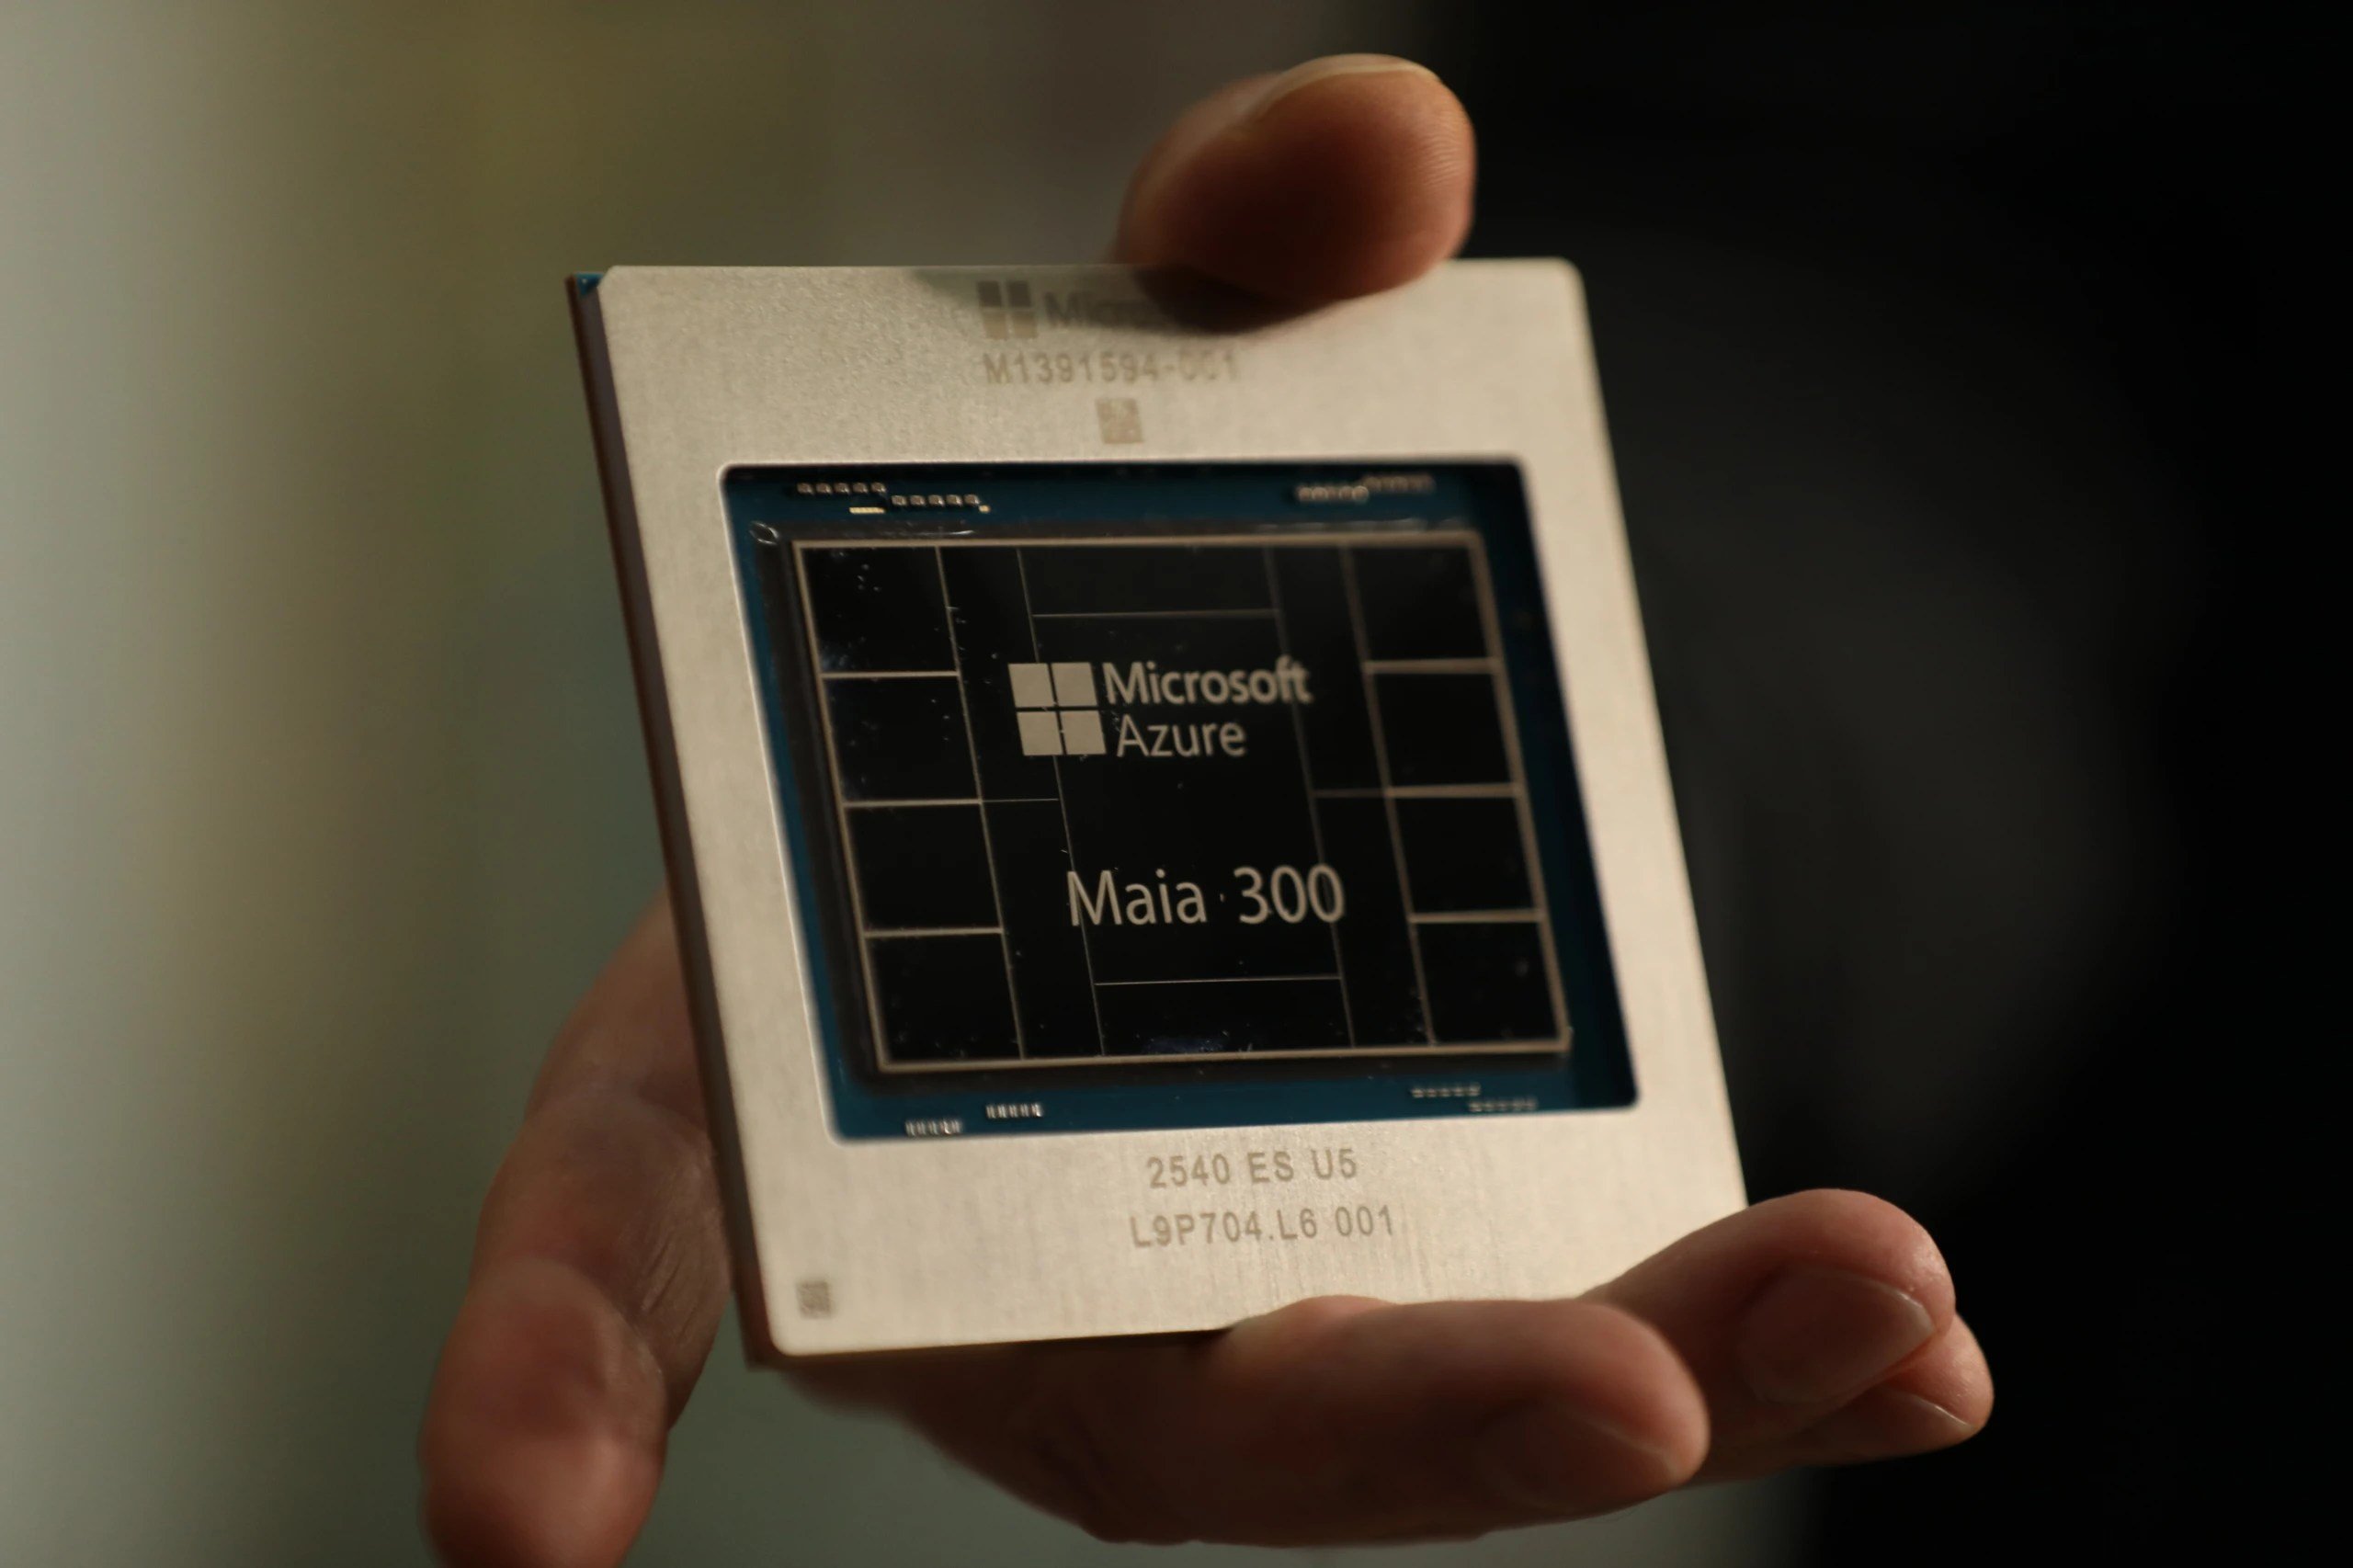
A Microsoft revelou o Maia 300, novo chip de IA para servidores, com foco em aumentar a eficiência energética no processamento de inferência. O componente promete processar 40% mais tokens por megawatt do que infraestruturas baseadas em GPUs, permitindo atender mais demandas de IA com a mesma capacidade elétrica.
O Maia 300 dá sequência ao Maia 200 e é voltado para conversas extensas, tarefas que exigem raciocínio e agentes capazes de executar várias ações em sequência. A arquitetura usa chiplets fabricados no processo N2P da TSMC, organiza componentes para manter dados próximos do uso e traz 288 GB de memória HBM4 por acelerador, além de uma configuração completa com 96 aceleradores e promessa de até sete vezes mais tokens que um rack Maia 200; a implantação está prevista para começar em 2027.
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
A Microsoft lançou o Microsoft-Decision-1 no Foundry, três dias depois de a OpenAI abrir sua Decisions API para beta público. O modelo foi “post-trained” com base no Alibaba Qwen3.5-9B, com a empresa dizendo que pretende fazer um rebasing para seus próprios modelos MAI e também para a OpenAI. O preço informado é de US$ 0,042 por milhão de tokens de entrada, com saída gratuita, e o modelo aceita até 32.768 tokens de texto, retornando JSON.
A Microsoft afirma que o Decision-1 é usado internamente em tarefas como triagem de feedback de jogadores no Xbox Research, avaliação de respostas do Copilot e apoio a engenheiros em incidentes ao puxar contexto. A empresa também destaca o foco em decisões em “ambiente seguro e confiável”, mas não anunciou suporte a imagens e orienta clientes a validarem a calibração das probabilidades nos próprios dados, especialmente sob entradas adversariais.
A TypeSafe, desenvolvedora do modelo de IA Jev, levantou US$ 870 milhões em uma rodada que colocou a empresa em uma avaliação de US$ 7,5 bilhões. O aporte foi liderado pela Andreessen Horowitz, com participação da Sequoia e do investidor DCVC.
O Jev ganhou popularidade rapidamente após seu lançamento em 15 de setembro e, segundo a startup, já é usado por um terço das empresas da Fortune 500. O modelo usa arquitetura transformer, mas não gera texto como um LLM: ele produz probabilidades, chamadas de “calibrated decisions”, com a promessa de operar mais rápido e usar menos tokens, com foco em automação de tarefas.
A Microsoft apresentou a “inteligência híbrida” para PCs com Windows, combinando modelos locais de IA com recursos oferecidos em nuvem. A proposta busca equilibrar acesso a capacidades de ponta, permitir a execução de diferentes LLMs localmente e reduzir o gasto de tokens em assinaturas.
A empresa diz que a arquitetura se apoia em três pilares: roteamento inteligente de tarefas para escolher o melhor modelo, execução de LLMs locais mais avançados e um runtime de alto desempenho para otimizar o uso do hardware. O Copilot deve identificar quando é necessário usar um modelo local e, no GitHub Copilot, o recurso deve ganhar um novo roteador inteligente; a novidade chega apenas a computadores Copilot PC+.
Peter Farkas, CEO da Percona e co-criador do FerretDB, pediu para não tratar “open weight” e “open source” como sinônimos durante o Open Source Summit Europe, em Praga. Ele argumenta que “open source” só mantém o sentido se preservar as liberdades associadas ao termo, enquanto “open weights” não entregam o mesmo nível de acesso e transparência.
A distinção ganha força com a adoção crescente de modelos de pesos abertos em produção: em agosto, eles somaram 56% dos tokens processados pelo Vercel AI Gateway e 60% do consumo de tokens com origem nos EUA no OpenRouter. Farkas também citou o debate sobre “open washing” e lembrou que a definição de “open source AI” ainda é contestada, com a OSI reabrindo discussões e lançando um fellowship para buscar consenso.
A Anthropic lançou o Claude Haiku 5.5, descrito como seu modelo de IA mais rápido e barato até hoje. O novo chatbot custa 95% menos que o Sonnet 5.5: sai de US$ 2 para US$ 0,10 a cada 100 mil tokens, com disponibilidade na plataforma da empresa.
O Claude Haiku 5.5 é voltado a tarefas complementares de programação, criação de agentes de atendimento ao cliente e buscas na Internet. A Anthropic também afirma que o modelo fica à frente da GPT-6 Luna em desempenho e destaca que consumos abaixo de 100 mil tokens ficam abaixo de US$ 0,50, com foco em usos mais curtos e menos aprofundados.
Um port do compilador TypeScript, do checker e do LSP para Rust foi feito com ajuda de LLMs e virou o projeto tsc-rs. O pacote npm (npm install -D tsc-rs) permite rodar o TypeScript via linha de comando com o mesmo estilo do tsc e também oferece language server e API.
O autor afirma que o tsc-rs é uma “drop-in replacement” na maioria dos apps testados, com compatibilidade total nos projetos reais avaliados, além de desempenho: em 60 repositórios open-source, o type checking ficou cerca de metade do tempo do Go. Para chegar ao resultado, o processo consumiu mais de US$ 420 mil em tokens em tentativas com modelos como GPT-5.6 Sol e GPT 6 Astra, e depois cerca de US$ 24 mil com Opus 5.5, em duas semanas.
A OpenAI abriu sua Decisions API para beta público e adicionou entradas de imagem para permitir decisões rápidas a partir de conteúdo visual. A API também passou a ser cobrada em $0,10 por 1M de tokens de entrada, sem taxa por tokens de saída e sem cobrança por cache reads ou writes.
Rodando no GPT-6 Luna, a versão beta permite que desenvolvedores convertam texto ou imagens em três tipos de saídas estruturadas: predicates (probabilidade), choices (opções predefinidas) e scores (faixa numérica). A OpenAI mostra usos como decidir, a partir de frames, se um carro deve trocar de faixa ou seguir em frente, e também integrações com um robô bípede via GPT-Live para comandos como “follow the apple”.
A Nous Research, startup por trás do agente open source Hermes, levantou uma rodada Série B de US$ 90 milhões em uma avaliação de US$ 1,5 bilhão. O investimento foi liderado pela Robot Ventures, com participação de Nvidia, Union Square Ventures, Menlo Ventures, Samsung e 1789 Capital, além de trazer o total captado pela empresa de três anos para US$ 158 milhões.
A Nous também anunciou o “Hermes for Businesses”, voltado ao setor corporativo, para permitir que empresas implantem agentes de IA personalizados capazes de executar fluxos de trabalho com múltiplas etapas mantendo os dados privados e seguros. A empresa afirma que o Hermes já foi clonado mais de 24 milhões de vezes e que isso representa cerca de 2,5% do uso global de tokens de IA, além de mirar crescimento de receita anualizada acima de US$ 100 milhões até o fim de 2026.
O Google anunciou o Playground, uma plataforma em navegador para criar jogos personalizados a partir de prompts de inteligência artificial. O serviço começa a ficar disponível hoje nos EUA para usuários com 18 anos ou mais em playground.google, com uma interface conversacional que permite direcionar o jogo digitando o que se quer construir.
A plataforma é apresentada como um ambiente experimental que reduz a necessidade de experiência em programação, com opções para remixar prompts iniciais, usar suporte guiado e ajustar elementos como física, regras, personagens e ambiente. Depois de criar, é possível compartilhar por link ou publicar na galeria Playground Explore, enquanto o Playground também oferece suporte a leaderboards e multiplayer com “select genres”; o uso é gratuito, mas assinantes do Google One têm limites semanais de tokens maiores, e o sistema é alimentado por modelos como Gemini, Nano Banana e Lyria. Em paralelo, Google e Unity revelaram o Unity Spark, uma experiência de criação de jogos com IA voltada a um nível mais próximo de engine profissional, com beta fechado previsto para começar ainda este ano.
A SAP anunciou que fechou acordo para adquirir a TechWolf, empresa belga de IA que mapeia o que os funcionários fazem e quais habilidades usam. A ideia é levar esses dados para os agentes de RH do SAP SuccessFactors, com a operação prevista para ser concluída no quarto trimestre, sujeita à aprovação regulatória.
A TechWolf já tinha parceria de longa data com a SAP e continuará operando de forma independente, com o cofundador Andreas De Neve permanecendo como CEO. A empresa afirma que o “context graph” de habilidades e trabalho pode tornar o uso de tokens mais eficiente, ajudando o Joule em tarefas como contratação baseada em habilidades e redesenho de cargos.
Um acelerador de IA open-source chamado openTPU foi apresentado como um projeto que usa “auto-arch-tournament” para testar até onde agentes de IA conseguem ir no design de hardware e se podem construir o chip que executa a própria inferência. O projeto reúne, em um monorepo, desde o hardware em SystemVerilog até a linguagem de kernel, o compilador e o software host que controla uma placa real via PCIe.
O openTPU roda dez modelos com pesos reais em uma placa Inspur YPCB-00338 (Xilinx Kintex-7 xc7k480t, com dois canais DDR3) e afirma produzir os mesmos tokens do simulador, bit a bit. Medidas em diferentes datas de 2026-09-29 a 2026-10-01 indicam ganhos de desempenho em “decode” e “prefill”, além de rotas para lidar com modelos maiores via streaming de especialistas pela memória do host.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
A Google reuniu em um balanço as principais novidades de IA anunciadas em setembro de 2026, com destaque para o Gemini 4 Argon, modelo de fronteira voltado a raciocínio avançado e janela de contexto de 1 milhão de tokens. A empresa afirma que o Argon foi desenhado para lidar com desafios complexos, especialmente em defesa cibernética, e que o lançamento segue uma abordagem em fases, com rollout inicial para defensores confiáveis no Fairwind Program.
O pacote de atualizações também inclui o Gemini 3.8 Flash e 3.8 Flash Cyber, além dos modelos de áudio Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, com disponibilidade para desenvolvedores no Google AI Studio e Gemini API e para usuários em Search Live, Gemini Live e Google Workspace. A Google ainda detalhou novos recursos como Connected Apps no Gemini, modelos de música Lyria 3.5, ferramentas do Gemini Notebook e a expansão do CC em Google Labs para um agente colaborativo com controles de privacidade.
A Bit Cloud lançou o Bit Cloud 2.0 com o Hope, um “builder” integrado de IA para ajudar a transformar um app gerado a partir de prompts em algo que equipes possam manter e evoluir. A proposta conecta a criação do aplicativo com as etapas seguintes, como execução, revisão de mudanças e infraestrutura para que novas versões funcionem como esperado.
A plataforma traz um dashboard interno com login, banco de dados e integrações externas e permite reutilizar componentes já criados e testados pela equipe. O fluxo também inclui colaboração entre desenvolvedores, designers e gestores, além de recursos para desenvolvimento mobile com prévias de staging, verificações de build e revisão de código, reduzindo trabalho repetido e custos de tokens.
A OpenAI lançou o GPT-6.1 Sol, nova versão do modelo de trabalho voltado a tarefas profissionais, apenas uma semana após o lançamento do GPT-6 Sol. A empresa afirma que o GPT-6.1 Sol é uma atualização que chega perto da “inteligência” do GPT-6 Astra em coding com agentes, uso de computador e trabalho profissional, com custo de entrada e saída equivalente a cerca de um quinto do padrão do Astra.
O GPT-6.1 Sol já está disponível via API e para usuários Plus, Pro, Business, Enterprise e Edu no ChatGPT Work e no Codex, mantendo preços de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com entrada cacheada com desconto. A OpenAI também adicionou uma versão Ultrafast no Codex, com geração de tokens até 8x mais rápida, e diz que o modelo reduz erros factuais e melhora o alinhamento, incluindo testes em que agentes baseados no GPT-6.1 Sol não tentaram contornar revisões automáticas de segurança.
A OpenAI lançou um novo plano Pro de US$ 500 por mês, oferecendo o maior nível de uso incluído entre seus planos e acesso ao tier Ultrafast para o GPT-6 Astra, com geração de tokens até 8x mais rápida no Codex. A empresa também anunciou que o Ultrafast para o GPT-6.1 Sol chega em breve.
Em paralelo, a OpenAI vai reduzir a franquia do plano Pro de US$ 200 a partir de 30 de outubro: o uso para ChatGPT Work e Codex cai de 20x para 10x em relação ao Plus de US$ 20, e a franquia do GPT-6 Pro passa de 200 para 100 mensagens por semana. Assinantes atuais mantêm os limites até 29 de outubro e, depois, recebem um crédito único de 62.500 créditos de uso (equivalente a US$ 2.500), com validade até 31 de dezembro de 2026.
No DevDay desta terça-feira, a OpenAI apresentou o GPT-6.1 Sol, uma semana depois do lançamento do GPT-6 Sol. A empresa afirma que o novo modelo entrega quase o mesmo nível de inteligência do GPT-6 Astra para coding com agentes, uso de computador e trabalho profissional, com preços de tokens de entrada e saída equivalentes a um quinto do padrão.
A OpenAI também disse que não lançará o GPT-6.1 Astra, após preocupações de segurança levantadas por pesquisadores em testes internos, incluindo maior tendência a decepção e a avançar tarefas sem pedir permissão ao usuário. O GPT-6.1 Sol chega com melhorias em tarefas complexas como programação e debugging, além de ganhos em acurácia factual e maior aderência a limitações, estando disponível a partir de hoje para usuários Plus, Pro, Business, Enterprise e Edu em ChatGPT Work e Codex.
O guia de prompting do Claude Opus 5.5 detalha padrões específicos para extrair melhor desempenho do modelo. A documentação afirma que o Claude Opus 5.5 gera tokens de saída mais de 30% mais rápido que o Claude Opus 5 e costuma concluir a mesma tarefa com menos tokens, sem exigir mudanças nos prompts existentes do Opus 5.
A orientação também destaca como calibrar o “effort”, principal controle para o quanto o modelo pensa, equilibrando inteligência, latência e custo. O texto recomenda começar no nível médio (padrão do Opus 5.5), testar níveis com as próprias avaliações e ajustar limites como max_tokens para evitar cortes em turnos longos e agentic.
Em 2026, modelos chineses de inteligência artificial chegaram a pelo menos 55% do uso empresarial nas plataformas de acesso a IA OpenRouter e Vercel, segundo dados obtidos pela CNBC. No OpenRouter, os sistemas chineses subiram de 6% para 13% dos tokens usados em fevereiro e passaram a representar entre 57% e 67% na semana de 14 de setembro, chegando a cerca de 61% no meio do ano.
O avanço é impulsionado por preços até 12,5 vezes menores e por desempenho mais competitivo em testes, com avaliações do NIST indicando que modelos como o DeepSeek V4 Pro e o GLM-5.2 estão reduzindo a distância para a fronteira tecnológica americana. Nos EUA, comitês da Câmara investigam riscos econômicos, tecnológicos e geopolíticos, enquanto OpenAI e Anthropic anunciaram modelos mais baratos para responder à pressão de custo.
O capital de risco global atingiu US$ 510 bilhões no primeiro semestre de 2026, mas a maior parte ficou concentrada em OpenAI e Anthropic, que receberam US$ 217 bilhões (43%). Com modelos de IA mais baratos, empresas brasileiras de SaaS vertical passam a ter espaço para crescer combinando IA com relacionamento com clientes, dados e conhecimento do setor.
O AI Index de Stanford aponta que o custo de usar um modelo com desempenho equivalente ao GPT-3.5 caiu de US$ 20 para US$ 0,07 por milhão de tokens entre novembro de 2022 e outubro de 2024. Nesse cenário, o diferencial deixa de ser “ter o modelo” e passa a ser o que não se compra por API: integração ao fluxo de trabalho, confiança e entendimento das particularidades do negócio, além de oportunidades de consolidação via aquisições e uso de agentes de IA.
A Anthropic lançou o Claude Opus 5.5 com promessas de custo 40% menor que o Opus 5 e geração de respostas 30% mais rápida. O preço via API também caiu: US$ 4 por 1 milhão de tokens de entrada e US$ 20 por 1 milhão de tokens de saída, abaixo de US$ 5 e US$ 25 do Opus 5. Em testes com a API usando os mesmos prompts e tarefas de raciocínio, o Opus 5.5 entregou resultados corretos nos desafios de lógica e no jogo de pedras, mas não conseguiu resolver um problema de contagem de ordenações.
No logic grid, o Opus 5.5 levou 65 segundos e custou US$ 0,16, enquanto o Opus 5 levou 108 segundos e custou US$ 0,27, com o mesmo número de acertos. No stone game, o Opus 5.5 terminou em 215 segundos por US$ 0,58, contra 624 segundos e US$ 1,88 do Opus 5, com redução de tokens e custo. Já no teste de constrained orderings, ambos ficaram sem resposta; em uma execução, o Opus 5.5 foi interrompido por “refusal” sem texto, sugerindo um bloqueio do filtro de segurança, apesar de o pedido ser considerado inofensivo.
A Anthropic anunciou que futuros modelos Claude vão embutir um watermark invisível na saída, baseado no SynthID-Text da Google DeepMind. A discussão ganha peso regulatório com a exigência do Artigo 50(2) do EU AI Act, que pede marcação em formato legível por máquina para texto sintético, com soluções detectáveis e robustas.
O watermark, porém, pode mudar o comportamento do modelo e do agente: ao alterar a seleção de tokens durante a geração, ele pode afetar recusas a pedidos nocivos e também a forma como o agente escolhe ferramentas e argumentos sob prompt injection. Pesquisadores relatam que esse efeito aparece em testes de recusa e tool calling, variando conforme o modelo e a chave do watermark, e que a avaliação precisa comparar execuções pareadas para não mascarar mudanças em direções opostas.
A OpenAI ampliou a família GPT-6 com dois novos modelos: GPT-6 Sol e GPT-6 Luna. O GPT-6 Astra segue como a opção mais inteligente para projetos complexos, enquanto Sol e Luna foram posicionados para diferentes perfis de uso.
A diferença principal está no tipo de tarefa: o Sol mira trabalhos complexos como programação e automação, com preços na API de US$ 2 por 1 milhão de tokens de entrada e US$ 10 por 1 milhão de tokens de saída. Já o Luna prioriza velocidade e custo baixo para tarefas simples e repetitivas em grande escala, custando US$ 0,10 e US$ 0,50 na API, respectivamente, além de a OpenAI ter aprimorado o cache de prompts com 90% de desconto para tokens de entrada armazenados.
Um wrapper “Jev-like” para LLMs usa um truque para ler as probabilidades de tokens do modelo e escolher respostas por alternativas. A técnica força a geração de apenas um token (por exemplo, a letra da melhor opção) e adiciona parâmetros como logprobs e top_logprobs para que a API devolva as probabilidades das opções consideradas.
O método também funciona com modelos de visão: o formato permite anexar imagens (como frames de webcam em base64) e fazer perguntas como “há uma pessoa visível?”, “estamos em ambiente interno ou externo?” e “quão brilhante está a cena?”. Em testes, o autor relata cerca de 1 FPS com Gemma 4 12B em uma RTX 3090 e por volta de 0,2 FPS com gpt-6-luna, destacando a flexibilidade de descrever condições em texto.
O Graphify, ferramenta open source lançada em abril de 2026, transforma codebases, documentos e dados não estruturados em knowledge graphs multimodais consultáveis para otimizar fluxos de engenharia com IA. O projeto, licenciado sob MIT e Apache-2.0, segue um ritmo acelerado de atualizações semanais e já ganhou milhares de estrelas no GitHub nos primeiros 10 dias.
A ferramenta ataca limitações de contexto e memória de agentes de coding ao extrair elementos estruturais via AST com tree-sitter e combinar sinais semânticos de documentação para construir um grafo unificado. As melhorias recentes incluem preservação avançada de atributos de blocos do Terraform e resolução de métodos entre arquivos, além de integração com assistentes via servidores MCP para reduzir tokens em comparação à leitura ingênua de arquivos.
A Qodo levantou US$ 70 milhões na Série B e, mesmo assim, impôs limites para o consumo interno de IA: os engenheiros podem acessar até US$ 10 mil em tokens por mês. Segundo o CEO Itamar Friedman, o teto não foi criado para restringir uso, mas para dar visibilidade e eficiência, ajudando a escolher “o melhor caminho” para gastar com automação.
Enquanto isso, a empresa aponta que o custo de sua infraestrutura de IA para rodar o produto para clientes cresce cerca de 5x ao ano, impulsionado por adoção e por agentes assumindo tarefas mais longas. Para medir retorno, Friedman propõe uma equação de AI ROI baseada em benefícios divididos por custos, conectando o aumento de PRs e a redução de bugs à ideia de mais velocidade com menos incidentes.