Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
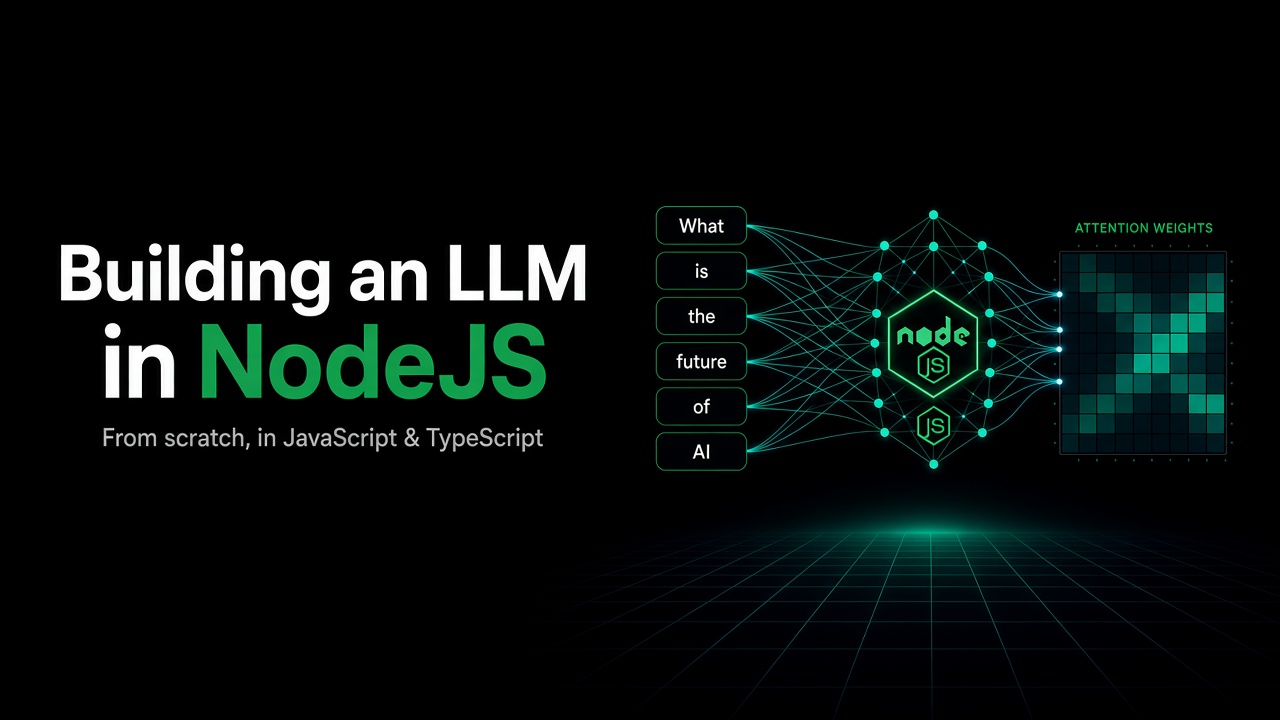
Um guia publicado no Hacker News propõe construir um large language model do zero, sem “black boxes”, passando por cada camada do sistema. O conteúdo reúne etapas como dataset, dataloader, mecanismos de atenção, blocos de Transformer, modelo GPT e o loop de treinamento, tudo construído capítulo a capítulo.
O material também inclui demos interativas com WebGPU ao vivo no playground node-llm, com pacotes embutidos ao longo do texto. A proposta é mostrar como os LLMs funcionam na prática, usando Node.js e TypeScript para tornar o processo executável.
A TypeSafe, desenvolvedora do modelo de IA Jev, levantou US$ 870 milhões em uma rodada que colocou a empresa em uma avaliação de US$ 7,5 bilhões. O aporte foi liderado pela Andreessen Horowitz, com participação da Sequoia e do investidor DCVC.
O Jev ganhou popularidade rapidamente após seu lançamento em 15 de setembro e, segundo a startup, já é usado por um terço das empresas da Fortune 500. O modelo usa arquitetura transformer, mas não gera texto como um LLM: ele produz probabilidades, chamadas de “calibrated decisions”, com a promessa de operar mais rápido e usar menos tokens, com foco em automação de tarefas.
Um estudo sobre interpretabilidade mecanicista propõe um framework matemático para ajudar a “reverter” o funcionamento interno de transformers, com foco em modelos pequenos e simplificados. Os autores analisam transformers com duas camadas ou menos e apenas blocos de atenção, evitando MLPs, e dizem que a abordagem equivalente em termos matemáticos facilita entender os cálculos internos.
A pesquisa destaca a identificação de attention heads chamados “induction heads”, que conseguem explicar o aprendizado em contexto (in-context learning) nesses modelos. Embora o trabalho não aplique diretamente as descobertas a modelos maiores como GPT-3, os autores afirmam que a estrutura proposta e o conceito de induction heads devem continuar relevantes em modelos mais realistas, ainda que a engenharia reversa completa permaneça distante.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
Um transformer pequeno foi treinado do zero em 1,5 hora em uma GPU 5090 e atingiu 44% no ARC-AGI-1, superando muitos LLMs e com pontuação equivalente a TRM/HRM. O resultado também chega a 7% no ARC-2 e representa uma evolução do modelo anterior, com foco em ser mais rápido, melhor e mais barato, mantendo o código aberto.
O trabalho usa um benchmark de metalearning (ARC) com poucos exemplos por puzzle e regras diferentes entre tarefas, buscando melhorar a eficiência de amostras e reduzir custos de iteração. O autor descreve mudanças na arquitetura e no treinamento, incluindo upgrades como SwiGlu e RMSnorm, além de ajustes para evitar “data leakage” ao incorporar tarefas não sobrepostas de ARC-2.
Você provavelmente já usou inteligência artificial hoje, mesmo sem perceber: o celular reconhece seu rosto, o app de mapas sugere desvio no trânsito e o banco bloqueia compras suspeitas. Por trás disso, a IA reúne técnicas que permitem que máquinas façam tarefas como reconhecer imagens, entender frases e prever comportamentos, aprendendo com exemplos em vez de seguir regras fixas.
O avanço recente foi impulsionado por mais dados, maior poder de processamento e métodos como o Transformer, que ajudaram a popularizar modelos de linguagem como o ChatGPT no fim de 2022. Ao mesmo tempo, a tecnologia traz riscos como vieses nos dados, “alucinações” em modelos de linguagem e impactos no emprego, além de discussões sobre regulação em países como a União Europeia e projetos no Congresso do Brasil.
Transformers, base dos principais grandes modelos de linguagem, estão ganhando limitações com o aumento do tamanho dos textos e do custo computacional. A discussão ganhou força após avanços recentes em LLMs, como modelos de raciocínio e maior capacidade de lidar com entradas grandes, que nem sempre são extensões diretas da tecnologia central.
Uma nova onda de startups tenta resolver o gargalo. A Subquadratic, de Miami, diz ter criado um mecanismo de atenção esparsa (SubQ) que rivaliza modelos LLMs de referência em tarefas como busca e codificação, enquanto a Manifest AI, de San Francisco, propõe “power retention” para manter apenas informações mais relevantes no contexto, adaptando um LLM de código open source (StarCoder) para o PowerCoder e lançando o Brumby, que a empresa afirma competir com versões do Qwen.
A Meta colocou o modelo Muse Glimmer em circulação com foco em uso local, agente e multimodal, trazendo suporte “day-0” para integrações em bibliotecas como transformers, llama.cpp e vLLM. O Muse Glimmer é um modelo denso de 30B parâmetros, com encoder de visão estilo ViT de 2B para percepção e um decoder de texto com 28B.
Além do modelo principal, há um módulo opcional de speculative decoding implementado no DFlash, que pode acelerar a geração com custo adicional de memória, especialmente em conteúdo estruturado como código. O lançamento também inclui instruções para carregar o modelo via AutoModelForMultimodalLM e AutoProcessor, com exemplos de inferência apenas por texto, entrada de imagens e tool calling multimodal.