A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A OPPO anunciou a versão global do ColorOS 17 nesta terça-feira (17), com Android 17 e novas animações durante o uso. A interface também inclui recursos de IA para organizar arquivos e automatizar tarefas, além de chegar pela primeira vez a celulares de OnePlus e Realme.
O ColorOS 17 aposta em uma arquitetura unificada para renderizar componentes e promete economia de até 25% de memória RAM. Entre as novidades estão um agente integrado que combina fotos e arquivos para gerar respostas personalizadas usando tecnologia da Manus e o AI Call Guard, ferramenta para identificar possíveis golpes em ligações com vozes falsas ou deepfakes, com atualização prevista em lotes de outubro de 2026 a primeiro trimestre de 2027.
A Gremlin anunciou a disponibilidade geral do Foresight AI, um produto com agentes que analisa serviços em busca de falhas, recomenda mudanças e reexecuta testes para verificar se a correção realmente funciona. O recurso funciona como um add-on da plataforma Gremlin, que também permite rodar experimentos planejados, controlar o “blast radius” e usar testes automatizados para manter correções eficazes ao longo do tempo.
O Foresight AI organiza o trabalho em quatro papéis de agentes: um Analyst coleta dados e sugere testes, um Tester agenda e executa, um Operator interpreta falhas e propõe remediações, e um Technical Program Manager acompanha cobertura, riscos e compromissos entre equipes, gerando relatórios e atualizações no Slack. As recomendações se baseiam no Failure Atlas da Gremlin, e o produto mantém um “loop” de validação fechada: ele não executa testes nem aplica remediações sem aprovação, preservando a responsabilidade humana enquanto automatiza análise e repetição.
Elon Musk afirmou que o Grok @Bot, lançado pela SpaceXAI em beta em agosto, vai usar o modelo mais adequado para cada tarefa. A orientação inclui opções como Claude Opus 5.5, além de integrações com serviços como MidJourney e Suno, com foco em maximizar o resultado em cada caso.
O texto também descreve como empresas estão adotando “model triage” para controlar custos: uma abordagem comum é usar modelos menores para triagem e reservar modelos mais caros para etapas que realmente exigem desempenho superior. A mudança traz ganhos de eficiência, mas exige testes e avaliação antes de trocar modelos, já que substituições podem quebrar fluxos e depender de ajustes como limites e rotinas de validação.
A recusa de respostas em modelos de IA virou um pilar da segurança, mas o texto destaca que “dizer não” não é algo natural para as máquinas. Em vez disso, empresas treinam e refinam sistemas para recusar prompts considerados perigosos, usando recompensas por negar e punições por recusar demais, além de camadas extras para bloquear solicitações. Mesmo assim, a recusa é probabilística e pode falhar, deixando passar pedidos ligados a violência e outras condutas nocivas.
O debate também aponta que existe uma linha difícil para definir o que a IA deve obedecer ou desobedecer, e que essa decisão fica, por enquanto, nas mãos das próprias empresas. Com governos podendo criar regras próprias, a recusa pode acabar sendo usada tanto para bloquear atos realmente maliciosos quanto para restringir fala legítima, inclusive em contextos de repressão. O texto ainda lembra que, quando a recusa falha, os impactos podem ser graves.
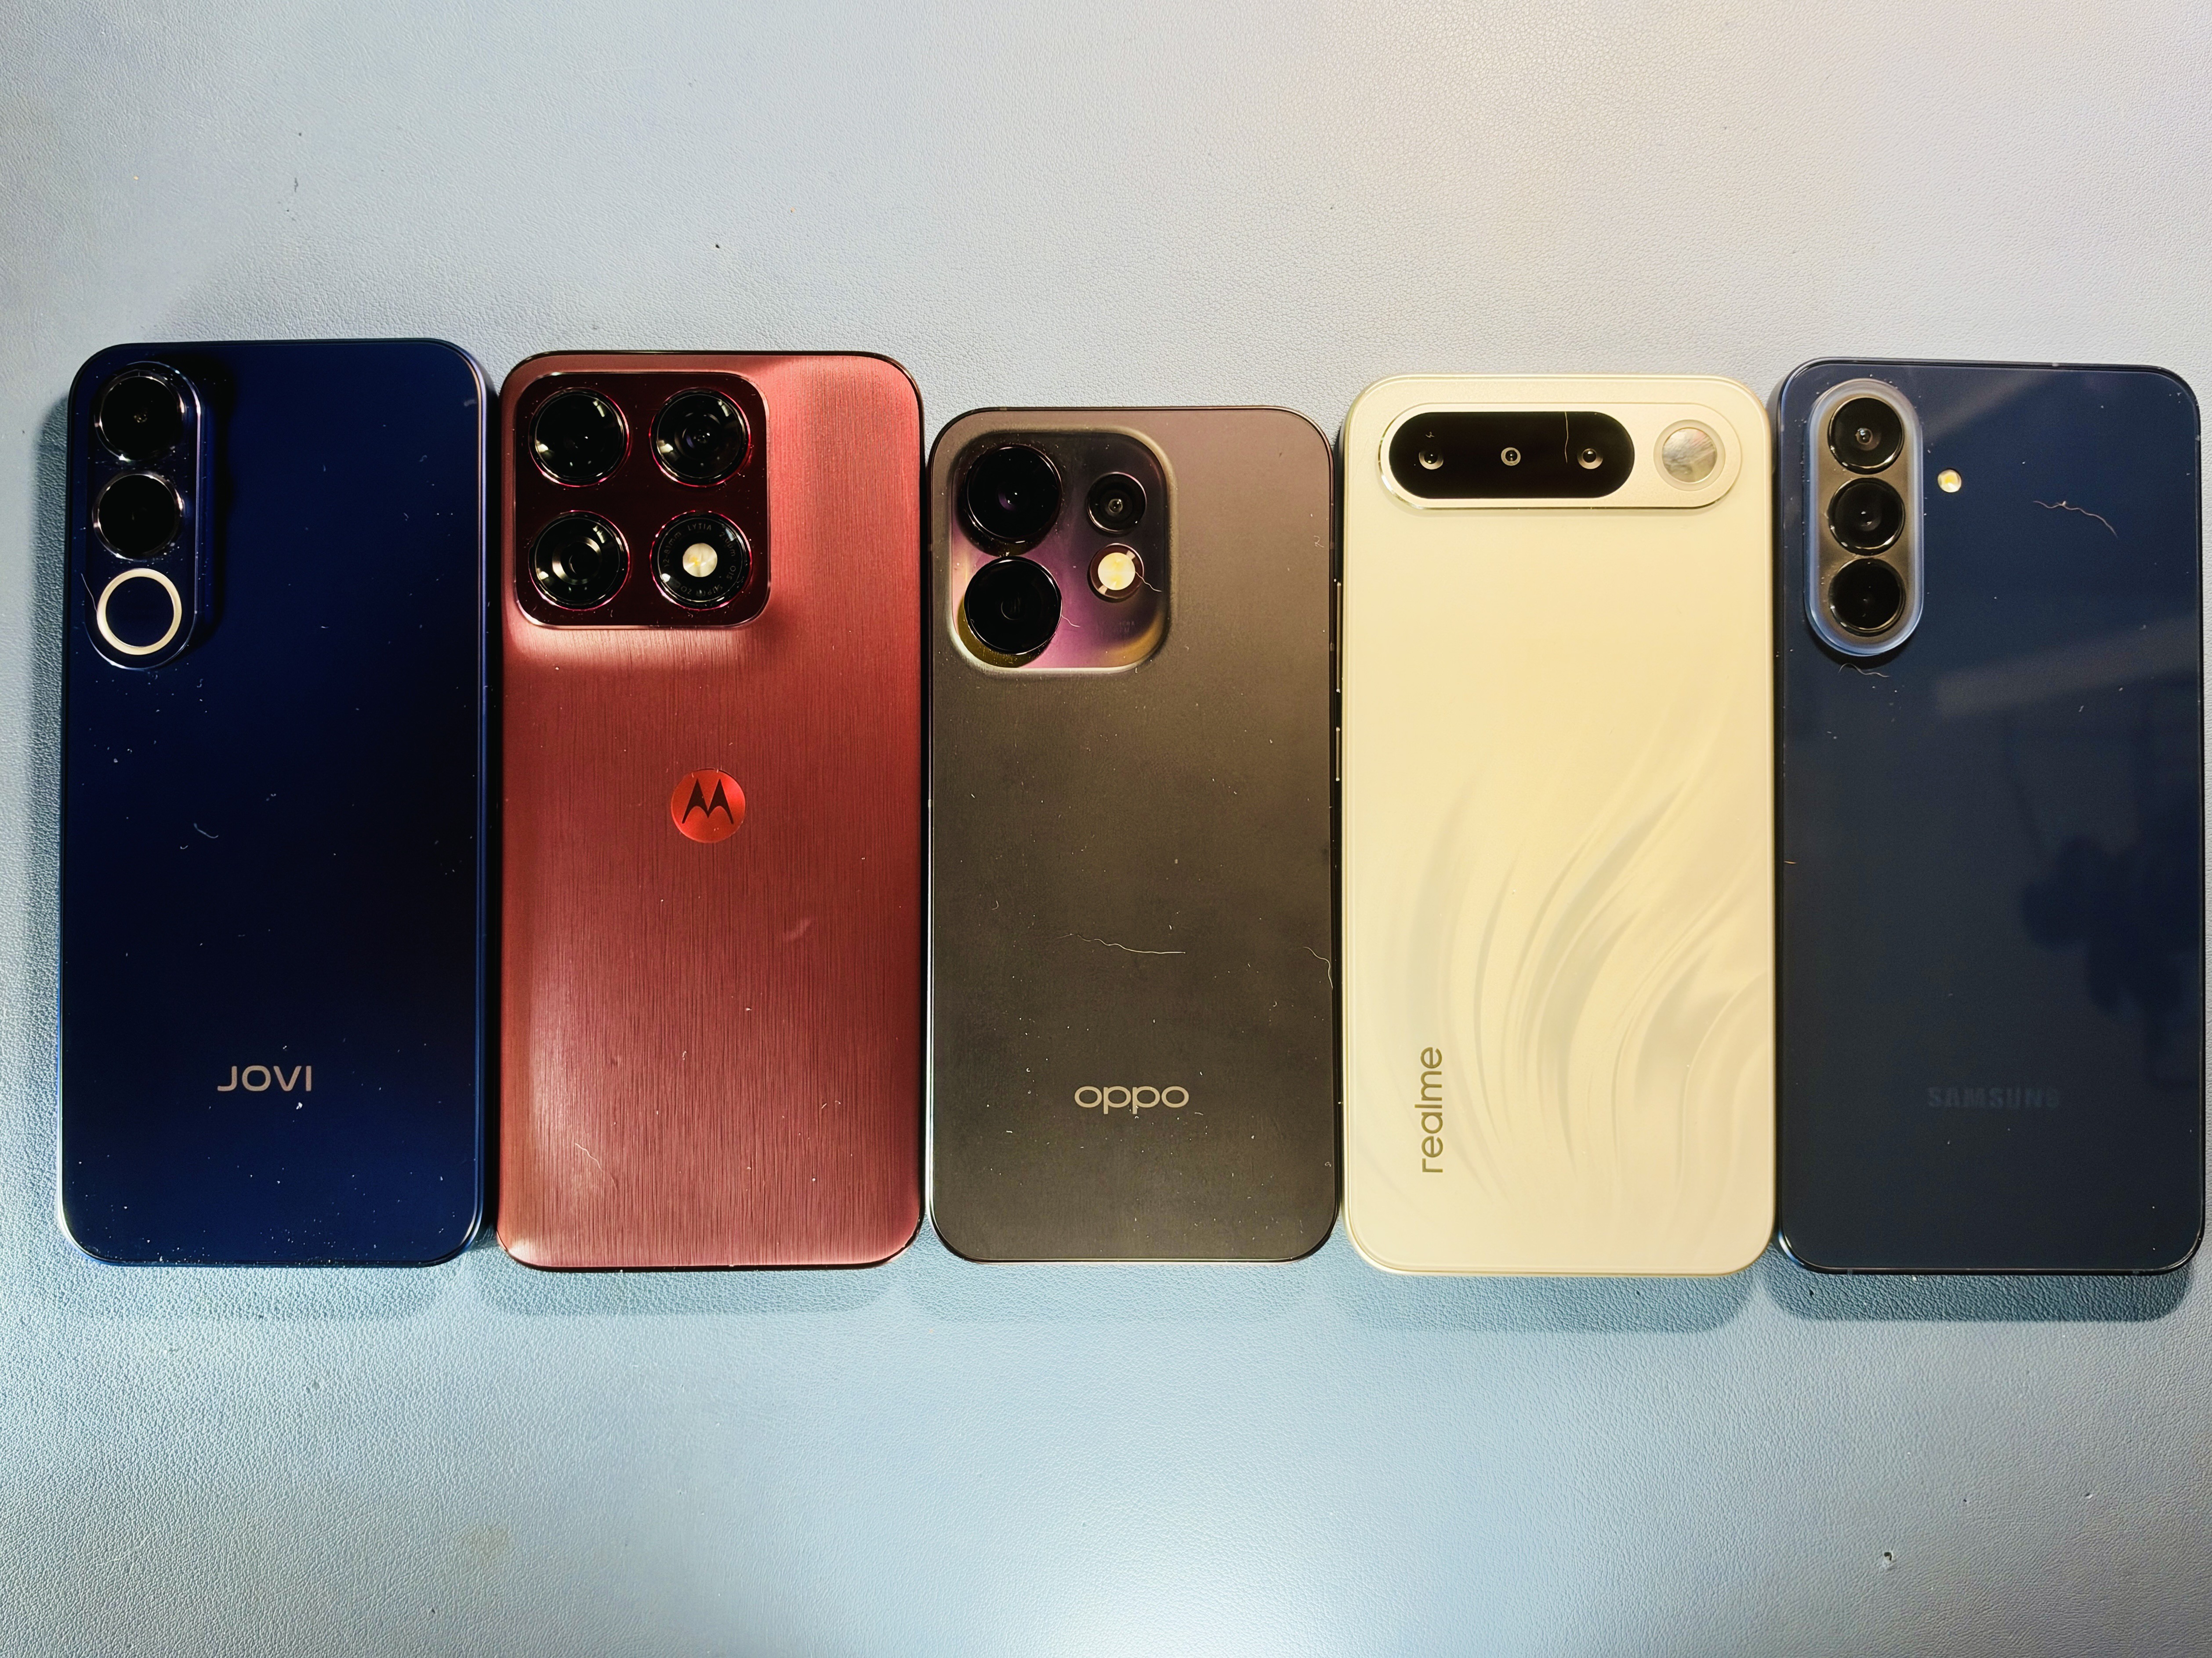
Escolher um Android intermediário em 2026 ficou mais difícil, com preços que chegam a R$ 7.000 e uma lista que inclui Jovi V70 (cerca de R$ 3.000), Motorola Edge 70 Pro (de R$ 3.200 a R$ 4.500), Oppo Reno 16 (de R$ 5.000 a R$ 7.000), Realme 16 (R$ 2.400) e Samsung Galaxy A57 (de R$ 2.100 a R$ 2.400). Os aparelhos foram enviados por empréstimo pelas fabricantes e serão devolvidos, e a Xiaomi não enviou o Redmi Note 17 Pro Max para participar do comparativo.
No teste, o Jovi V70 se destacou na bateria, chegando a 27h15, e chamou atenção pela câmera principal de 200 MP, enquanto o Moto Edge 70 Pro liderou no desempenho geral e manteve a melhor avaliação gráfica, além de ter tela de 144 Hz e 12 GB de RAM. O Galaxy A57 ficou com a melhor relação custo/benefício e o melhor peso do grupo (179 g), mas teve a menor bateria (5.000 mAh), e o Oppo Reno 16 foi apontado como menos vantajoso pelo preço oficial de R$ 6.999.
Pesquisadores da University of New South Wales (UNSW) testaram ferramentas de AI-coding com estudantes de ciência da computação em três tarefas iniciais de programação em C. O grupo que usou ChatGPT-4.5 obteve 89% de acerto, contra 69% no grupo que usou busca tradicional. Porém, ao medir o que realmente foi retido, a pontuação caiu para 41% imediatamente depois, frente a 53% sem IA, e ficou em 39% após dois dias, contra 52%.
Os próprios participantes indicaram o motivo: quem usou ChatGPT estimou que apenas 45% do código submetido era realmente “deles”, enquanto o grupo com busca convencional apontou 81%. Para lidar com o problema, a proposta citada é ajustar programas de formação, com pareamento de juniores com seniors e treinamento para revisar e “policiar” o que a ferramenta gera, evitando confundir quantidade de código com qualidade e entendimento.
Uma diferença entre abrir a caixa de entrada e saber o que realmente exige atenção aparece quando mensagens curtas pedem decisões importantes ou quando outras tomam a tela toda para dizer algo que poderia ser resumido. Gmail e Outlook já incorporam recursos de IA para resumir conversas, sugerir respostas, criar rascunhos e organizar mensagens.
Além da escrita, as funções ajudam a priorizar e a lidar com tarefas repetitivas: a IA pode separar e-mails que exigem ação dos informativos, priorizar com base em remetente e conteúdo, gerar rascunhos a partir de comandos e sugerir respostas para confirmar horários e agradecer contatos. Também é possível pedir resumos por linguagem natural, revisar tom e clareza de rascunhos e executar ações como arquivar, mover, excluir, sinalizar e categorizar mensagens por comandos.
Ataques impulsionados por inteligência artificial estão acelerando a criação de exploits, enquanto o tempo para explorá-los diminui e a descoberta de vulnerabilidades ganha velocidade. Com isso, cresce a distância entre o que as equipes de segurança conseguem identificar e o que conseguem investigar e corrigir de forma efetiva.
O texto destaca que “severidade” não é “risco”: uma mesma CVE pode representar ameaças muito diferentes dependendo de exposição, execução de código e caminhos de ataque. Para reduzir esse descompasso, a recomendação é trocar a pergunta “quantas CVEs temos?” por “quais geram risco relevante no ambiente”, com processos mais contínuos e automatizados, além de foco em reduzir a superfície antes do deploy e escanear o que realmente está rodando em produção.
Um desenvolvedor decidiu restringir contribuições com IA em um projeto FOSS que mantém, o LibreWeddingPlanner, e passou a usar ferramentas de IA apenas no trabalho. Mesmo sem usar IA no projeto, ele relata que, no dia a dia profissional, o uso de autocomplete e modelos de geração de código no VS Code evoluiu para um fluxo com agentes de IA, que passaram a criar PRs e até coassinar commits.
Com o tempo, ele diz ter perdido a noção do que era realmente necessário em cada tarefa, além de ter enfrentado dificuldade para revisar mudanças grandes e entender alterações geradas por agentes. A experiência culminou em exaustão com múltiplos contextos e, após meses, ele afirma não ter escrito linhas de código nem feito commits no próprio período, levando à decisão de ficar um mês sem IA.
Empresas estão reformulando entrevistas para lidar com ferramentas de IA que escrevem códigos, analisam informações e geram respostas em segundos. Com isso, uma prova técnica feita em casa passou a dizer menos sobre o que o candidato realmente sabe, levando companhias a aumentar etapas ao vivo ou a permitir o uso de IA durante a avaliação.
A Anthropic revisou seus testes técnicos: desde 2024, mais de mil candidatos fizeram uma prova para vagas de engenharia de performance, mas versões do Claude passaram a resolver o desafio com facilidade, então a empresa criou novas versões para diferenciar melhor os perfis. A DoorDash, por sua vez, trocou parte das entrevistas tradicionais por uma sessão de 60 minutos em que os candidatos podem usar IA e explicar o raciocínio enquanto avaliadores observam decisões e correções; fora da tecnologia, consultorias e empresas também passaram a incluir exercícios com uso de IA para analisar informações e melhorar respostas.
Relatos recentes apontam que, em projetos de software, algumas equipes passaram a dizer que não escrevem código há anos, que revisões de código “morreram” e que as pessoas não leem mais código. O texto argumenta que projetos “vibe-coded” tendem a virar um emaranhado difícil de manter ao longo do tempo, porque a qualidade de arquitetura e manutenibilidade demora meses ou anos para ficar evidente.
O autor afirma que modelos de IA não são treinados para medir o que torna o código realmente sustentável, já que não existe uma “função de fitness” clara para manutenibilidade que possa ser embutida em linters. Também critica a tendência de confiar em IA para escrever e até ler código, dizendo que isso reduz escolhas e responsabilidade humanas, enquanto a IA não aprende com os próprios erros.
O setor de IA entrou em um debate sobre segurança e a possibilidade de desacelerar o ritmo de desenvolvimento. O CEO da Anthropic, Dario Amodei, publicou um plano para “pace the frontier”, enquanto o CEO da Nvidia, Jensen Huang, ecoou a ideia de que a reação contrária à IA seria um “hoax” e que a regulação seria desnecessária.
No episódio do podcast Equity, do TechCrunch, Kirsten Korosec e Sean O’Kane discutiram se líderes como Amodei e o CEO da OpenAI, Sam Altman, estão realmente dispostos a reduzir o ritmo. O debate também citou propostas como avaliadores independentes monitorando práticas e incidentes de segurança e a coordenação de padrões e limites entre grandes empresas, mas com críticas à falta de detalhes e à ausência de mecanismos claros de proteção e responsabilização.
O Petlibro apresentou a linha Granary 2 de alimentadores automáticos para ração seca, com foco em dar aos tutores uma visão mais detalhada do que os gatos realmente comem. A série inclui quatro modelos, com preços de US$ 129,99 a US$ 249,99, e traz controle pelo app, porções precisas e acompanhamento de ingestão.
O Granary 2 Vision (US$ 189,99) adiciona uma câmera com IA capaz de reconhecer até 10 gatos e rastrear os hábitos individuais de alimentação. Já o Granary 2 X (US$ 249,99) usa reconhecimento por IA para porcionamento individual para pets com necessidades específicas, enquanto todos os modelos contam com balança integrada para medir o que foi dispensado e o que permanece no recipiente, ajudando a estimar quanto o pet realmente comeu. Recursos como monitoramento avançado e gravação/reprodução em nuvem podem exigir assinaturas da Petlibro, com planos a partir de US$ 59,99 por ano.
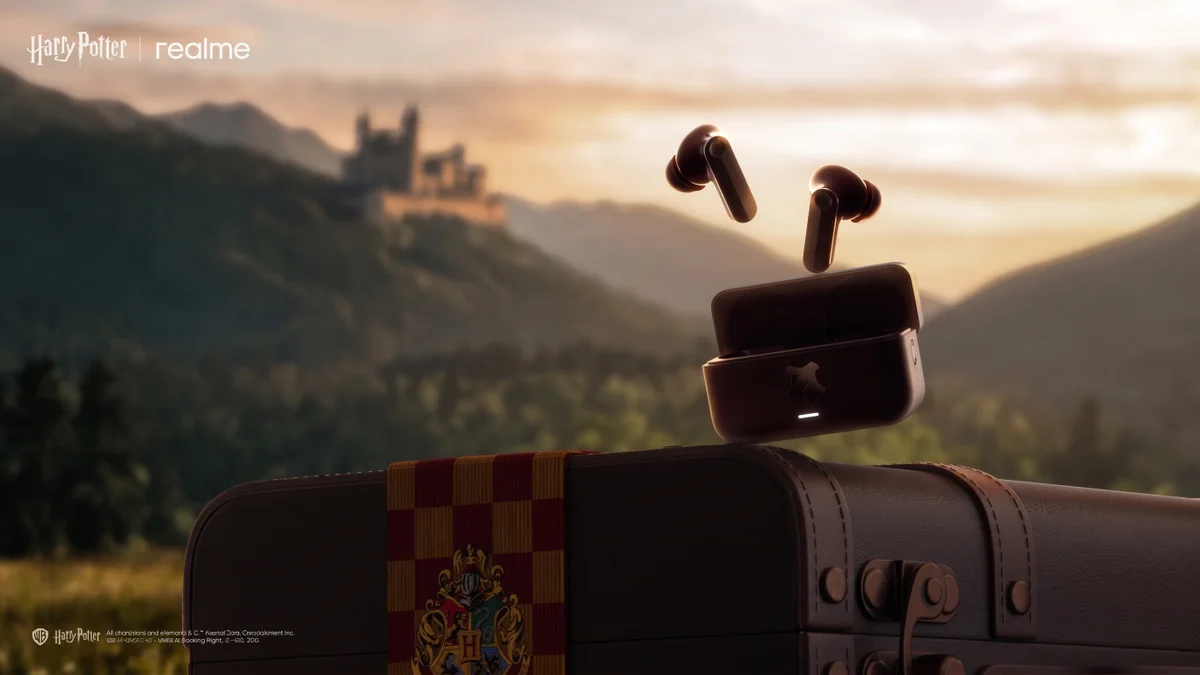
A Realme prepara a Buds T500 Pro Harry Potter Edition, parceria com o universo de Harry Potter, com lançamento marcado para a próxima segunda-feira (21). O fone chega junto do smartphone Realme 16 Pro Harry Potter Edition, ambos com edição especial inspirada no mundo mágico.
A versão temática deve manter as especificações do modelo convencional, com cancelamento de ruído de até 50 dB e seis microfones (três em cada lado). Os Buds T500 Pro trazem drivers de 12,4 mm, certificação Hi-Res e suporte ao LHDC 5.0, além de bateria de 62 mAh em cada fone e estojo de 530 mAh, com autonomia anunciada de até 14 dias.
A Vercel apresentou o eve, um framework open source e cloud-native para rodar agentes de IA com mais confiabilidade em escala. Em vez do modelo tradicional de uma única sessão por usuário, o eve foi desenhado para lidar com milhares de requisições simultâneas, mantendo sessões isoladas, duráveis e recuperáveis.
No eve, o agente é definido de forma declarativa por arquivos de configuração, que são compilados em infraestrutura como código para provisionar apenas o que o agente realmente usa. A iniciativa também foi discutida em um episódio com Andrew Barba e Shar Dara, reforçando a visão de que “construir empresas” está se aproximando de “construir agentes”.
A Snap, empresa por trás do Snapchat, detalhou o que seus óculos de realidade aumentada Specs realmente fazem e anunciou o serviço de inteligência artificial Specs Intelligence. O lançamento aconteceu em Los Angeles, com a previsão de que os novos Specs comecem a ser enviados aos compradores ainda neste outono.
Além de funções como chamadas via Bluetooth, fotos e vídeos, streaming com display e tradução em tempo real, a Snap apresentou a “anticipatory AI”, que antecipa o que o usuário quer fazer usando dados do dia a dia. O app será lançado hoje para iPhone e Mac e também funciona com os óculos, sem exigir que o usuário esteja com o dispositivo para usar, com demonstração marcada para 1º de outubro no Westfield Century City.
Dario Amodei, CEO da Anthropic, propôs que avaliadores independentes sejam incorporados a todas as “frontier AI companies”, com poder para reportar incidentes de segurança, avaliar se os modelos estão realmente alinhados e divulgar os achados sem “controle editorial”. Amodei disse que a Anthropic daria acesso sem precedentes a avaliadores como METR e Redwood Research, e Sam Altman indicou que a OpenAI também seguiria a prática.
A proposta é vista com bons olhos por avaliadores ouvidos pelo TechCrunch, mas eles pedem detalhes para garantir independência real, incluindo acesso a versões intermediárias (“checkpoints”) e verificação de logs e transcrições de avaliação. O debate também envolve limites de tempo e acesso: casos anteriores com METR e Redwood e testes citados para GPT-6 Astra apontam janelas curtas que dificultaram conclusões confiáveis, levantando a pergunta sobre o que mudará na prática.
Uma caixa de entrada cheia não significa que todas as mensagens exigem atenção imediata. Entre e-mails de trabalho, avisos automáticos, newsletters e solicitações de colegas, identificar o que realmente precisa de resposta pode consumir parte da rotina. A inteligência artificial pode ajudar nessa triagem quando há critérios claros de priorização e categorias definidas para cada tipo de mensagem.
Ferramentas com IA podem reconhecer padrões no conteúdo para separar assuntos por prioridade, criar regras de classificação a partir de exemplos e resumir transcrições destacando decisões, tarefas, prazos e perguntas. Também é possível analisar sequências de mensagens para indicar quais exigem alguma ação e transformar a caixa de entrada em uma lista de tarefas, além de gerar primeiras versões de respostas com o tom desejado — sempre com revisão humana e conferência de dados antes do envio.
O LinkedIn afirma que perfis completos recebem 21 vezes mais visualizações e nove vezes mais solicitações de conexão. A plataforma também diz que adicionar seções recomendadas melhora a descoberta do perfil nos resultados de pesquisa.
A IA pode entrar nesse processo como uma auditoria: você fornece o conteúdo de cada seção e pede uma análise objetiva para identificar lacunas, trechos pouco claros e termos que poderiam representar melhor a experiência. Depois da revisão, vale acompanhar as métricas do LinkedIn — como visualizações e aparições — para verificar quais ajustes realmente aumentam o alcance.
A demanda pelo modelo Astra, descrito como o mais novo e poderoso da OpenAI, levou a empresa a pausar temporariamente as novas assinaturas do plano Pro, de US$ 200 por mês. A medida foi anunciada no X por Thibault (Tibo) Sottiaux, líder de produtos da OpenAI, que citou pressão sobre a infraestrutura e afirmou que o Pro é o plano que mais sobrecarrega os sistemas.
Sottiaux disse que a empresa vai desativar as inscrições nesse nível para conseguir manter o acesso mais amplo possível, enquanto outros planos seguem disponíveis, incluindo a API e as opções Go e Plus. A OpenAI também não informou por quanto tempo a pausa pode durar, nem o volume diário de novos assinantes, e lembrou que a mudança poderia ocorrer diante de uma procura “realmente sem precedentes”.
Assistentes de codificação com IA deixaram de ser novidade e viraram infraestrutura: em 2026, a maioria das equipes de engenharia usa essas ferramentas semanalmente e uma parcela crescente do código de produção é gerada por IA. Com isso, o desafio mudou de escrever código para verificar se ele está correto, seguro e alinhado ao que foi realmente pretendido.
Um estudo apresentado na GAISS 2026 avaliou a prática de revisar a especificação como “baseline” de governança. Os resultados indicam que a especificação não tornou revisores melhores para achar bugs, mas transformou a revisão em uma atividade ancorada em contrato, com rastreabilidade e maior confiança — ainda com impacto mensurável em tempo e custo, especialmente em tarefas com múltiplas restrições feitas por modelos capazes, porém imperfeitos.
Harness lançou um Code Repository reconstruído e um produto de AI Code Review para lidar com o volume de pull requests gerados por coding agents. Martin Reynolds, Field CTO da empresa, relata que o gargalo de revisão apareceu quando equipes passaram a receber mais PRs, mas com travas no fluxo de testes, pressionando os times responsáveis por validar mudanças.
A empresa diz que construiu um software delivery knowledge graph para dar contexto ao revisor e reduzir o retrabalho, citando economia de mais de 10.000 horas mensais de revisão manual. A reconstrução do repositório foi pensada como “ground-up AI-first”, com foco em manter partes determinísticas do pipeline e permitir que revisores foquem no que realmente mudou.
A OpenAI exibiu uma demo do GPT-6 Astra operando um circuito em KiCad, usando o modelo para trabalhar diretamente em uma placa eletrônica. A discussão que surgiu em torno disso levou ao desenvolvimento do EEBench, um benchmark para medir se as saídas de IA em eletrônica realmente funcionam.
O EEBench avalia projetos de forma determinística com simulações SPICE e verificações, incluindo cenários com tolerâncias de componentes e restrições de energia. Nos resultados de 1º de setembro, Claude Opus 5 liderou com 61,6% em 13 tarefas, enquanto Grok 4.6 ficou em segundo com 57,1%, e xAI chegou a incluir o EEBench na card do modelo.
A OpenAI está testando com clientes enterprise um modelo de precificação baseado em resultados, em que a cobrança depende de o sistema de IA concluir o trabalho “certo”, e não apenas da quantidade de tokens ou compute consumidos. A empresa já iniciou os testes, segundo o relato do The Information, mas ainda não divulgou publicamente como define sucesso nem os detalhes do cálculo.
A mudança cria um desafio técnico para quem desenvolve agentes: é preciso determinar quando uma tarefa está realmente concluída, algo mais difícil do que contar tokens. Em cenários como agentes de código e automações com múltiplas etapas, uma execução pode passar em testes, falhar em produção ou completar 90% do fluxo sem ser considerada bem-sucedida, afetando diretamente o que vira cobrança e o risco financeiro do provedor.
O TechCrunch Disrupt 2026 volta com o “AI Stage” entre 13 e 15 de outubro, em San Francisco, no Moscone Center, para discutir como modelos de IA estão mudando negócios e criando novas demandas. A programação inclui conversas sobre modelos e adoção em empresas, segurança de agentes e o que significa ter um plano de go-to-market em um mundo “AI-native”.
Entre os destaques estão sessões com a Anthropic sobre o que acontece quando empresas realmente implantam o Claude, e com a OpenAI sobre como a IA criou a função de “GTM engineering”. O evento também reunirá líderes de empresas como Databricks, Okta, AWS, 1Password e outras para tratar de segurança e arquitetura para IA no ambiente corporativo.
Uma postagem de candidato pode ser cercada por centenas ou milhares de comentários, mas nem sempre essas contas representam pessoas reais. O g1 explica como bots e perfis falsos funcionam: bots são contas automatizadas para publicar, curtir, comentar ou compartilhar, enquanto perfis falsos simulam ser pessoas reais.
A professora Yasmin Curzi, da FGV, aponta que o objetivo costuma ser interferir no debate público e criar viés de confirmação, atingindo quem já tem posição política definida. Também pode surgir a impressão de que um tema ou candidato é mais popular do que realmente é, quando mensagens repetidas em grande volume reforçam a percepção de apoio.
ChatGPT chegou ao cotidiano de milhões e passou a dividir espaço com ferramentas de empresas como Google, Microsoft, Meta e Anthropic, mudando o tipo de cobertura exigida de quem acompanha tecnologia. Em janeiro de 2023, o Olhar Digital publicou um guia para explicar o que era o modelo de linguagem, como funcionava e quais eram suas limitações, incluindo o risco de gerar informações incorretas e conteúdo enviesado.
A cobertura do tema começou antes: em 2019, o portal já acompanhava o GPT-2 e alertava para preocupações com desinformação e usos maliciosos, e em 2020 registrou a chegada do GPT-3, com 175 bilhões de parâmetros. Depois do lançamento do ChatGPT em dezembro de 2022, a redação passou a lidar com um desafio recorrente: acompanhar mudanças rápidas, noticiar anúncios e aprofundar a apuração com testes, documentos, benchmarks e especialistas para entender o que realmente existe por trás das novidades.
Um guia publicado no site Dont Paste the AI defende que, ao responder alguém com ajuda de chatbots, a pessoa não deve apenas copiar e reenviar a saída do modelo. A proposta é usar a IA como rascunho ou apoio, mas manter o próprio contexto, julgamento e “take” sobre a pergunta.
O texto orienta a extrair apenas o trecho que realmente responde ao que foi perguntado e reduzir o restante a três frases escritas pelo autor. Também sugere citar partes úteis da resposta da IA e explicar por que fazem sentido, além de reconhecer quando não houver opinião forte para compartilhar.
Escolher o modelo de inteligência artificial pelo tamanho pode impactar diretamente o orçamento, já que versões maiores tendem a exigir mais processamento e custam mais por uso. Para empresas que rodam milhares de solicitações por dia, usar sempre o modelo mais avançado pode virar um gasto desnecessário.
A recomendação é começar pela tarefa: perguntas simples, classificação de informações e transformações de texto podem ser feitas com modelos menores, enquanto análises com mais raciocínio, interpretação de contexto e documentos extensos podem justificar modelos mais sofisticados. A avaliação pode comparar qualidade, velocidade, erros e custo por solicitação, além de permitir o roteamento de modelos para enviar tarefas simples a versões econômicas e reservar as avançadas para casos que realmente exigem mais capacidade.
Antes de assinar uma versão paga de inteligência artificial, vale calcular quanto tempo a ferramenta realmente economiza no trabalho. Para quem usa IA algumas vezes por semana, o plano gratuito pode bastar, enquanto profissionais que dependem dela diariamente tendem a se beneficiar de limites maiores e recursos adicionais.
A diferença costuma estar na frequência e no tipo de uso: versões pagas ampliam limites, liberam modelos mais avançados e adicionam ferramentas. No ChatGPT, o Plus custa US$ 20 por mês e inclui limites maiores, acesso a recursos de raciocínio avançado, análise de arquivos, geração de imagens, voz, pesquisa aprofundada e criação de GPTs personalizados; já no Gemini, os planos pagos elevam limites e ampliam modelos, com integração a Gmail, Docs e Planilhas. A recomendação é observar a rotina por semanas, anotar tarefas e medir o tempo economizado para decidir se a assinatura compensa.