16 resultados para Memory
Terça · 13 out
2026-10-13
1 matéria
IA
Destaque

Pesquisa · IA
A Meta apresentou os modelos Muse Wonder e Muse Wonder Full, descritos como as IAs mais avançadas da empresa para agentes pessoais e profissionais. Os sistemas foram treinados para tarefas com várias etapas, como analisar contratos, desenvolver aplicativos e operar navegadores e outros programas.
O Muse Wonder traz o Active Memory, que permite guardar informações entre conversas e recuperá-las em novas tarefas, além do Active Focus para manter o agente trabalhando diante de dificuldades. Em demonstrações, a Meta mostrou o modelo usando um navegador para criar e encomendar produtos a partir de fotos do Instagram e também dividindo projetos de programação entre subagentes; o Muse Wonder já está disponível para desenvolvedores e o Wonder Full fica restrito a planos pagos do Muse Code.
#InteligenciaArtificial · #IA · #AgentesDeIA · #IAgenerativa · #Meta · #LLM · #Programacao
Sexta · 25 set
2026-09-25
1 matéria
IA
Pesquisa · IA
O Jevmem foi lançado como uma “automatic project memory” para o Claude Code, com suporte também para Cursor e Codex. A ferramenta registra automaticamente decisões, restrições, bugs e todos das conversas em um arquivo JEVMEM.md, marcando linhas antigas como [superseded] em vez de apagá-las quando o usuário muda de ideia.
Na próxima sessão, as linhas relevantes voltam para o contexto do Claude. O Jevmem usa Postgres 16 como armazenamento principal (com SQLite em cenários de carga), permite configurar políticas em jevmem.config.json e inclui etapas de segurança como “scrub” de credenciais e auditoria em CI para bloquear instruções potencialmente maliciosas.
#InteligenciaArtificial · #IA · #ClaudeCode · #IAgenerativa · #AgentesDeIA · #DevTools · #AutomacaoDeSoftware
Domingo · 20 set
2026-09-20
3 matérias
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O runtime Bun, para JavaScript/TypeScript, foi reescrito de Zig para Rust após quatro meses de trabalho, com o objetivo de reduzir vulnerabilidades de segurança ligadas a falhas de memória. Segundo Jarred Sumner, o uso do borrow checker do Rust ajuda a transformar problemas recorrentes como use-after-free, double-free e “forgot to free” em erros de compilação.
A migração foi feita com apoio de um processo assistido por IA: o time usou um Claude Fable 5 pré-release orquestrado em cerca de 50 fluxos dinâmicos, convertendo arquivos Zig para Rust e validando contra um conjunto de testes de mais de um milhão de asserções. O Bun v1.4.0, lançado em agosto de 2026, afirma ter corrigido 128 bugs antigos do v1.3.14, reduzido vazamentos de memória nativos e melhorado métricas como throughput HTTP em 2% a 5%.
#InteligenciaArtificial · #IA · #DesenvolvimentoDeSoftware · #Rust · #Bun · #Claude · #Programacao
IA

Pesquisa · IA
O app de agentes de IA da Meta, o Muse, foi promovido no Instagram e no WhatsApp e já ultrapassou 900 mil downloads na primeira semana, segundo a Sensor Tower. A ferramenta promete “passar tarefas do dia a dia” como buscar ofertas, reservar e gerenciar a caixa de entrada, conectando-se a fontes como e-mail e conta bancária.
Após alguns dias de uso, o texto relata preocupação com a coleta de dados: o app incentiva o usuário a conectar mais informações para personalização e mantém uma “Memory” com preferências e compromissos. O Muse também usa interações do usuário para treinamento de modelos de IA de forma automática, com a opção de desativar a contribuição em “Data controls”, mas sem um botão para desligar totalmente a função de memória.
#InteligenciaArtificial · #IA · #AgentesDeIA · #Meta · #Privacidade · #IAgenerativa
IA

Pesquisa · IA
O recurso de Memory do ChatGPT passou a armazenar interações para dar contexto às respostas, como evitar recomendações que contrariem preferências que você informou. Com isso, a forma como o chatbot responde pode ser influenciada por informações que você compartilhou — inclusive em situações como pesquisas recentes que fazem a IA inferir interesses ou locais. A OpenAI descreve que o objetivo do Memory (ou “dreaming”) é manter contexto útil, seguir preferências e se manter atualizado ao longo do tempo.
No app web, é possível acessar o que foi lembrado pelo ícone do perfil e ir em Personalization até a seção Memory. O usuário pode desativar o recurso, gerenciar Memory summaries com correções (“Make a correction” ou “Don’t mention this again”), ou pedir para o sistema esquecer algo via comandos no campo de prompt. Para apagar tudo, basta usar Delete e desligar o Memory; também há a opção de Temporary chat, em que nada fica registrado na memória após o encerramento.
#InteligenciaArtificial · #IA · #ChatGPT · #OpenAI · #Privacidade · #Memory
Terça · 08 set
2026-09-08
1 matéria
IA
Pesquisa · IA
Agentes como Claude Code e Instinct estão migrando do computador local para rodar em VMs acessadas pelo celular, com as empresas fornecendo a infraestrutura para executar as tarefas. No Claude Code, a sessão no telefone é conduzida por uma Firecracker microVM com um kernel e um init em Rust, enquanto a inferência ocorre em outro lugar e é entregue via Server-Sent Events (SSE) sobre HTTPS/2.
O Instinct, por sua vez, não opera uma frota própria de VMs: ele aluga sandboxes da E2B, que inicializam um Ubuntu com systemd e um ambiente gráfico. A “memória” do agente fica em um diretório /memory, organizada como um repositório Git de arquivos Markdown persistido em S3, com credenciais temporárias para reduzir impacto caso uma sandbox vaze.
#InteligenciaArtificial · #IAgenerativa · #AgentesDeIA · #ClaudeCode · #Firecracker · #MobileAgents · #E2B
Segunda · 07 set
2026-09-07
1 matéria
IA

Pesquisa · IA
O engrim propõe uma “memória episódica” local-first baseada em SQLite para CLIs e agentes de IA, mantendo decisões, restrições e estado do projeto ao alternar entre modelos e ambientes no mesmo repositório. A proposta é evitar a perda de contexto causada por janelas de contexto maiores e pelo custo que cresce a cada turno, substituindo isso por uma memória curada de trabalho.
O engrim combina busca full-text com SQLite FTS5 e embeddings vetoriais (model2vec) em um motor híbrido de recuperação, com suporte a ambientes como Google Antigravity, Claude Code, Cursor MCP e Codex CLI via MCP tools. O projeto também descreve instalação e configuração automática (por exemplo, com engrim setup e engrim setup --all) e testes citados com 105 sessões contínuas e migração não destrutiva de dados ao adicionar campos como origin_agent.
#InteligenciaArtificial · #IAgenerativa · #AgentesDeIA · #LLM · #MCP · #SQLite · #DesenvolvimentoDeSoftware
Quarta · 02 set
2026-09-02
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
Redis está usando engenharia de contexto para viabilizar aplicações com LLM em cenários com restrições reais de tempo. Em uma apresentação, Ricardo Ferreira contou como desenvolveu o Agent Memory Server (AMS), um projeto open source para criar camadas de memória de curto e longo prazo sobre Redis, com foco em permitir conversas mais naturais.
Para testar o AMS, ele criou a skill “My Jarvis” para Alexa, com respostas limitadas por um timeout fixo de 8 segundos. A arquitetura inclui uma função Lambda no backend, o SDK da Alexa e o LangChain4j (Java), que orquestra o acesso a um LLM via OpenAI, enquanto o desenvolvimento enfrenta problemas como context poisoning, distração por excesso de dados, confusão e “context rots”.
#InteligenciaArtificial · #IAgenerativa · #EngenhariaDeSoftware · #LLM · #LangChain4j · #Redis · #ContextEngineering
Segunda · 31 ago
2026-08-31
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
Scott Jenson, designer de UX com histórico no Macintosh, Google Maps e Chrome, critica a estagnação dos sistemas operacionais de desktop e aponta limitações do modelo centrado em mobile e na nuvem. O episódio destaca a proposta de software “Local-First” para garantir soberania dos dados e resiliência mesmo com falhas de conectividade.
A conversa também defende uma evolução das interfaces, saindo da manipulação direta e sem estado para sistemas com “working memory”, capazes de acompanhar contexto e histórico do usuário. No cenário de “LLM everywhere”, a integração de inteligência deve acontecer dentro dos fluxos de trabalho das aplicações, substituindo chatbots universais por interfaces funcionais e agentic.
#InteligenciaArtificial · #IA · #LocalFirst · #AgentesDeIA · #LLM · #UX · #ArquiteturaDeSoftware
Sexta · 28 ago
2026-08-28
1 matéria
IA
Destaque
Pesquisa · IA
Agentes com LLM têm se mostrado eficazes para navegar grandes bases de código e ajudar em pesquisas de vulnerabilidades, mas o pesquisador relata um problema recorrente: após horas de investigação, o modelo perde o fio do que foi estabelecido e pode retomar abordagens já descartadas ou continuar raciocinando com observações que deixaram de ser válidas.
Para reduzir esse tipo de inconsistência, ele passou a tratar a “memória” do LLM como um problema de análise de programa: em vez de pedir que o modelo reconstrua o estado a partir de um histórico, a ideia é manter conclusões derivadas automaticamente. Assim, surgiu um motor em Datalog para LLMs, chamado Lemmalog, em que o LLM interpreta saídas como texto, código e dados do depurador, enquanto a base lógica mantém fatos, aplica regras e invalida conclusões quando observações mudam.
#InteligenciaArtificial · #IA · #LLM · #AgentesDeIA · #Datalog · #ProgramAnalysis · #SegurancaDigital
Terça · 25 ago
2026-08-25
1 matéria
IA
Destaque

Pesquisa · IA
Falhas de agentes de IA em produção têm menos a ver com raciocínio e mais com a incapacidade de gerenciar o que entra no contexto: histórico de conversas, prompts grandes, definições extensas de ferramentas e saídas que crescem a cada interação. Com o acúmulo, o agente “afoga” em sua própria memória e paga um custo de tokens que aumenta a cada turno, levando a esquecimentos dentro e entre conversas.
A pesquisa defende que o problema não deve ser tratado apenas como armazenamento e busca, mas como uma questão de ciclo de vida e arquitetura do contexto. O trabalho propõe a disciplina Agentic Context Management (ACM), com cinco primitivas (arquitetar, ingerir, delimitar, antecipar e compactar/consolidar), além de uma implementação de referência chamada Maximem Synap, que reporta 92% no LongMemEval e 93,2% no LoCoMo.
#InteligenciaArtificial · #IA · #AgentesDeIA · #memoriaEmAgentes · #contexto · #tokenCost · #arXiv
Domingo · 23 ago
2026-08-23
1 matéria
IA
Pesquisa · IA
A OVHcloud vai reajustar preços em grande parte do seu catálogo a partir do outono, e o motivo apontado não está nos produtos em si: os custos de memória e armazenamento subiram fortemente desde meados de 2025. O fundador Octave Klaba relaciona a escalada ao avanço do setor de IA, que teria puxado capacidade de fabricação dos componentes usados em servidores comuns.
Klaba afirma que fornecedores globais de RAM reconfiguraram fábricas para memórias de maior largura de banda, voltadas a GPUs, em detrimento de DDR4 e DDR5. Com base nas compras da própria OVHcloud, ele cita que a memória chegou a 604 (índice) em junho de 2026, ante 604? (jun/2025 como base), e projeta aumentos ainda maiores para setembro de 2026 e início de 2027, além de reajustes em SSDs e HDs; a empresa também separa itens de armazenamento e IP em instâncias Gen3 a partir de 1º de outubro e reduz planos de economia de 1, 6 e 24 meses, mantendo opções de 12 e 36 meses.
#InteligenciaArtificial · #IA · #InfraestruturaDeIA · #CloudComputing · #MemoriaRAM · #ArmazenamentoSSD · #CustosDeHardware
Segunda · 10 ago
2026-08-10
1 matéria
IA
Destaque
Pesquisa · IA
Resumos de IA do Google têm levado usuários a perderem informações básicas, com casos em que a ferramenta passou a “inventar” horários e fez pessoas acreditarem que eventos já tinham acontecido. O problema é visto como parte de uma dificuldade maior do mecanismo dominante em retornar respostas corretas.
Além de erros nos resultados, o texto aponta que a forma como a IA se interpõe entre o usuário e fontes originais pode tornar páginas existentes praticamente “indescobertas”. Também são citados exemplos de apagamento de arquivos e redução de acesso, como a exclusão de grande parte do arquivo do FiveThirtyEight e a pressão sobre o Internet Archive e a Wayback Machine, que enfrentam ataques cibernéticos, processos e bloqueios de rastreadores.
#InteligenciaArtificial · #IA · #Google · #BuscaComIA · #Alucinacoes · #InternetArchive · #WaybackMachine
Quarta · 05 ago
2026-08-05
2 matérias
IA
Pesquisa · IA
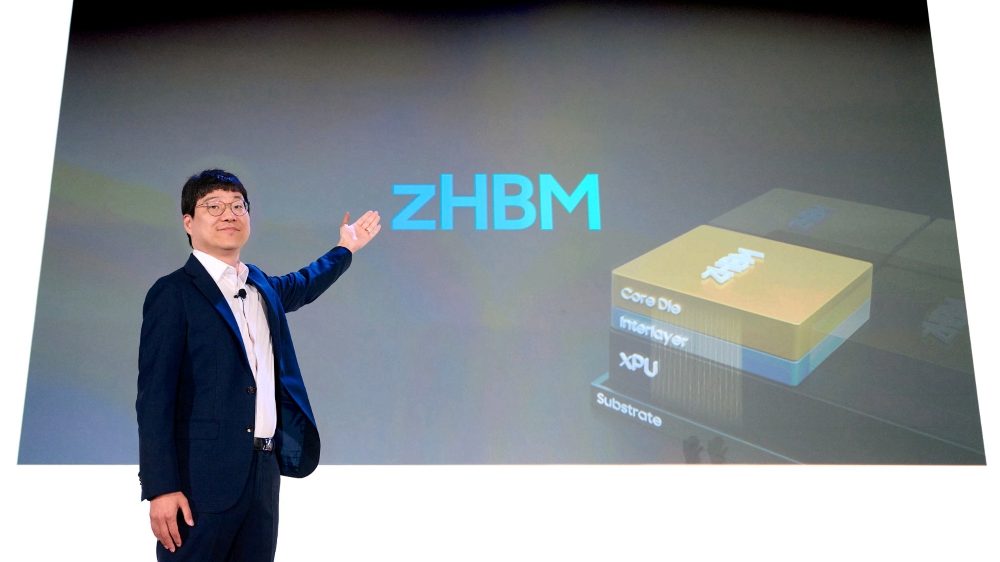
A Samsung anunciou uma nova geração de memórias 3D para inteligência artificial, com a arquitetura zHBM, que empilha a memória verticalmente sobre os chips de processamento. A empresa afirma que a abordagem reduz a distância entre memória e compute e pode entregar até 8 vezes mais velocidade de transferência, além de triplicar a eficiência energética. No evento Future of Memory and Storage 2026, a companhia também citou um marco ao empilhar mais de 400 camadas no mesmo chip e apresentou a memória LPDDR5X-PIM (Processing-in-Memory), além do padrão V10 BV-NAND com aumento de 58% na densidade.
Isso importa porque, em data centers que treinam e rodam LLMs, a memória costuma ser um gargalo: se ela demora, GPUs/CPUs ficam ociosas esperando dados. Com maior largura de banda e processamento mais próximo da memória, a tendência é acelerar cargas de IA e reduzir custos operacionais em escala — com possível efeito indireto em preços e disponibilidade de eletrônicos comuns.
#inteligenciaartificial · #memoriaHBM · #LLM · #datacenter · #ProcessingInMemory · #Samsung
IA
Pesquisa · IA
Uma pesquisa apresentada no arXiv propõe o Zero-Mem, um método de “operações de memória zero-token” para agentes baseados em LLM. A ideia é que, durante o acesso à memória, não sejam feitas chamadas adicionais ao modelo nem sejam consumidos tokens de entrada/saída para gerar registros intermediários. Em vez disso, o sistema preserva os rastros originais da conversa e os organiza em duas visões (um grafo entidade–contexto e uma hierarquia temporal) para recuperar evidências e contexto. Nos testes, o Zero-Mem manteve desempenho competitivo em benchmarks de long-memory e long-context, reduzindo o tempo de operações de memória em 57,6% em relação ao melhor baseline comparado.
Na prática, a abordagem pode tornar agentes mais eficientes e rápidos ao lidar com interações longas, diminuindo custos recorrentes de tokens e latência associados à “mediação” da memória. Para times que constroem agentes e fluxos de QA, isso abre caminho para arquiteturas em que a memória estruturada não depende necessariamente de reprocessar o histórico com o LLM a cada consulta.
#LLM · #agentes de IA · #memória para agentes · #long context · #zero-shot · #arXiv
Sábado · 01 ago
2026-08-01
1 matéria
IA
Destaque
Pesquisa · IA
Uma pesquisa apresenta um framework formal para operadores de atenção em Large Language Models usando Persistent State Machines (PSMs), com provas matemáticas para limites de erro de quantização e uma construção discreta do Softmax sob hipótese de logits limitados. A proposta também é validada com implementação em FPGA: um array de 1024 células em Zynq-7000 (xc7z020) e uma integração em SoC com PCIe no UltraScale+ (xcvu9p), incluindo interconexões AMBA AXI4 e ponte PCIe Gen3 via XDMA. Nos testes, a lógica fechou timing a 62,5 MHz (WNS +1,854 ns) e a simulação com mais de mil vetores aleatórios bateu bit a bit com uma referência em software fix-point.
O que muda na prática é a tentativa de tornar a atenção mais “hardware-friendly”, usando transições locais determinísticas em células estacionárias e gating para reduzir comutação ativa. Para devs/tech, isso sinaliza caminhos para acelerar e baratear inferência de LLM em dispositivos programáveis, com foco em eficiência energética e escalabilidade — embora os números de energia sejam estimativas de ferramenta, não medições em placa.
#LLM · #atenção · #FPGA · #quantização · #Softmax discreto · #hardware acceleration · #state machines