A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
Um trabalho publicado no arXiv discute como sistemas de IA ainda são, em grande parte, “estreitos”, focados em competências limitadas como interpretação de imagens, processamento de linguagem natural e classificação. Os autores defendem que estudar mecanismos ligados à inteligência humana pode ajudar a incorporar capacidades mais amplas aos sistemas de IA. A proposta se baseia na teoria de “pensar rápido e lento” de Daniel Kahneman e descreve uma arquitetura multiagente para lidar com problemas de forma mais flexível.
Na arquitetura apresentada, problemas recebidos podem ser resolvidos por agentes do “Sistema 1”, que reagem explorando apenas experiências passadas, ou por agentes do “Sistema 2”, ativados quando é necessário raciocinar e buscar soluções além do esperado para o Sistema 1. O modelo inclui uma representação do mundo com conhecimento do domínio e uma representação de “si”, com informações sobre ações anteriores e sobre as habilidades dos solucionadores.
Um trabalho no arXiv propõe que redes neurais, apesar de operarem com vetores contínuos, podem desenvolver internamente uma estrutura simbólica. Os autores mostram que representações vetoriais de diferentes redes neurais podem ser aproximadas por estruturas simbólicas, permitindo substituir o processo de geração de representações por uma equação de forma fechada sem alterar significativamente o comportamento. O estudo inclui desde redes menores treinadas para manipular listas até grandes modelos de linguagem (LLMs) em domínios como aritmética, lógica, código e linguagem.
A pesquisa também indica que intervenções precisas nas representações internas de um LLM conseguem modificar seu comportamento de forma direcionada. Com isso, os resultados sugerem que a atuação do modelo depende das estruturas simbólicas identificadas, ajudando a aproximar visões tradicionais de inteligência baseada em símbolos do funcionamento vetorial dos sistemas modernos.
Falhas de agentes de IA em produção têm menos a ver com raciocínio e mais com a incapacidade de gerenciar o que entra no contexto: histórico de conversas, prompts grandes, definições extensas de ferramentas e saídas que crescem a cada interação. Com o acúmulo, o agente “afoga” em sua própria memória e paga um custo de tokens que aumenta a cada turno, levando a esquecimentos dentro e entre conversas.
A pesquisa defende que o problema não deve ser tratado apenas como armazenamento e busca, mas como uma questão de ciclo de vida e arquitetura do contexto. O trabalho propõe a disciplina Agentic Context Management (ACM), com cinco primitivas (arquitetar, ingerir, delimitar, antecipar e compactar/consolidar), além de uma implementação de referência chamada Maximem Synap, que reporta 92% no LongMemEval e 93,2% no LoCoMo.
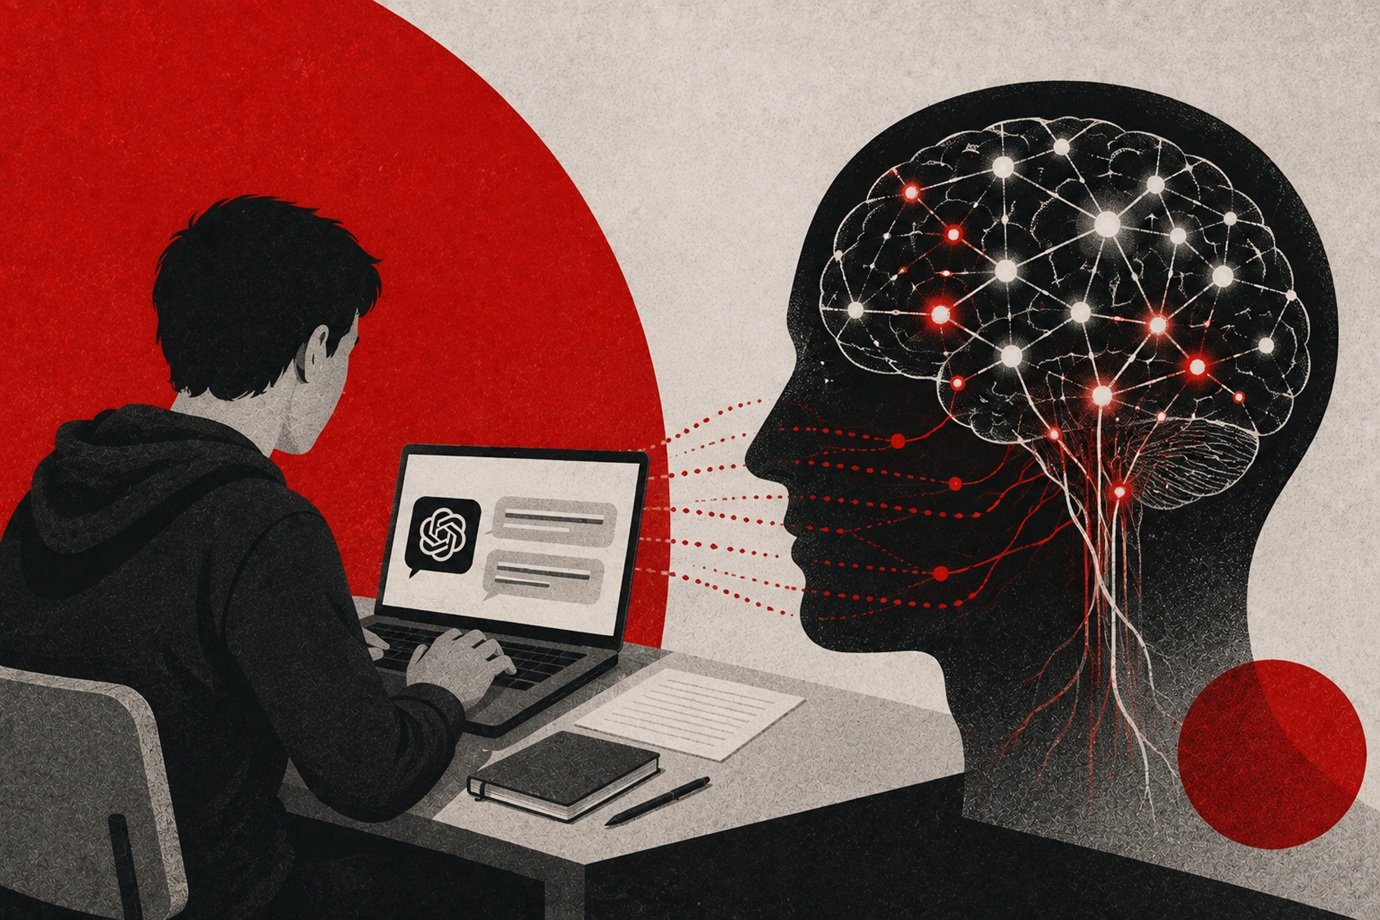
Pesquisadores do MIT analisaram a atividade cerebral de 54 jovens durante tarefas de escrita com auxílio de IA e encontraram diferenças na conectividade neural. O estudo, publicado no arXiv e ainda sem revisão por pares, dividiu os participantes em três grupos: um usou o ChatGPT, outro recorreu ao Google e um terceiro escreveu sem ferramentas digitais.
Na quarta sessão, parte dos voluntários trocou de grupo. Quem escreveu sem IA teve maior conectividade entre regiões do cérebro, enquanto o grupo que usou o ChatGPT apresentou menores níveis de conectividade, mais dificuldade para lembrar trechos do próprio texto e menor sensação de autoria; os autores levantam a hipótese de “dívida cognitiva”, mas ressaltam que os resultados são específicos para a tarefa e não provam danos permanentes.
Pesquisadores propuseram a “Red Queen Gödel Machine”, um método para agentes de IA autoaperfeiçoados melhorarem de forma recursiva ao testar e ajustar seu próprio código sem esbarrar no limite imposto por avaliadores e benchmarks fixos. A abordagem faz o agente e o avaliador evoluírem juntos, elevando progressivamente a dificuldade da avaliação conforme o sistema melhora, o que mantém o ciclo ancorado em checagens confiáveis.
Em tarefas como escrita e revisão de artigos científicos, o framework elevou taxas de aceitação em 1,78× a 1,86× com um painel de “agente como juiz”, e aumentou em 9% a acurácia em relação ao ground truth para avaliadores coevoluídos. O trabalho também aponta redução de custos ao combinar modelos abertos com ferramentas mais caras, como o uso de NVIDIA Nemotron 3 Ultra junto ao ChatGPT-5.5, reduzindo em cerca de 13 vezes os custos de search-token; o método está em pré-print no arXiv e deve ser open sourced.
Uma pesquisa apresentada no arXiv propõe o Zero-Mem, um método de “operações de memória zero-token” para agentes baseados em LLM. A ideia é que, durante o acesso à memória, não sejam feitas chamadas adicionais ao modelo nem sejam consumidos tokens de entrada/saída para gerar registros intermediários. Em vez disso, o sistema preserva os rastros originais da conversa e os organiza em duas visões (um grafo entidade–contexto e uma hierarquia temporal) para recuperar evidências e contexto. Nos testes, o Zero-Mem manteve desempenho competitivo em benchmarks de long-memory e long-context, reduzindo o tempo de operações de memória em 57,6% em relação ao melhor baseline comparado.
Na prática, a abordagem pode tornar agentes mais eficientes e rápidos ao lidar com interações longas, diminuindo custos recorrentes de tokens e latência associados à “mediação” da memória. Para times que constroem agentes e fluxos de QA, isso abre caminho para arquiteturas em que a memória estruturada não depende necessariamente de reprocessar o histórico com o LLM a cada consulta.