A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
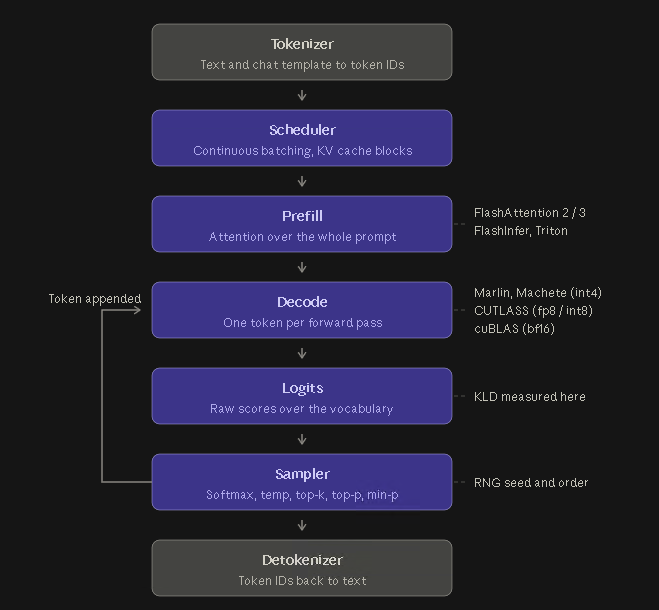
Usuários que baixam modelos locais, inclusive versões quantizadas, podem ter a impressão de que o LLM “fica pior” do que o esperado. O texto explica que cada combinação de hardware e software executa a inferência de forma diferente, alterando como as probabilidades do próximo token são calculadas e convertidas em texto durante o decode.
A recomendação é medir o desempenho com benchmarks que representem o uso real, evitando testes curtos e zero-shot com poucos prompts. Também é destacada a cautela com alegações de baixa KLD em cards de modelos quantizados, já que interpretar esses números depende de detalhes como ambiente de execução, checkpoints de referência e metodologia completa.
Uma pesquisa apresentada no arXiv propõe o Zero-Mem, um método de “operações de memória zero-token” para agentes baseados em LLM. A ideia é que, durante o acesso à memória, não sejam feitas chamadas adicionais ao modelo nem sejam consumidos tokens de entrada/saída para gerar registros intermediários. Em vez disso, o sistema preserva os rastros originais da conversa e os organiza em duas visões (um grafo entidade–contexto e uma hierarquia temporal) para recuperar evidências e contexto. Nos testes, o Zero-Mem manteve desempenho competitivo em benchmarks de long-memory e long-context, reduzindo o tempo de operações de memória em 57,6% em relação ao melhor baseline comparado.
Na prática, a abordagem pode tornar agentes mais eficientes e rápidos ao lidar com interações longas, diminuindo custos recorrentes de tokens e latência associados à “mediação” da memória. Para times que constroem agentes e fluxos de QA, isso abre caminho para arquiteturas em que a memória estruturada não depende necessariamente de reprocessar o histórico com o LLM a cada consulta.