A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
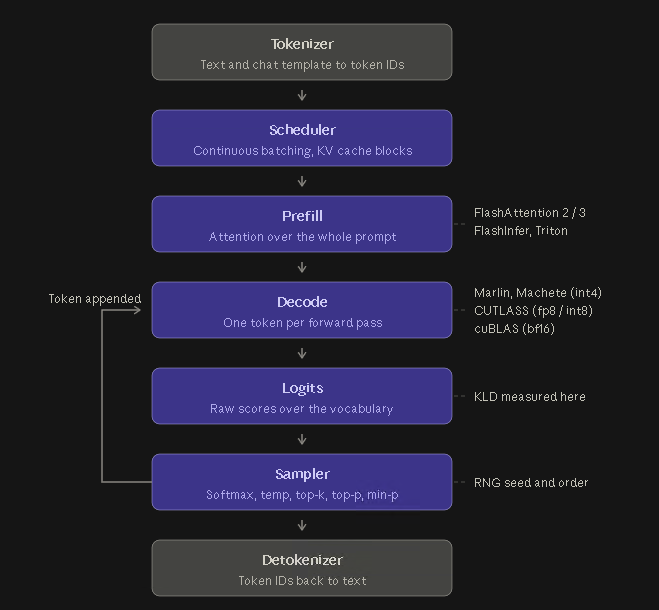
Usuários que baixam modelos locais, inclusive versões quantizadas, podem ter a impressão de que o LLM “fica pior” do que o esperado. O texto explica que cada combinação de hardware e software executa a inferência de forma diferente, alterando como as probabilidades do próximo token são calculadas e convertidas em texto durante o decode.
A recomendação é medir o desempenho com benchmarks que representem o uso real, evitando testes curtos e zero-shot com poucos prompts. Também é destacada a cautela com alegações de baixa KLD em cards de modelos quantizados, já que interpretar esses números depende de detalhes como ambiente de execução, checkpoints de referência e metodologia completa.
Musical Spirograph leva o conceito do Spirograph para uma aba do navegador, usando equações matemáticas para mover pontos pela tela e gerar padrões como hypotrochoids e epitrochoids. Ao cruzar anéis concêntricos, esses pontos disparam notas musicais, transformando desenhos geométricos em composições. A ferramenta também permite ajustar parâmetros como quantização e BPM, além de ampliar os anéis até duas oitavas.
Para personalizar o resultado, o Musical Spirograph oferece seis rotores virtuais, até três braços desenhando ao mesmo tempo e opções de escala e notas. Há ainda seis presets de synth e controles para customizar a música gerada, embora o motor de som seja descrito como sujeito a clipping e artefatos. Mesmo com essas limitações, a proposta é criar e explorar composições generativas diretamente no browser.
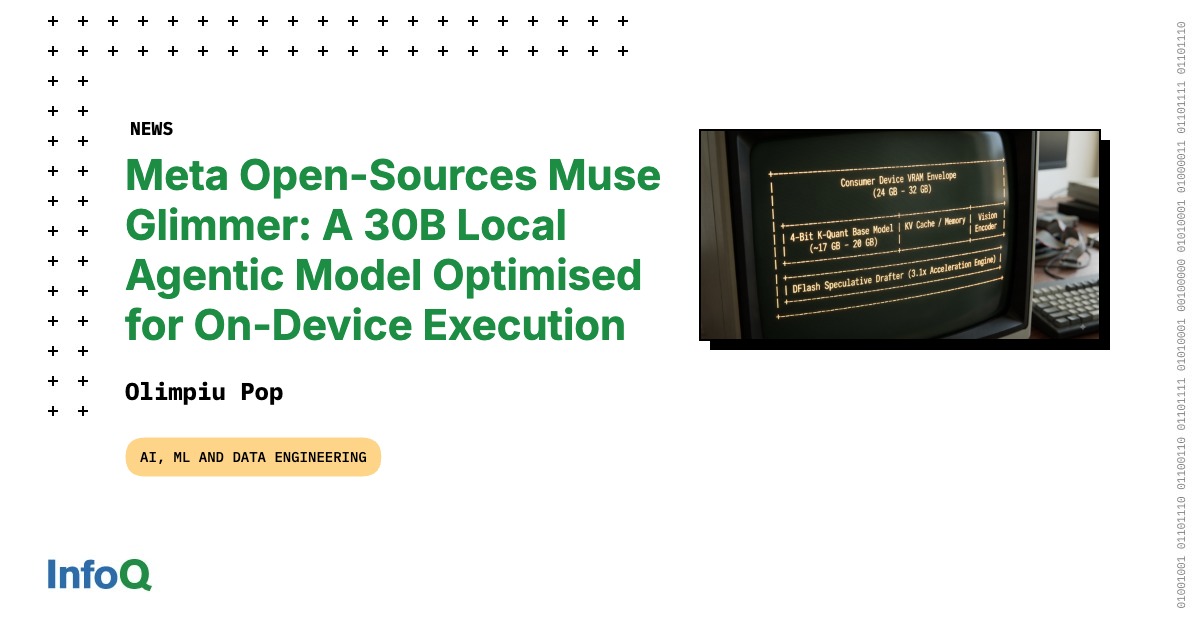
A Meta AI Research lançou o Muse Glimmer, um modelo open-weight de 30 bilhões de parâmetros sob licença Apache 2.0. Projetado para execução local “always-on”, ele permite que desenvolvedores rodem agentes autônomos, invocação complexa de ferramentas, execução de código e avaliações “LLM-as-a-judge” diretamente em GPUs e workstations, sem depender de APIs em nuvem.
Para caber em orçamentos de memória de hardware comum, o Muse Glimmer usa quantização dinâmica 4-bit para reduzir o tamanho para cerca de 17 GB a 20 GB e combina um “drafter” DFlash para validar blocos com múltiplos tokens em paralelo, com ganhos de throughput reportados de até 3,1x. O modelo também inclui um encoder de percepção de 1,8B para inputs multimodais e foi treinado para diagnosticar falhas (como erros de chamadas de API ou comandos no terminal) e tentar caminhos alternativos, com suporte a frameworks como OpenClaw.
Uma pesquisa apresenta um framework formal para operadores de atenção em Large Language Models usando Persistent State Machines (PSMs), com provas matemáticas para limites de erro de quantização e uma construção discreta do Softmax sob hipótese de logits limitados. A proposta também é validada com implementação em FPGA: um array de 1024 células em Zynq-7000 (xc7z020) e uma integração em SoC com PCIe no UltraScale+ (xcvu9p), incluindo interconexões AMBA AXI4 e ponte PCIe Gen3 via XDMA. Nos testes, a lógica fechou timing a 62,5 MHz (WNS +1,854 ns) e a simulação com mais de mil vetores aleatórios bateu bit a bit com uma referência em software fix-point.
O que muda na prática é a tentativa de tornar a atenção mais “hardware-friendly”, usando transições locais determinísticas em células estacionárias e gating para reduzir comutação ativa. Para devs/tech, isso sinaliza caminhos para acelerar e baratear inferência de LLM em dispositivos programáveis, com foco em eficiência energética e escalabilidade — embora os números de energia sejam estimativas de ferramenta, não medições em placa.