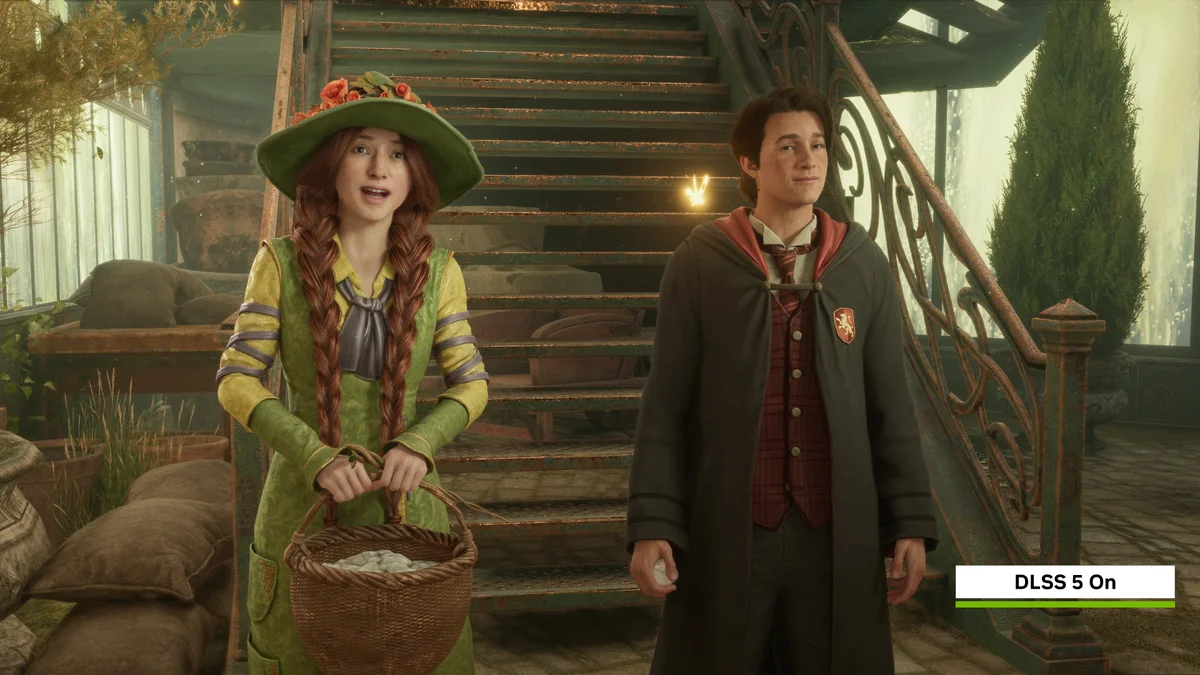Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
A NVIDIA atualizou o DLSS 5 com mudanças na renderização neural e anunciou que a tecnologia passa a consumir 20% menos VRAM em resolução 4K. A empresa também afirma um salto de desempenho de até 10x em comparação com a primeira demo, citando que uma GeForce RTX 50, incluindo a RTX Spark, alcança esse ganho sem a necessidade de duas RTX 5090.
Com a atualização mais recente do processamento neural, o DLSS 5 elevou o desempenho de cerca de 240 FPS para mais de 300 FPS no NBA 2K27, primeiro jogo a receber a implementação nativamente. Hogwarts Legacy chega com DLSS 5 em 5 de novembro, enquanto Where Winds Meet deve receber a tecnologia no fim de novembro; a RTX Remix também ganha suporte ao DLSS 5 em 23 de outubro, e o NVIDIA App passa a oferecer um modo performance para o frame gen (Preset C), com ganho de 35% em testes em uma RTX 5060.
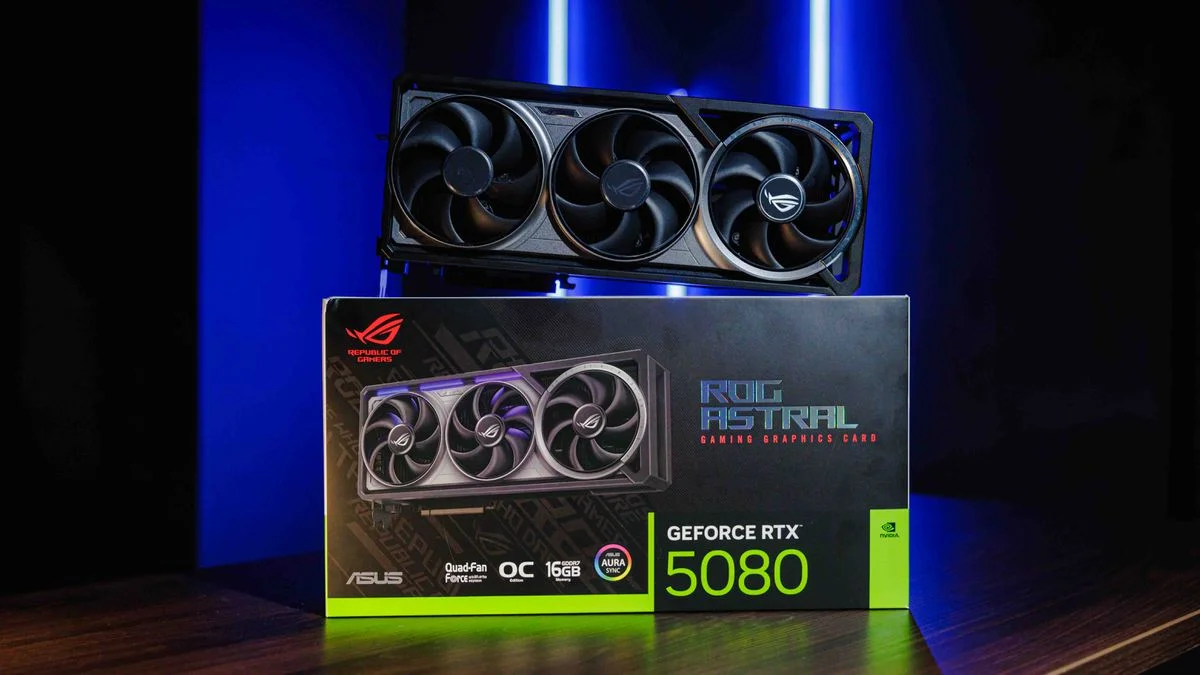
Rumores indicam que a NVIDIA planeja lançar uma nova GeForce RTX 5080 com 24 GB de VRAM, para o começo de 2027, substituindo a versão atual de 16 GB. A informação não oficial, atribuída ao Benchlife, também sugere que as parceiras da empresa ainda não receberam detalhes formais, apenas “notificações verbais” sobre o repasse de informações em breve.
O rumor levanta a dúvida se essa GPU seria uma “RTX 5080 SUPER”, já que, em discussões anteriores sobre a linha SUPER, a mesma quantidade de memória aparecia associada ao modelo. Com mais VRAM, a RTX 5080 de 24 GB pode abrir espaço para usos com treinamento de IA, que costuma exigir mais memória de vídeo, além de atender cenários em jogos em 4K que podem ultrapassar 16 GB com Ray/Path Tracing e geradores de quadros.
O mini-AGI é um modelo de linguagem byte-level com aprendizado contínuo: ele monta sua própria arquitetura, treina do zero em uma única GPU com 8 GB de VRAM e segue aprendendo a partir de tudo o que lê. O sistema mantém os pesos como arquivos no disco e faz paginação para a GPU conforme necessário, limitando o tamanho do modelo pela capacidade de armazenamento e não pela VRAM.
O projeto afirma que o treino não precisa parar: o modelo lê um fluxo de caracteres em chunks, atualiza por gradiente a cada etapa e usa o mesmo caminho tanto para treinar quanto para gerar. Os pesos ainda não foram publicados, e o run está na primeira passagem pelo corpus, prevista para completar em algumas semanas; a proposta é demonstrar que é possível aprender continuamente sem “catastrophic forgetting” mesmo com hardware modesto.
GTA 6 chega ao PlayStation 5 e ao Xbox Series a partir de 19 de novembro, enquanto os jogadores de PC ainda aguardam uma data indefinida. O primeiro trailer de gameplay foi exibido em um PS5 base e destaca reflexos com Ray Tracing e outros efeitos gráficos, levantando a dúvida sobre o peso disso no hardware do PC.
O texto aponta que o PS5 base não tem suporte ao upscaling por aprendizado de máquina da Sony (PSSR), o que pode influenciar a resolução final e a forma como os efeitos são entregues. Para o PC, a expectativa é de melhor desempenho com GPUs intermediárias e high-end, com uso de tecnologias como DLSS/FSR e, em placas mais fortes, possibilidade de Path Tracing; também são citados cenários de requisitos com VRAM acima de 12 GB, RAM de 32 GB e armazenamento que deve passar de 100 GB.
O projeto FreeToken, open-source, foi apresentado por pesquisadores da UC Berkeley e do MIT como uma engine de inferência para aproximar modelos MoE de ponta do uso em hardware consumidor. A proposta trata o PC do usuário como uma “fábrica” de computação elástica e heterogênea, em vez de apenas um nó de datacenter com limitações.
Para reduzir gargalos de decodificação em MoE, o FreeToken substitui o offloading estático por uma política dinâmica (q*) que divide a computação entre CPU e GPU conforme a taxa de interconexão. O sistema usa um formato de pesos (FTW) e double buffering para sobrepor streaming via PCIe com camadas ativas, além de gerenciar VRAM em tempo de execução sem recarregar o modelo, com ganhos reportados como ~39 tokens/s no Qwen3.6-35B em um RTX 4060 de 8GB.
Modelos de linguagem que alimentam bots como ChatGPT e Gemini podem ser executados localmente no seu computador, oferecendo acesso offline e mais privacidade por não enviar dados para a nuvem. A proposta também evita assinaturas mensais e limites de uso cobrados por plataformas, já que há diversos LLMs gratuitos para download, incluindo opções de Meta e Google.
O processo envolve escolher um sistema operacional compatível (Windows, macOS e Linux), garantir memória suficiente e, idealmente, uma GPU dedicada com VRAM. Para começar, o texto destaca o LM Studio Bionic como uma opção gratuita, mostrando como criar projetos, selecionar modelos, gerenciar bibliotecas e usar configurações para ajustar o funcionamento do chatbot local.
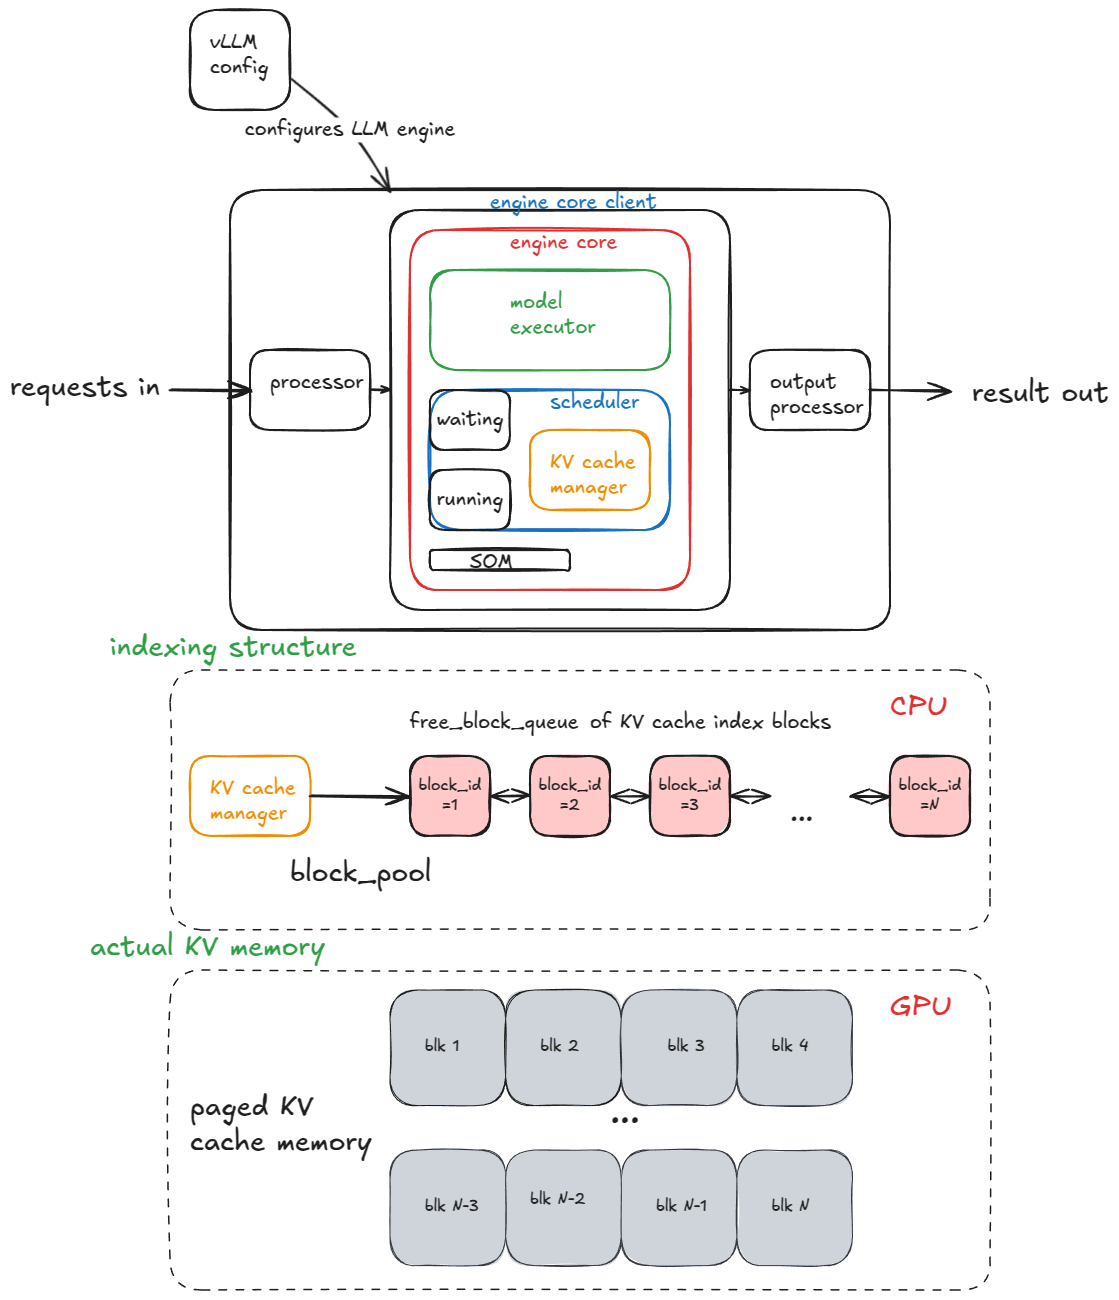
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.