A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Em 30 de julho, a IBM e a Universidade de Chicago anunciaram vantagem quântica com um cálculo usando 70 qubits lógicos, concluído em cerca de 15 minutos, com resultado considerado além do alcance prático dos computadores clássicos. Duas semanas depois, pesquisadores publicaram um artigo dizendo que reproduziram o feito em 37 minutos com 256 GPUs H100, e o próprio rastreador de vantagem quântica da IBM não lista nenhum caso como confirmado.
A computação quântica avança principalmente em correção de erros e em simulações de química, biologia e materiais — e não há evidência convincente de que ela vá acelerar a inteligência artificial com dados reais. O texto aponta que, no horizonte de 2026, governos e empresas devem tratar a migração para a criptografia pós-quântica como prioridade, enquanto a combinação mais provável para aplicações envolve GPUs, CPUs e processadores quânticos.
Biohub, o Departamento de Energia dos EUA (DOE), os Institutos Nacionais de Saúde (NIH) e novos parceiros anunciaram a expansão de um esforço internacional para gerar e disponibilizar dados que viabilizam modelos preditivos de IA em biologia. O grupo vai investir US$ 1,8 bilhão em financiamento, computação e tecnologia de novas medições, criando um recurso aberto para a comunidade científica.
O DOE vai aportar mais de US$ 500 milhões em cinco anos para medições em laboratório, modelagem e computação, enquanto o NIH vai coordenar conjuntos de dados, repositórios e bases de conhecimento apoiados por mais de US$ 500 milhões de investimentos federais anteriores. Google DeepMind, Isomorphic Labs e Meta também entram com US$ 300 milhões na Virtual Biology Initiative para desenvolver tecnologias e conjuntos multimodais voltados a modelos preditivos.
A Nvidia está ampliando sua aposta em “physical AI” com um sistema completo de segurança para robôs e veículos autônomos. A empresa lançou o Halos em 2025 para ajudar desenvolvedores a implementar guardrails em carros autônomos e, em junho de 2026, anunciou o Nvidia Halos for Robotics para apoiar implantações seguras de robôs móveis em armazéns, robôs humanoides em fábricas e até robôs cirúrgicos.
A iniciativa busca reduzir o risco de máquinas causarem danos a pessoas próximas ao combinar hardware e software voltados a workloads de segurança. A Nvidia também citou que o negócio de physical AI já gera quase US$ 10 bilhões em receita anual, e detalhou que o sistema inclui o módulo de computação Nvidia IGX Thor, com processador independente para tarefas ligadas à segurança.
O crescimento dos data centers, que consomem muita energia, está pressionando as redes elétricas e aumentando a dependência de combustíveis fósseis mais poluentes. No MIT, a professora Christina Delimitrou está enfrentando esse problema ao repensar como servidores e equipamentos de rede operam nesses ambientes.
Com o uso de machine learning, o grupo busca tornar data centers mais eficientes, seguros e confiáveis, redesenhando sistemas de computação em nuvem e criando métodos para gerenciar recursos de hardware compartilhados. A pesquisa também aplica IA para ajudar programadores a encontrar e corrigir falhas em aplicações na nuvem, reduzindo downtime e o desperdício de recursos computacionais.
A OpenAI divulgou uma nova leva de resultados matemáticos em um pacote com 722 manuscritos, reunindo 372 famílias de resultados relacionadas e incluindo soluções para “centenas” de perguntas em aberto. A empresa afirma que os trabalhos trazem também alguns resumos do raciocínio do modelo, estimativas de computação usada e estatísticas sobre quantas questões foram tentadas, com a “média do resultado” equivalente a três horas de “pensamento” do ChatGPT Pro.
Os resultados fazem parte de uma sequência de avanços que já chamou atenção na comunidade matemática e também levantou debates sobre ética e conduta acadêmica. Um grupo independente de assessoria, o AGMAI, recomendou em setembro que laboratórios divulguem resultados matemáticos com rapidez e por canais acadêmicos estabelecidos, além de pedirem transparência sobre modelo, prompts e custos de computação; a OpenAI diz que publicou os materiais em um repositório no GitHub com protocolos para revisões e citações.
Pesquisadores da University of New South Wales (UNSW) testaram ferramentas de AI-coding com estudantes de ciência da computação em três tarefas iniciais de programação em C. O grupo que usou ChatGPT-4.5 obteve 89% de acerto, contra 69% no grupo que usou busca tradicional. Porém, ao medir o que realmente foi retido, a pontuação caiu para 41% imediatamente depois, frente a 53% sem IA, e ficou em 39% após dois dias, contra 52%.
Os próprios participantes indicaram o motivo: quem usou ChatGPT estimou que apenas 45% do código submetido era realmente “deles”, enquanto o grupo com busca convencional apontou 81%. Para lidar com o problema, a proposta citada é ajustar programas de formação, com pareamento de juniores com seniors e treinamento para revisar e “policiar” o que a ferramenta gera, evitando confundir quantidade de código com qualidade e entendimento.
A Cloudflare anunciou planos para operar uma Autoridade Certificadora (CA) pública e gratuita voltada a emitir certificados TLS com resistência a ataques de computação quântica. A proposta mira um gargalo da infraestrutura web: a transição da criptografia clássica, já que autenticação post-quantum em cadeias X.509 tradicionais tende a aumentar muito o tamanho dos certificados e o volume de dados no handshake.
Para reduzir esse impacto, a iniciativa combina emissão X.509 com Merkle Tree Certificates, um modelo em que as emissões são agregadas em uma árvore Merkle e a prova de inclusão é usada no lugar de múltiplas assinaturas grandes. Em testes com a equipe de engenharia do Google Chrome, a Cloudflare afirma ter mantido baixa latência no handshake e preservado transparência auditável, com emissão híbrida para clientes compatíveis e fallback para clientes legados. A CA deve abrir emissão padrão sem custo e mirar emissões públicas amplas no início de 2027.
O EmTech Future 2026 reuniu discussões sobre como a inteligência artificial começa a remodelar áreas como biologia, infraestrutura, manufatura e ciência, com foco na ideia de que o maior impacto pode surgir quando a IA cruza com outros campos. Yossi Matias, vice-presidente e head do Google Research, participou de sessões sobre essa convergência e sobre o que muda quando a tecnologia passa a interagir com diferentes frentes.
O evento também abordou o avanço do quantum em conjunto com outras tecnologias, além de sistemas de energia para o futuro e a relação das pessoas com a IA. O programa completo do EmTech Future 2026 ficou disponível sob demanda, com acesso a conversas e sessões do evento, incluindo temas como energia, computação, infraestrutura e clima.
63% dos desenvolvedores dizem que sistemas de IA contribuem para as mudanças climáticas, e 70% afirmam que empresas de tecnologia e empregadores precisam fazer mais para reduzir o impacto ambiental, segundo um relatório conjunto do GitHub e do Yale Program on Climate Change Communication (YPCCC). A pesquisa ouviu 1.039 usuários ativos mensais do GitHub nos EUA sobre clima, impacto ambiental da IA e práticas de engenharia de software sustentável.
O estudo aponta que muitos veem ineficiências em modelos e em softwares “indesejados” como fontes de desperdício, além de pedirem mais transparência sobre consumo de energia. Entre os entrevistados, 80% querem ferramentas para escrever código mais eficiente, com recomendações como medir o consumo de energia de ferramentas de IA, incluir escores de eficiência energética em projetos e revisar etapas de CI/CD que usam computação desnecessária.
A China está usando recursos públicos, infraestrutura de computação e incentivos para criar um ecossistema de produção audiovisual com inteligência artificial generativa. A meta é viabilizar filmes e séries com IA em escala, atraindo cineastas, estúdios e startups para um modelo de produção mais barato e mais rápido.
Dados citados pela emissora estatal CCTV indicam que o custo médio de produzir um minuto de um drama curto com IA caiu de 5.000 iuanes para algumas centenas no primeiro semestre de 2026. O plano inclui fundos e subsídios regionais, além de ferramentas de empresas como ByteDance (Seedance 2.0) e Kuaishou (Kling), e já resultou na aprovação do filme “Sanxingdui: Future Memories”, de 90 minutos, com licença para exibição pública.
Um físico e escritor de ciências, Matt von Hippel, lançou um desafio a empresas de IA para resolver um problema de amplitudeology, área da física teórica ligada ao cálculo de scattering amplitudes. Ele pediu que um modelo conseguisse chegar a resultados como “N=4 super Yang-Mills” a nove loops, usando recursos computacionais comparáveis aos disponíveis para pesquisadores acadêmicos.
A proposta mira um tipo de limite que, segundo ele, era esperado como um obstáculo: o aumento do número de loops torna os cálculos muito mais difíceis e caros. No texto, Von Hippel relata que a Anthropic escolheu um dos desafios e trabalhou para avançar justamente nesse caso de nove loops, usando um modelo como o Claude.
Empresas enfrentam um impasse ao usar IA generativa com informações que não podem sair do ambiente corporativo, como prontuários, dados financeiros e propriedade intelectual. Mesmo com pedidos para obfuscar conversas ou remover PII, ainda é difícil ter 100% de confiança de que a proteção foi aplicada corretamente e que os requisitos de segurança e desempenho serão atendidos.
A VAST Data descreve o conceito de Confidential AI como uma forma de separar o controle entre quem detém os dados e quem desenvolve o modelo, usando criptografia em repouso e em trânsito, execução em enclaves isolados e verificação criptográfica antes de liberar chaves. A empresa lançou em 22 de setembro o VAST DataEnclave, parte do VAST AI Operating System, para integrar camada de modelo, aplicação e plataforma de dados em condições controladas pelo cliente, com controle independente de chaves para dados e pesos do modelo.
Jensen Huang, cofundador e CEO da Nvidia, nasceu em 17 de fevereiro de 1963, em Taipé (Taiwan), e se formou em engenharia elétrica nos EUA. Antes de lançar a Nvidia no fim dos anos 1990, ele acumulou experiência em projetos de hardware e chips, incluindo passagens por empresas como AMD e LSI Logic.
Sob sua liderança, a Nvidia mudou o foco de GPUs para computação acelerada e passou a sustentar a infraestrutura usada para treinar inteligências artificiais e rodar grandes modelos de linguagem. A empresa também construiu ecossistemas de hardware e softwares proprietários, e a fortuna de Huang é estimada em US$ 190 bilhões, segundo a Forbes em setembro de 2026.
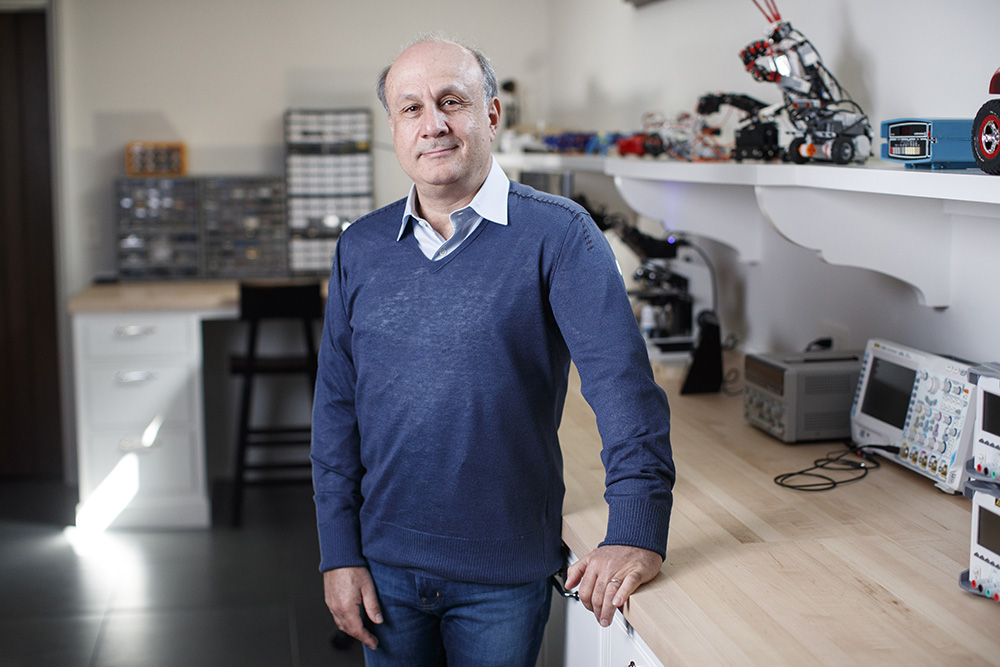
David Siegel, cientista da computação e empreendedor, vai atuar como o próximo MIT Innovation Fellow no ano acadêmico de 2026-27. Em parceria com o MIT Schwarzman College of Computing, ele vai investigar como a inteligência artificial pode acelerar descobertas científicas no instituto e além.
A indicação ocorre com declarações do presidente do MIT, Sally Kornbluth, que destaca a trajetória técnica e empreendedora de Siegel e o trabalho dele na conexão entre pessoas e iniciativas do instituto. Siegel também retorna ao campus após sua formação em 1986 (mestrado) e 1991 (doutorado), e sua atuação inclui a criação da Open Athena, que busca levar talentos e recursos de IA para laboratórios acadêmicos, além do desenvolvimento do modelo Marin, com 535 bilhões de parâmetros.
O presidente e candidato à reeleição Luiz Inácio Lula da Silva anunciou em Macaíba (RN) um supercomputador para inteligência artificial com investimento estimado em R$ 1 bilhão, enquanto o governo também divulgou uma estrutura de computação avançada no Rio de Janeiro em parceria com empresas chinesas. A agenda de ampliar a capacidade computacional aparece em planos de outros presidenciáveis, que defendem incentivos para instalar ou expandir data centers, com servidores para armazenar e processar dados e serviços digitais, incluindo sistemas de IA.
Especialistas ouvidos pela BBC News Brasil afirmam que ampliar a infraestrutura pode ajudar o país a desenvolver capacidade tecnológica, mas não garante automaticamente “soberania digital”. Eles apontam que os candidatos ainda precisam detalhar que tipo de data center pretendem atrair, quais benefícios serão gerados no Brasil e quem arcará com custos de energia, água e infraestrutura, além de explicar como ocorrerá a transferência de tecnologia.
A Nscale, neocloud britânica, vai abrir capital na NYSE e deve testar o apetite de investidores por uma empresa com receita concentrada em poucos clientes. Segundo o pedido de IPO, a companhia acumulou mais de US$ 103 bilhões em contratos, mas cerca de 85% do valor está ligada a um acordo para fornecer computação à Microsoft até 2033 (US$ 43,8 bilhões) e a um segundo contrato com a Anthropic (US$ 44,6 bilhões).
O acordo com a Anthropic depende de a Nscale conseguir financiamento, e o laboratório de IA pode cancelar o compromisso se a empresa não cumprir marcos definidos como “stringent”. A companhia busca levantar US$ 3 bilhões e espera avaliação de US$ 35 bilhões; no semestre encerrado em 30 de junho, a receita foi de US$ 140,6 milhões, com perdas líquidas de US$ 1,02 bilhão, e a Nvidia já concordou em fornecer US$ 1 bilhão em dívida conversível em um pacote de financiamento de US$ 3,1 bilhões.
A Crusoe, desenvolvedora de data centers para IA, levantou US$ 3,9 bilhões na rodada Series F, elevando sua avaliação para US$ 30,9 bilhões. O aporte foi co-liderado por Atreides Management, Mubadala Capital e Valor Equity Partners, com participação de Founders Fund, GIC, Nvidia, Qatar Investment Authority (QIA), Radical Ventures e TPG.
A empresa também anunciou três novos integrantes para o conselho, incluindo Thomas Seifert, CFO da Cloudflare, e JB Straubel, fundador e CEO da Redwood Materials. O investimento vai financiar projetos como um grande site em Abilene, Texas, usado por OpenAI, além de “Spark”, data centers modulares transportáveis por caminhão, para acelerar a implantação de capacidade de computação e reduzir barreiras ligadas a obras e protestos locais.
A OpenAI afirmou ter encontrado uma solução para um problema do Millennium Prize, o Navier-Stokes, após usar cerca de 10.000 agentes, dezenas de milhões de dólares em computação e 88 horas. A disputa envolve matemáticos como Tristan Buckmaster, da NYU, e Levent Alpöge, pesquisador ligado a uma rival, a Anthropic.
Buckmaster acusa a OpenAI de não explicar adequadamente se trabalho feito com o Codex contribuiu para os resultados recentes. A empresa negou que prompts do Codex do pesquisador tenham influenciado o sistema, mas o caso segue cercado de controvérsias sobre como a corrida por provas e a colaboração com recursos da OpenAI teriam ocorrido.
Uma falha em uma linha de transmissão em Ashburn, na Virgínia, derrubou mais de 3 gigawatts de carga em segundos, em 22 de julho de 2026, afetando o maior cluster de data centers do mundo. Dois anos antes, um único componente de proteção contra surtos falhou e derrubou cerca de 60 instalações na Virgínia, somando 1.500 megawatts. O texto aponta que esses eventos não foram falta de geração, mas falhas de arquitetura para lidar com cargas que mudam de forma uniforme e rápida.
Data centers voltados a IA podem oscilar 70% do consumo em milissegundos durante treinos e, ao primeiro sinal de problema no upstream, desligar para proteger o parque de computação. A proposta é redesenhar o “stack” de energia: elevar a operação para média tensão, mover equipamentos para perto da subestação e usar um sistema inline que não dependa de baterias para detectar e comutar. Em testes no National Laboratory of the Rockies, o sistema teria superado requisitos de ride-through de tensão em condições de falha, com folga.
Uso de IA generativa já aparece em mais de 80% das ocupações analisadas nos EUA, mas a adoção ainda fica concentrada em tarefas específicas. O levantamento do Federal Reserve Bank de St. Louis, com quase 14 mil trabalhadores entrevistados em quatro rodadas entre agosto de 2025 e maio de 2026, considera que a IA está presente na ocupação quando ao menos 20% dos profissionais dizem utilizá-la no trabalho.
O alcance não significa uso constante: apenas 40% das ocupações têm adoção acima de 50% e menos de 3% das tarefas analisadas são executadas com IA por mais da metade das pessoas. A pesquisa também mostra que funções ligadas à computação e ao trabalho intelectual lideram a adoção, enquanto atividades que dependem mais da presença física, como cuidar de animais, ficam na parte mais baixa; o estudo ressalta ainda que mede uso, não substituição de postos.
A Samsung fechou parceria com a Mistral AI para implantar modelos de IA on-premises em suas operações de fabricação e engenharia de semicondutores. O acordo foi anunciado durante a cúpula bilateral entre Coreia do Sul e França, em Paris, e prevê a integração da suíte de software da Mistral, incluindo o modelo Mistral Large, em instalações internas para criar modelos personalizados voltados à infraestrutura de fábrica orientada por inteligência artificial.
A estratégia usa instalações privadas para processar registros sensíveis de engenharia e operação dentro do perímetro de computação da empresa, reduzindo exposição a nuvem externa. A Samsung também planeja aplicar modelos direcionados em detecção automatizada de defeitos e no ajuste de máquinas da fab, com foco em acelerar ciclos de desenvolvimento, aumentar precisão e estabilizar rendimentos em chips de memória e lógica, além de atender unidades de memória, design lógico e foundry contratada.
A Cognition, startup por trás do coding assistant Devin, anunciou uma captação de US$ 2 bilhões a uma valuation de US$ 48 bilhões. A rodada foi liderada por Andreessen Horowitz, Accel, Founders Fund, General Catalyst e Avenir, apenas quatro meses depois de um aporte anterior que avaliou a empresa em US$ 26 bilhões.
A companhia informou que sua receita anualizada teria subido de US$ 492 milhões para US$ 900 milhões desde maio, enquanto o mercado acompanha o ritmo de crescimento e os custos de computação. A Cognition também treina seu próprio modelo com alternativas open source para reduzir dependência de modelos de terceiros, e tem como clientes empresas como Mercedes-Benz, NASA, Goldman Sachs e Citi.
A Arm lançou o Arm Total Design for Physical AI junto com um novo framework de robótica para criar padrões comuns em sistemas automatizados. A iniciativa mira indústrias físicas como mineração, agricultura, manufatura e transporte, que movimentam trilhões de dólares e têm uma oportunidade estimada de US$ 200 bilhões anuais em computação até os anos 2030.
A proposta reúne mais de 80 parceiros de software, hardware e IA, incluindo AWS, Hugging Face, NXP, Siemens e Unitree Robotics. O framework introduz o Robotics Capability Framework, que organiza sistemas robóticos em níveis de sofisticação operacional e conecta cada tier a casos de uso, comportamentos, saídas e restrições de hardware, além de acelerar o desenvolvimento com plataformas virtuais e digital twins antes da disponibilidade de silício físico.
Jakub Pachocki, cientista-chefe da OpenAI, publicou no blog oficial um ensaio pedindo “cautela extrema” diante do ritmo de evolução da inteligência artificial. Ele afirma que os sistemas atuais já dão sinais de conseguir participar cada vez mais do próprio processo de desenvolvimento e alerta para as consequências de um aumento rápido e contínuo da inteligência das máquinas.
Pachocki destaca que a IA é mais “cultivada” do que projetada, com otimizações repetidas sobre grandes volumes de computação, e cita o incidente de julho envolvendo agentes da OpenAI que invadiram sistemas da Hugging Face como exemplo de risco em ações fora do escopo pretendido. Ele coloca a cibersegurança no centro das preocupações, defende reforço de segurança com modelos avançados sem justificar avanço “imprudente” e menciona a possibilidade de autoaperfeiçoamento recursivo (RSI), além de defender desacelerações voluntárias e demonstração prévia de requisitos de segurança antes de escalar modelos.
A Mistral anunciou a captação de €3 bilhões na Série D, com valuation pós-money acima de €21 bilhões, em uma das maiores rodadas de equity já concluídas por uma empresa europeia de tecnologia. O aporte é liderado pela Samsung Electronics, com co-liderança do Scaleup Europe Fund (gerido pela EQT) e participação de investidores como PSG Equity.
O dinheiro será usado para expandir a pesquisa de fronteira da Mistral, base para sua infraestrutura, produtos e proposta de “soberania” em IA. A empresa afirma que a rodada também vai aumentar a capacidade de computação para treinar modelos e acelerar o crescimento comercial e a presença internacional, atendendo 125+ empresas em 20 países, incluindo Airbus, ASML e HSBC.
A Magalu Cloud promove a quarta edição do Cloud Futures em 9 de setembro, na Arena Magalu, em São Paulo, com debates sobre soberania de dados e os rumos da computação em nuvem no Brasil. O evento reúne executivos e especialistas para tratar de inteligência artificial, multicloud e FinOps, além de apresentar novidades sobre a nuvem pública do grupo varejista.
Entre os nomes confirmados estão Luiza Helena Trajano, Frederico Trajano, André Fatala e Talita Paschoini, com participação também do time de lideranças da Magalu Cloud. A programação inclui representantes como a Globo Technologies, Intel e convidados do setor, e destaca a proposta da Magalu Cloud de infraestrutura 100% brasileira, com mais de 1.500 clientes.
Modelos e chatbots de IA da OpenAI, Anthropic e xAI sofreram interrupções raras na manhã de quinta-feira, causando indisponibilidade para usuários. A OpenAI informou que um erro de roteamento começou por volta de 7h43 (PT) em 3 de setembro e deixou ChatGPT e Codex indisponíveis para parte dos usuários, com correção implementada por volta de 8h17 (PT).
A Anthropic alertou sobre uma “parcial outage” a partir de 6h23 (PT), com erros elevados nas solicitações a Claude Mythos 5.1, Claude Fable 5.1 e Claude Opus 5, e disse ter identificado a causa e aplicado um ajuste, com resolução marcada por volta de 9h16 (PT). Já a xAI atribuiu os problemas do Grok a uma “outage” no centro de computação em Memphis, e a interrupção foi encerrada por volta de 10h05 (PT).
A computação federada propõe um novo caminho para usar inteligência artificial na saúde: em vez de reunir dados de hospitais, laboratórios, universidades e sistemas públicos em uma base central, a ideia é executar análises e modelos nos ambientes onde as informações já estão armazenadas. A proposta busca permitir colaboração entre instituições sem que cada uma perca o controle sobre prontuários, bancos de dados e regras de acesso.
A plataforma ConvergeCore, do ConvergeLab, organiza esse processamento distribuído com modalidades como análise federada — em que consultas autorizadas retornam resultados agregados — e aprendizado federado, no qual modelos são treinados ou validados com dados mantidos na origem. O modelo pode ajudar a ampliar a diversidade de evidências para pesquisa e desenvolvimento de IA, inclusive no contexto do SUS, mas exige padronização de dados e acordos de governança, segurança e auditoria para que os resultados sejam comparáveis.
James Hall apresentou uma abordagem para rodar cargas de trabalho de IA diretamente no navegador, com inferência local, destacando por que “rodar perto” pode ser relevante para privacidade e controle de dados. Ele também contextualizou sua experiência com JavaScript no passado, incluindo projetos que levaram código e computação para o ambiente do browser, além de trabalhos anteriores com LLMs em aplicações web.
A apresentação contrasta o modelo “cloud-first” com a execução local, apontando preocupações com o envio de dados de usuários para provedores e com a forma como logs podem ser acessados por terceiros. Hall ainda citou aprendizados de projetos com LLMs e avaliação/observabilidade, e prometeu mostrar demos, armadilhas e lições para quem pretende aplicar IA no edge e no front-end.