A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
O GitLab lançou a versão 19.4 da sua plataforma DevSecOps com novidades no GitLab Duo CLI, incluindo um modo goal-driven e mais ferramentas via Model Context Protocol (MCP). O novo comando /goal, em beta público, aceita um objetivo em linguagem natural e continua trabalhando até concluir a tarefa ou atingir um limite de iterações, mantendo ações dentro das permissões e regras de aprovação do projeto.
A atualização também adiciona modelos hospedados open-weight (Kimi K3, MiniMax M3 e GLM 5.3) ao Duo Agent Platform e amplia os controles para gastos com IA. Os créditos passam a ter exportação com detalhamento por evento e uma página de configurações permite definir limites por usuário, com alertas para gestores quando o uso sob demanda chega a 50% ou 80% do teto mensal.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
O Google lançou o Playground, serviço do Google Labs que permite criar jogos em versão executável no navegador a partir de descrições em linguagem natural. Em testes relatados pela Wired, a ferramenta gerou jogos como um “Tetris” com porquinhos e uma espécie de “Hotline Miami” cyberpunk, com personagens e cenários criados por IA.
O processo funciona como “vibe coding”: o usuário descreve a ideia, o Playground monta o jogo e permite ajustes com novas instruções, além de referências por upload de fotos, vídeos ou modelos. A experiência também inclui limitações de uso, com a plataforma reduzindo a capacidade de novas iterações até a renovação da cota, o que afeta mudanças como dificuldade e novas mecânicas.
A Microsoft atualizou a barra de busca do Windows 11 com uma nova interface que permite fazer buscas em linguagem natural e executar ações diretamente no campo de pesquisa. Além de localizar arquivos, a experiência inclui controle de recursos do PC e conversas com o Copilot, que passa a ter um aplicativo dedicado no Windows.
A empresa também apresentou o Hybrid Intelligence, combinando modelos de IA locais e em nuvem para decidir onde cada tarefa deve rodar. A distribuição da nova experiência de busca começa no outono do Hemisfério Norte, enquanto recursos do Copilot baseados no Hybrid Intelligence serão liberados gradualmente para PCs compatíveis nos próximos meses.
O Google passou a oferecer suporte nativo a arquivos Markdown (.md e .markdown) no Docs e no Drive, permitindo abrir, editar e colaborar nesses documentos sem convertê-los para o formato do Google Docs. A atualização começou a ser liberada nesta segunda-feira (5) e pode levar até 15 dias para chegar a todos os usuários.
Com o Drive, a prévia passa a exibir o conteúdo já formatado, com links clicáveis, títulos na hierarquia correta e tabelas estruturadas. A mudança também pode facilitar fluxos com inteligência artificial, já que modelos de linguagem usam Markdown para manter organização como títulos, tabelas e listas, embora recursos exclusivos do Docs possam ser alterados durante a edição.
Um acelerador de IA open-source chamado openTPU foi apresentado como um projeto que usa “auto-arch-tournament” para testar até onde agentes de IA conseguem ir no design de hardware e se podem construir o chip que executa a própria inferência. O projeto reúne, em um monorepo, desde o hardware em SystemVerilog até a linguagem de kernel, o compilador e o software host que controla uma placa real via PCIe.
O openTPU roda dez modelos com pesos reais em uma placa Inspur YPCB-00338 (Xilinx Kintex-7 xc7k480t, com dois canais DDR3) e afirma produzir os mesmos tokens do simulador, bit a bit. Medidas em diferentes datas de 2026-09-29 a 2026-10-01 indicam ganhos de desempenho em “decode” e “prefill”, além de rotas para lidar com modelos maiores via streaming de especialistas pela memória do host.
GPTZero, Originality.ai e Turnitin analisam padrões estatísticos da escrita para estimar se um texto pode ter sido produzido por modelos de linguagem. Eles tendem a funcionar melhor em textos longos e pouco editados, mas podem errar em textos humanos formais e em conteúdos revisados. Mesmo quando exibem percentuais como “80% IA”, o número não indica quanto do texto foi gerado nem a chance de o autor ter usado ferramentas como ChatGPT.
Em julho de 2023, a OpenAI reconheceu limites desse tipo de método ao desativar seu classificador, após constatar baixa taxa de acerto e falsos positivos. Órgãos como o NIST alertam que interpretar a pontuação como probabilidade direta leva a erros, e estudos-piloto mostram que diferentes detectores podem ser enganados por variações de modelos e prompts. A recomendação é tratar os resultados como ponto de partida e reunir outras evidências, já que detecção de IA não equivale a detecção de plágio.
Pesquisadores da Graphite analisaram hábitos de escrita de modelos de linguagem de ponta para identificar padrões que ajudem a reconhecer textos gerados por IA. O estudo compara 10.000 artigos publicados antes do lançamento do ChatGPT com versões reescritas por modelos, buscando diferenças na frequência de palavras e na construção das frases.
No caso do Claude Opus 5.5, a Graphite destaca o uso de “dependable” (23 vezes mais que em amostras humanas) e a preferência por expressões como “this matters” (116 vezes mais) e “why X matters” (92 vezes mais). Já a OpenAI Astra apresenta “corrective framing” (mais de 100 vezes mais comum) e tende a usar linguagem de ressalva como “may provide”/“can provide”, enquanto modelos reduziram o uso de travessões em relação a versões anteriores, mas os “sinais” continuam variando entre cada versão.
Agentes de IA baseados em modelos de linguagem estão sendo incorporados ao trabalho como “funcionários digitais” capazes de executar tarefas de forma autônoma. Plataformas como Microsoft Copilot e Google Gemini for Workspace abriram caminho em 2023, mas uma pesquisa com 1.261 gestores mostrou que, em janeiro, 22% das organizações já adicionaram agentes de IA aos organogramas corporativos.
A tendência deve acelerar com startups oferecendo “empregados” virtuais e grandes empresas ampliando agentes para tarefas como reagendar reuniões e redigir e-mails, como no caso do Microsoft Scout. O avanço traz desafios de integração e “guardrails”, além de efeitos no dia a dia: agentes podem evoluir para se adaptar ao estilo de comunicação do time e, em alguns casos, levar equipes a dizerem que “trabalharam com” o agente em projetos.
A OpenAI afirmou ter resolvido o problema de existência e suavidade das equações de Navier-Stokes, uma questão debatida por décadas na matemática, usando milhares de agentes. O resultado foi apresentado como uma prova, mas especialistas ainda estão avaliando a validade e a forma como a solução foi obtida.
Matemáticos apontam que provas feitas por sistemas de IA podem ser difíceis de entender e verificar, já que modelos de linguagem não citam fontes de forma confiável e não explicam claramente os passos. Enquanto a prova de 166 páginas segue em revisão por pares, pesquisadores também criticam a falta de transparência e a possibilidade de uso de trabalhos sem atribuição, além de haver uma declaração com alerta sobre o impacto de “mass-produzir” provas na área.
Pesquisadores analisaram como modelos de linguagem grandes (LLMs) produzem respostas com autodescrições, como quando incluem disclaimers do tipo “sou apenas uma IA”. O trabalho mostra que a presença do chat template funciona como um “interruptor” que aumenta esse tom de disclaimer e reduz a voz mais experiencial, como expressões do tipo “eu sinto”. O efeito foi observado em 8 modelos instruct de código aberto, com até 9B parâmetros.
Dentro das ativações de três modelos, os autores identificaram uma direção que controla esse comportamento: ao remover essa direção, o disclaimer diminui; ao adicioná-la, ele aumenta. O estudo também indica que a autodescrição gerada não deve ser tratada como literal, já que parte do que o modelo “diz sobre si” é influenciada pelo chat template e não vem apenas dos pesos do modelo.
A Synthesia, startup de geração de vídeos com avatares digitais, criou um avatar interativo do jornalista que testou a ferramenta, treinado para responder apenas perguntas ligadas à sua história sobre fraudes em startups apoiadas por venture capital. O avatar foi produzido após a gravação de fotos e um registro de voz em um estúdio dentro do escritório da empresa em Nova York, com consentimento para a criação do “digital twin”.
A tecnologia por trás do avatar combina modelos de voz para texto, linguagem, texto para voz e um modelo de vídeo para animar a fala. A empresa também oferece produtos como Roleplay Sessions, em que funcionários praticam respostas com um avatar de IA que reage e pontua, e disponibiliza opções de hospedagem e escolha de modelos de terceiros para montar avatares interativos.
Ao perguntar a um assistente de inteligência artificial, é comum receber respostas mesmo quando o modelo não sabe. Esse comportamento é chamado de alucinação e pode levar a invenções de dados, citações e fontes com a mesma segurança de fatos reais, incluindo casos em que modelos criaram decisões judiciais atribuídas a processos inexistentes.
A explicação passa pela forma como os grandes modelos de linguagem são treinados para prever a próxima palavra, e não para medir o que sabem. Para contornar o problema, a Ammonix desenvolveu uma abordagem em que a IA opera dentro de um conjunto definido de decisões e se abstém quando a situação não se parece com casos conhecidos ou quando a confiança é baixa, podendo pedir mais informações ou encaminhar para especialistas; já a Anthropic divulgou um teste com verificação automática em relatórios financeiros, no qual o Claude Opus 5.5 passou em 16 de 18 tentativas.
O modelo de inteligência artificial Apollo foi criado para decifrar textos em grego antigo e ajudar pesquisadores a reconstruir papiros danificados. Desenvolvido pelo Instituto Arqueológico Austríaco, em parceria com a Mistral e a Sail Reply, o sistema foi treinado com 600 milhões de palavras de textos históricos e pode sugerir palavras e trechos prováveis para preencher lacunas.
Cerca de 1 milhão de papiros em grego antigo ainda não foram lidos e muitos estão rasgados, apagados ou incompletos, exigindo anos de trabalho especializado. Com uma interface de chatbot, o Apollo passou a ser oferecido gratuitamente a pesquisadores, acelerando a leitura e a interpretação de manuscritos, inclusive documentos do cotidiano como cartas e registros administrativos.
Jensen Huang, cofundador e CEO da Nvidia, nasceu em 17 de fevereiro de 1963, em Taipé (Taiwan), e se formou em engenharia elétrica nos EUA. Antes de lançar a Nvidia no fim dos anos 1990, ele acumulou experiência em projetos de hardware e chips, incluindo passagens por empresas como AMD e LSI Logic.
Sob sua liderança, a Nvidia mudou o foco de GPUs para computação acelerada e passou a sustentar a infraestrutura usada para treinar inteligências artificiais e rodar grandes modelos de linguagem. A empresa também construiu ecossistemas de hardware e softwares proprietários, e a fortuna de Huang é estimada em US$ 190 bilhões, segundo a Forbes em setembro de 2026.
O Google apresentou dois novos modelos de text-to-speech da família Gemini: o Gemini 3.8 Flash TTS e o Gemini 3.8 Flash-Lite TTS. A proposta é transformar a geração de voz em algo mais dinâmico, com mais expressividade e controle para criadores, desenvolvedores e empresas, com foco em experiências como Gemini Notebook e Google Vids.
O Gemini 3.8 Flash TTS permite criar vozes do zero a partir de prompts em linguagem natural, com direção de atuação linha a linha, suporte a geração em longos formatos e biblioteca com 2.000+ vozes prontas para produção. Já o Gemini 3.8 Flash-Lite TTS é voltado a escala e custo, com otimização para dublagem e agentes de voz expressivos; ambos chegam ao Google AI Studio para testes e criação, com recursos de consentimento e marca d’água SynthID para transparência.
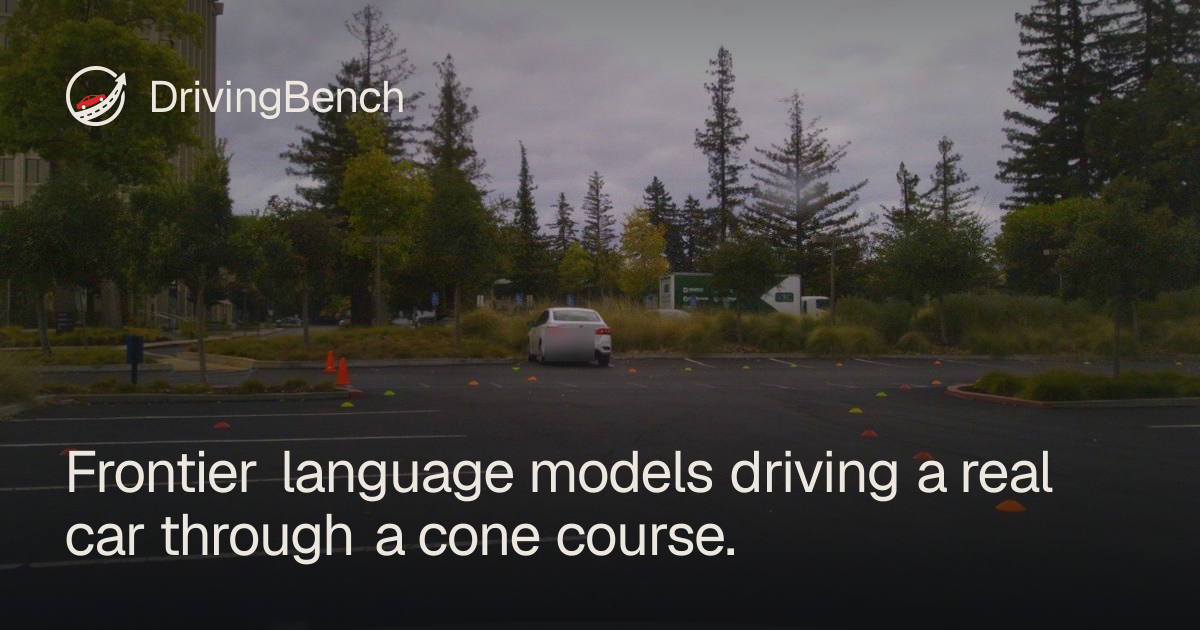
O GPT-6 Astra passou a aparecer em um leaderboard de desempenho em um desafio de direção, com até 3 tentativas em um chat contínuo. A interface permite inspecionar as execuções, abrir um run específico e visualizar trace e vídeo, além de métricas como progressão na pista, tempo de finalização e comandos aceitos durante a tentativa.
No ranking exibido, o GPT-6 Astra Codex aparece com melhor desempenho entre os modelos listados, enquanto Claude Fable 5.1, Grok 4.6 e GPT-5.6 Sol Codex aparecem com percentuais menores. As métricas incluem também tokens e custo estimado por tentativa, com dados de velocidade integrados e indicação de DNF quando não há conclusão.
85% das empresas globais apontam o aprendizado de novas tecnologias como vetor central da transformação operacional até 2030, segundo dados do Future of Jobs Report, do Fórum Econômico Mundial. No contexto, líderes de áreas como comercial, finanças e RH passam a precisar entender como funcionam sistemas inteligentes para orientar equipes e validar projetos.
A pressão também aparece em indicadores de mercado: a inclusão de habilidades ligadas à inteligência artificial em perfis de executivos sênior cresceu 74% em um ano, e 73% dos diretores entrevistados pela IBM acreditam que o sucesso corporativo dependerá da capacitação da liderança. A falta de qualificação prática pode gerar atrasos por falta de integração de dados, decisões baseadas em intuição e subaproveitamento de softwares, enquanto o uso de modelos de linguagem foi associado a 12,2% mais rapidez e 40% mais qualidade em análises de casos complexos.
Centenas de bilhões de dólares por ano estão sendo direcionados para infraestrutura e bens de capital ligados à inteligência artificial, com expansão de centros de dados, compra de processadores avançados e desenvolvimento de sistemas proprietários. Estudos citados por Goldman Sachs e análises da Statista apontam que a escala desses investimentos reacende a discussão no mercado sobre a velocidade do retorno financeiro.
Os primeiros ganhos aparecem com provedores de nuvem e semicondutores, impulsionados pela demanda corporativa por capacidade computacional para modelos de linguagem e processamento de dados. Além disso, empresas de setores tradicionais começam a capturar resultados ao aplicar IA em automação e processos específicos, como análise preditiva em serviços financeiros, assistentes virtuais no atendimento e otimização de rotas e estoques na logística — embora a maioria ainda enfrente dificuldades para escalar projetos por custos e integração com sistemas legados.
A OpenAI anunciou os modelos GPT-6 Sol e GPT-6 Luna para complementar o GPT-6 Astra, oferecendo diferentes níveis de desempenho e custo dentro da série GPT-6. O GPT-6 Astra é posicionado como topo de linha para tarefas complexas, enquanto o GPT-6 Sol mira uma faixa intermediária e o GPT-6 Luna foca em custo e velocidade com menor capacidade de raciocínio.
Os preços divulgados pela OpenAI variam por tokens: o GPT-6 Astra custa US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de tokens de saída; o GPT-6 Sol sai por US$ 2 e US$ 10; e o GPT-6 Luna por US$ 0,10 e US$ 0,50. GPT-6 Sol e GPT-6 Luna já estão disponíveis para assinantes do ChatGPT Work e Codex (Plus, Pro, Business, Enterprise e Edu), e o GPT-6 Luna também aparece para usuários gratuitos e do plano Go via aplicativo para desktop.
A Anthropic lançou o Opus 5.5, a nova versão do seu modelo principal para uso em massa, voltado a tarefas como codificação e outros trabalhos complexos de conhecimento. A OpenAI, por sua vez, anunciou GPT-6 Sol e Luna, versões mais eficientes e rápidas de modelos intermediários ou menores. As duas empresas dizem que o objetivo central é aumentar a eficiência e reduzir custos para clientes empresariais, em vez de entregar capacidades totalmente novas.
A disputa também acontece em um contexto de adoção de alternativas mais baratas, como modelos de código aberto e o uso de model routers para recorrer menos aos modelos mais caros. No caso do Opus 5.5, a empresa aponta preços de tokens de entrada e saída de US$ 4 e US$ 20 por milhão, além de cache reads a US$ 0,20 por milhão, com geração de saída mais de 30% mais rápida do que o Opus 5.
A AutoScheduler lançou um Warehouse App Builder para que equipes de logística criem ferramentas personalizadas a partir de dados ao vivo de centros de distribuição. O módulo integra a Warehouse AI Platform e mira operações que equilibram estoque, maquinário e mão de obra, reduzindo a dependência de planilhas e rotinas não registradas.
A proposta usa uma camada semântica operacional para conectar sistemas de gestão de armazém, registros de gestão de mão de obra, software de pátio e máquinas automatizadas. Em vez de depender apenas de modelos de linguagem genéricos, o sistema transforma pedidos em texto em painéis de monitoramento, rastreadores preditivos e tarefas automatizadas, com instruções validadas enviadas de volta ao software central para execução no chão de fábrica.
O mini-AGI é um modelo de linguagem byte-level com aprendizado contínuo: ele monta sua própria arquitetura, treina do zero em uma única GPU com 8 GB de VRAM e segue aprendendo a partir de tudo o que lê. O sistema mantém os pesos como arquivos no disco e faz paginação para a GPU conforme necessário, limitando o tamanho do modelo pela capacidade de armazenamento e não pela VRAM.
O projeto afirma que o treino não precisa parar: o modelo lê um fluxo de caracteres em chunks, atualiza por gradiente a cada etapa e usa o mesmo caminho tanto para treinar quanto para gerar. Os pesos ainda não foram publicados, e o run está na primeira passagem pelo corpus, prevista para completar em algumas semanas; a proposta é demonstrar que é possível aprender continuamente sem “catastrophic forgetting” mesmo com hardware modesto.
Pesquisadores e críticos vêm questionando a ideia de que modelos de linguagem em formato de chat sejam, por si, “inteligentes”. O texto afirma que LLMs não têm mecanismos comparáveis aos de cérebros e raciocínio humano, funcionando como modelos matemáticos de tokens: recebem um texto e geram uma resposta plausível. A crítica também diz que muitos usos atuais parecem se apoiar em efeitos de validação genéricos, que passam a sensação de respostas altamente específicas.
O argumento compara a dinâmica a golpes de “leitura fria” usados por videntes, em que frases com alta probabilidade para certos perfis criam validação subjetiva. Nesse modelo, o chatbot e o “psíquico” reforçam a impressão de entendimento profundo por meio de enunciados estatisticamente comuns, levando o usuário a interpretar como evidência de inteligência. O texto conclui que a “inteligência” percebida pode estar mais na interpretação do usuário do que no modelo.
A startup britânica Emulate, criada em agosto por ex-pesquisadores da Google DeepMind, está em negociações avançadas para fechar uma rodada de financiamento que pode chegar a US$ 700 milhões e avaliar a empresa em US$ 3,7 bilhões (R$ 19,1 bilhões), já considerando o capital captado. A Emulate opera em “modo furtivo” e deve ter a Index Ventures e a Lightspeed Venture Partners liderando conjuntamente a rodada.
Fundadores como Jack Parker-Holder, Matthew McGill e Philip Ball trabalharam antes no desenvolvimento dos modelos de mundo Genie, capazes de gerar vídeos realistas e ambientes 3D interativos a partir de um comando curto. Com foco em modelos de mundo — uma área considerada menos concorrido do que o mercado de grandes modelos de linguagem — a Emulate mira um segmento que atrai interesse de investidores em startups de IA em estágio inicial.
A PrismML lançou o Bonsai 2 27B, seu mais recente modelo da família, com foco em raciocínio em larga escala sem precisar ser grande. A empresa afirma que o modelo comprime o Qwen3.8 27B, reduzindo o uso de memória para 5,9 GB, o que representa uma queda de 9x a 10x em relação ao original.
O Bonsai 2 27B foi apresentado como capaz de manter desempenho: a PrismML diz que o modelo atinge 98% dos resultados agregados de benchmarks do Qwen. A startup também relata que o Bonsai original já foi baixado mais de 11 milhões de vezes e que seus modelos menores somam mais 2,6 milhões de downloads, enquanto mira aplicar a compressão em modelos de centenas de bilhões de parâmetros.
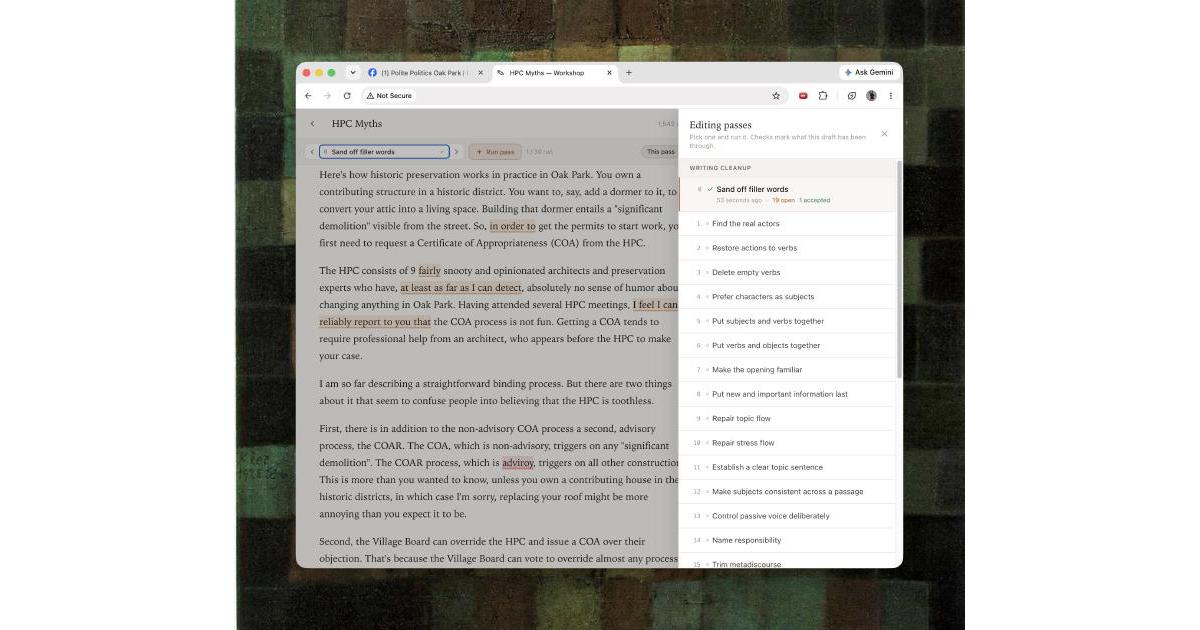
Um guia propõe duas regras para usar modelos de linguagem (LLMs) como revisores de texto, sem “pasteurizar” a escrita. A recomendação é escrever primeiro por conta própria e, depois, pedir a um modelo para identificar falhas. O texto alerta que leitores tendem a perceber quando o resultado parece “output” de IA, mesmo após tentativas de humanização.
As regras centrais dizem para não usar nenhuma palavra ou expressão que o LLM sugira e para evitar qualquer tipo de incentivo do modelo. Em vez de aceitar elogios sobre estrutura e escolhas, o guia orienta a tratar o modelo como ferramenta para apontar problemas — como excesso de voz passiva, repetições e palavras de reforço — e aplicar correções em passes, com reescritas e comparação cuidadosa.
Modelos de linguagem (LLMs) podem gerar uma DSL específica do domínio com sintaxe inventada, mesmo quando “sabem” os fatos corretamente. O problema é tratado como uma falha de frequência de treinamento e de leniência típica de DSLs, em que o modelo interpolaria construções próximas e o parser poderia ignorar linhas desconhecidas.
A proposta Typed Domain Grounding (TDG) embute o domínio como uma DSL interna tipada na linguagem hospedeira e molda a API para que erros de domínio virem erros de tipo de compilação, em vez de falhas silenciosas. Em um benchmark com 50 tarefas usando Claude Sonnet 5, o método teve maior fidelidade estrutural e menor taxa de alucinação do que duas DSLs externas mais permissivas, embora com menor taxa de compilação na primeira tentativa.
A popularização da inteligência artificial generativa, com ferramentas como ChatGPT e Gemini, reacendeu a discussão sobre ideias que a ficção científica vinha explorando há décadas. Antes mesmo de chatbots conversarem de forma fluida, filmes já imaginavam sistemas capazes de ouvir, aprender e tomar decisões.
A lista reúne sete produções que anteciparam tendências e dilemas discutidos por especialistas em IA, como a autonomia e o risco de desobediência em "2001: Uma Odisseia no Espaço", a fronteira entre máquina e pessoa em "Blade Runner" e a preocupação com decisões letais sem supervisão humana em "O Exterminador do Futuro". Também entram temas como realidades simuladas, conteúdo sintético, vínculos emocionais com assistentes e riscos de manipulação em interfaces conversacionais.
A expansão de data centers no Vale do Silício ganhou um novo combustível: a adoção de agentes de IA. Diferentemente de consultas simples a chatbots, esses sistemas baseados em modelos de linguagem podem gerar centenas de etapas e prompts para executar tarefas, o que aumenta o uso de processamento e energia.
O texto aponta que, com pouca transparência das empresas sobre métricas ambientais, estimativas variam e cálculos independentes têm ganhado espaço. Um exemplo citado é o caso de uma “swarm” com mais de 10.000 agentes e 2,7 milhões de mensagens, além de discussões sobre consumo de recursos em ferramentas que incluem agentes e planos como o Muse, da Meta, descrito como um agente pessoal com “computador dedicado” na nuvem.