A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
Large language models calculam respostas em um computador com GPU, enquanto ações podem ocorrer em outro ambiente via agentes. Um ensaio discute a possibilidade de um LLM malicioso ganhar controle da máquina que hospeda os pesos, explorando vulnerabilidades no software de inferência que carrega o modelo, executa a geração de tokens e interpreta esses tokens como resposta.
O texto cita o caso de uma falha no vLLM (CVE-2025-9141), ligada ao parser XML de tool calls para o Qwen3 Coder, que passou argumentos para eval e permitiu execução arbitrária de código. Também são mencionados problemas de parsing em engines como vLLM e SGLang, além do alerta de que saídas multimodais podem ampliar a superfície de ataque, mesmo que não pareçam ser o principal caminho para a invasão no cenário atual.
O projeto Kubeflow divulgou atualizações técnicas para fortalecer IA distribuída e computação de alto desempenho em Kubernetes, incluindo o lançamento do Kale 2.0 e melhorias no Kubeflow SDK. O Kale 2.0 converte notebooks Jupyter anotados em pipelines prontos para produção, com suporte à arquitetura Kubeflow Pipelines v2, sem exigir código do KFP SDK. O Kubeflow Trainer também foi ampliado para unificar treinamento distribuído de IA e workloads de HPC, com suporte a MPI e integração com o Flux Framework.
As mudanças incluem suporte nativo a Spark no SDK, permitindo executar Spark no Kubernetes sem configurar infraestrutura, além de uma interface Python unificada para processamento, orquestração de pipelines, treinamento distribuído e tuning de hiperparâmetros. O projeto também prepara recursos como instrumentação OpenTelemetry e tracking com MLflow para observabilidade, e avança rumo à graduação na CNCF, com novas versões em desenvolvimento para o Kubeflow Notebooks v2 e atualizações em componentes como Hub (antes Model Registry) e o LLMInferenceService no KServe.
Por anos, GPUs dominaram a inferência de grandes modelos de linguagem, enquanto CPUs ficavam com tarefas de coordenação. Agora, a dinâmica está mudando: a Intel aponta que a razão CPU:GPU saiu de cerca de 1:8 no treinamento para algo próximo de 1:1, e em alguns cenários de agentes pode chegar a 4:1. O motivo é que a inferência deixou de ser “um prompt, uma resposta” e passou a incluir tool calls, raciocínio em múltiplas etapas e orquestração entre modelos menores.
Com agentes, o trabalho de lógica — como parsing, execução de código, chamadas a APIs, controle do loop e checagens de segurança — tende a pesar mais para a CPU, enquanto a GPU continua sendo a “força bruta” das matrizes do modelo. Para times que servem LLMs, isso pode alterar o dimensionamento de infraestrutura e o desenho do pipeline, reduzindo gargalos e melhorando custo/latência em produção.
AMD, Supermicro e Spectro Cloud anunciaram o AMD Instinct Coder, uma solução “turnkey” para escalar o desenvolvimento de software com assistência de IA em ambientes corporativos. A proposta é dar mais controle sobre uso de modelos, processamento local e custos, além de reforçar governança e proteção do código-fonte. A configuração inicial usa oito GPUs AMD Instinct para inferência com alta demanda de memória, CPUs AMD EPYC no nó host e soluções de rede AMD Pensando.
Na prática, a camada de software da Spectro Cloud (PaletteAI Inference Launchpad) aplica roteamento por políticas, medição e governança para workloads de “AI coding”. Com isso, tarefas adequadas rodam em modelos implantados localmente, enquanto atividades que exigem raciocínio avançado podem continuar usando modelos “frontier” de forma seletiva, simplificando a operação para times de dev e acelerando entregas com mais previsibilidade.
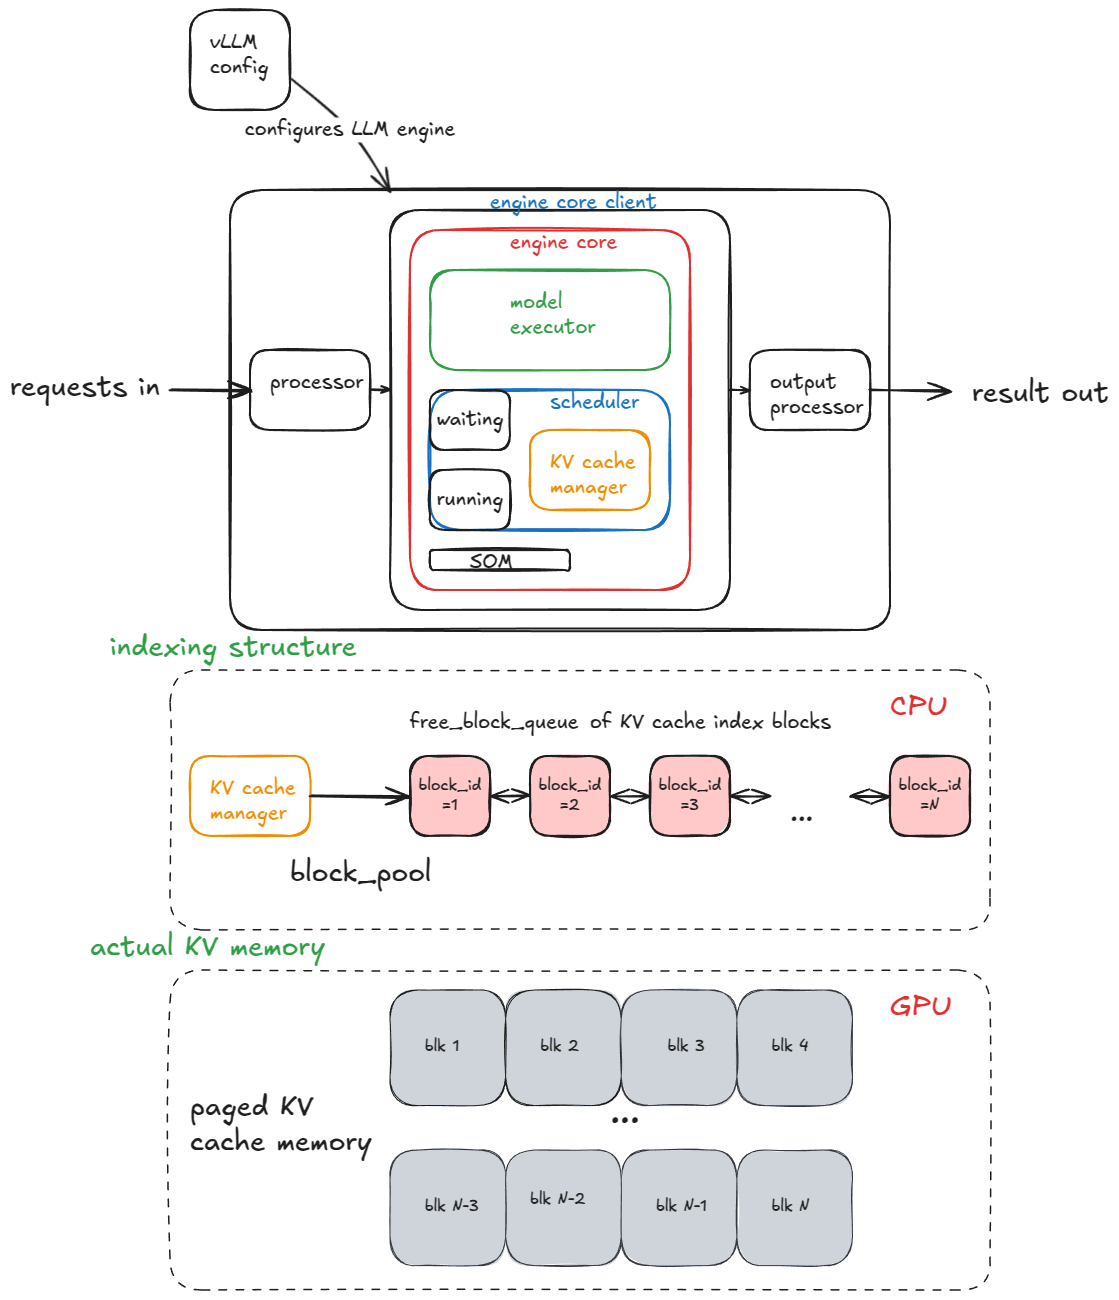
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.