A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A Google lançou o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros para recuperação de texto, código, imagens, vídeo e áudio, com testes em um Pixel 11 Pro usando cerca de 567MB de RAM ativa com quantização. O modelo mapeia os cinco tipos de entrada para um mesmo espaço vetorial de 768 dimensões, permitindo buscar imagens e áudio sem legendas ou transcrições prévias.
Os pesos foram liberados sob Apache 2.0 e a execução no dispositivo está disponível via LiteRT e MediaPipe Tasks, com integração ao Android ML Kit prevista para as próximas semanas. A Google também mostrou que desenvolvedores podem reduzir o tamanho do índice com Matryoshka Representation Learning (512, 256 ou 128 dimensões) e citou desempenho em busca de código, além de demos de RAG local e recuperação para fluxos com agentes usando índices no próprio aparelho.
A recuperação de dados segue como um dos desafios centrais em sistemas de IA, e a chegada de agentes eleva a exigência sobre a infraestrutura de busca. Agentes fazem consultas em alta velocidade, dividem perguntas complexas em buscas paralelas e precisam de um mecanismo de retrieval que acompanhe o ritmo sem custos proibitivos.
A Chroma, conhecida pelo ChromaDB e pelo paper Context Rot, lançou o Context One, um subagente de retrieval com 20 bilhões de parâmetros. O modelo foi treinado para realizar busca agentic com qualidade de nível “frontier”, mas com custo e velocidade melhores, e a empresa discute em entrevista a origem do ChromaDB e a evolução do entendimento sobre “context rot”.
Uma pesquisa apresenta um método para traduzir embeddings de texto entre espaços vetoriais diferentes sem dados pareados, sem encoders e sem conjuntos pré-definidos de correspondências. O trabalho propõe uma abordagem não supervisionada que mapeia embeddings para uma representação latente universal, descrita como uma estrutura semântica conjecturada pela Platonic Representation Hypothesis, preservando a geometria dos vetores. Os autores relatam alta similaridade cosseno entre modelos com arquiteturas, tamanhos de parâmetros e conjuntos de treino distintos.
A capacidade de converter embeddings desconhecidos para outro espaço mantendo sua estrutura é apontada como relevante para a segurança de bases vetoriais. O texto destaca que um adversário que tenha acesso apenas aos vetores pode extrair informações sensíveis dos documentos, o suficiente para classificação e inferência de atributos.
O emulador de PlayStation 3 RPCS3 criticou o DLSS 5 da NVIDIA depois que modders testaram uma versão vazada da DLL da tecnologia no renderizador do software. Em publicação no X, a equipe afirmou que viu “slop” gerado pelo recurso e disse que não vai lançar “lixo”.
O RPCS3 também argumentou que o objetivo do emulador não é focar em hardware high-end para atingir jogabilidade e que jogos da era do PS3 não fornecem motion vectors exigidos por temporal upscalers modernos, o que inviabiliza o uso do DLSS 5. A equipe ainda defendeu o uso de spatial upscaling, como FSR 1 e filtragem bilinear, dizendo que o FSR 1 não depende de motion vectors.
A TOTVS apresentou como arquitetar a camada de dados para agentes de IA em ambientes corporativos, destacando o desafio de ter “muito dado” que não está preparado para ser acessado por loops de raciocínio que fazem consultas imprevisíveis. A empresa explicou que, em sistemas transacionais como ERP e CRM, os dados foram otimizados para aplicações determinísticas e com alta precisão, enquanto agentes usam raciocínio probabilístico e exigem preparação adicional.
A apresentação também abordou como decidir onde buscar dados e como preparar plataformas para a era “agentic”, combinando fontes transacionais e de dados. Segundo a TOTVS, é comum usar a plataforma de dados para processamento histórico e busca semântica (com apoio de vector database e protocolos como MCP), enquanto o acesso direto ao sistema transacional é indicado quando é necessário escrever dados, obter informações mais recentes ou executar regras de negócio codificadas no próprio sistema.
IA em tempo real em escala é mais difícil do que parece: pipelines que funcionam bem no desenvolvimento podem falhar em produção, com problemas como aumento de latência e queda de acurácia. Em um app de trading baseado em ML, a latência P99 disparou para 3 segundos quando o sistema chegou a cerca de 740 mil operações por segundo, apesar de a média parecer aceitável. O diagnóstico apontou que a lentidão não estava no modelo, mas em buscas e contenção sob carga, com o Postgres sendo pressionado no cenário específico.
A precisão também pode piorar quando os dados ficam desatualizados: perfis de usuários (wallet addresses) ultrapassaram uma SLA de 5 minutos por horas, embeddings ficaram obsoletos e métricas offline continuaram boas até a integração com dados online. Além disso, índices vetoriais precisam de manutenção, já que reembeddings degradam a qualidade do índice ao longo do tempo, reduzindo recall para 42% e elevando a latência de consulta. O texto ainda destaca que treinamento e serving devem ser separados quando possível e que retraining é inevitável, exigindo transição para evitar janelas de previsões defasadas.
A AWS introduziu a busca vetorial nativa no Amazon DynamoDB, permitindo armazenar embeddings junto aos dados da aplicação e executar consultas de nearest-neighbor aproximadas diretamente no banco, sem depender de um banco vetorial separado. O recurso inclui buscas de similaridade com filtros e índices vetoriais configuráveis para cargas de semantic search.
Com o novo tipo de índice do DynamoDB, desenvolvedores criam um vector index com as dimensões e a função de distância necessárias e consultam via a API SearchVectors. A AWS cita suporte a até 4096 dimensões, funções Euclidean, Cosine e Dot product, além de inline filtering, e mostra um exemplo em Python usando embeddings do Amazon Bedrock para localizar papers por significado. O custo do índice é cobrado por dimensões e também por bytes gravados, processados e armazenados.
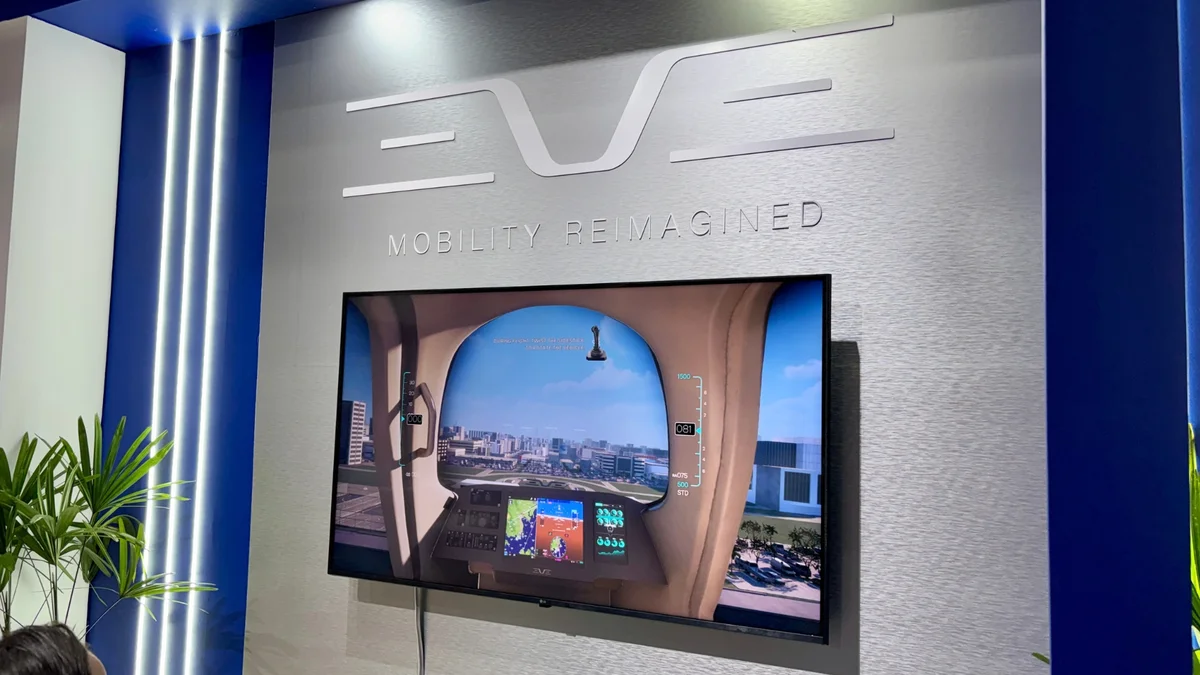
A Eve, do grupo Embraer, está desenvolvendo um software para coordenar o tráfego de eVTOLs (carros voadores) em baixa altitude. Durante o Rio Innovation Week 2026, o VP de Serviços ao Cliente da empresa, Luiz Mauad, disse que a frota poderá compartilhar infraestrutura aérea já usada por helicópteros, desde que os pontos sejam eletrificados. Com o aumento da densidade de aeronaves, a companhia prevê a necessidade de uma coordenação mais eficiente e trabalha em uma plataforma chamada Vector, baseada em experiência do grupo com sistemas de controle do espaço aéreo.
A ferramenta deve ser entregue a empresas ou órgãos responsáveis por controle e segurança das operações, embora ainda não haja data para lançamento. Para o setor tech, o avanço reforça a tendência de usar software inteligente e sistemas de gestão para lidar com novos fluxos de mobilidade aérea, exigindo integração com infraestrutura e regras operacionais em escala urbana.