A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
O guia de prompting do Claude Opus 5.5 detalha padrões específicos para extrair melhor desempenho do modelo. A documentação afirma que o Claude Opus 5.5 gera tokens de saída mais de 30% mais rápido que o Claude Opus 5 e costuma concluir a mesma tarefa com menos tokens, sem exigir mudanças nos prompts existentes do Opus 5.
A orientação também destaca como calibrar o “effort”, principal controle para o quanto o modelo pensa, equilibrando inteligência, latência e custo. O texto recomenda começar no nível médio (padrão do Opus 5.5), testar níveis com as próprias avaliações e ajustar limites como max_tokens para evitar cortes em turnos longos e agentic.
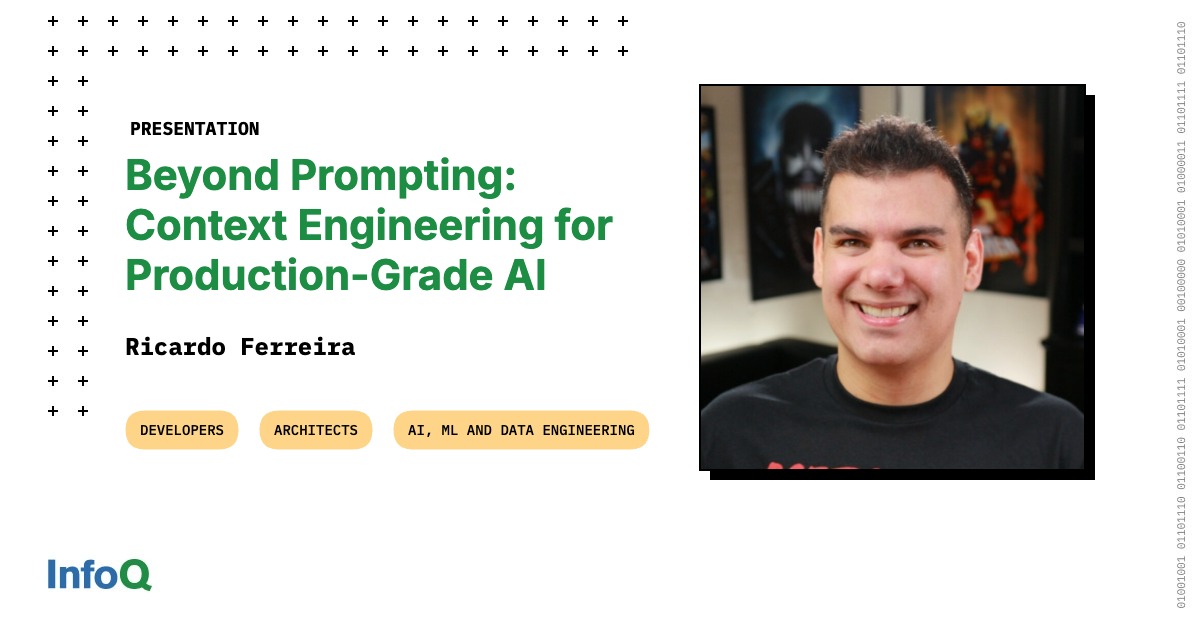
Redis está usando engenharia de contexto para viabilizar aplicações com LLM em cenários com restrições reais de tempo. Em uma apresentação, Ricardo Ferreira contou como desenvolveu o Agent Memory Server (AMS), um projeto open source para criar camadas de memória de curto e longo prazo sobre Redis, com foco em permitir conversas mais naturais.
Para testar o AMS, ele criou a skill “My Jarvis” para Alexa, com respostas limitadas por um timeout fixo de 8 segundos. A arquitetura inclui uma função Lambda no backend, o SDK da Alexa e o LangChain4j (Java), que orquestra o acesso a um LLM via OpenAI, enquanto o desenvolvimento enfrenta problemas como context poisoning, distração por excesso de dados, confusão e “context rots”.
A OpenAI anunciou que atualizou o GPT-5.6 Sol dentro do ChatGPT voltado ao uso cotidiano, mantendo inalteradas as versões usadas no Codex e no ChatGPT Work. Segundo a empresa, essa variante foi otimizada para conversas “do dia a dia” e, por isso, fica disponível apenas na experiência de chat. A mudança também inclui um controle deslizante para Plus e Pro escolherem quanto “pensamento” o modelo aplica antes de responder, funcionando no web, mobile e desktop.
Nos bastidores, a OpenAI afirma que o GPT-5.6 Sol atualizado reduz erros factuais: em testes internos, respostas com ao menos um erro foram 68% menos frequentes do que no GPT-5.5 Instant, e a Luna (futura padrão para Free e Go) teria reduzido erros em cerca de 62%. Para devs e times que testam prompts antes de levar para ambientes como Codex/Work, a recomendação é validar na prática onde o modelo vai rodar, já que a API não teve mudanças anunciadas e os comparativos não trazem detalhes reproduzíveis.
Um post no Hacker News argumenta que, apesar de LLMs deixarem qualquer pessoa “bom o suficiente” em tarefas como escrever CSS ou redigir textos, a diferença real está na expertise do domínio. O autor cita a conversa de Terence Tao com o ChatGPT sobre um contraexemplo ligado à Jacobian Conjecture, destacando que Tao conseguiu avançar mais do que ele, mesmo com limites de tokens. A análise aponta que o segredo não é só pedir mais, mas formular perguntas curtas, sinalizar o contexto correto e reconhecer quando a resposta “parece estranha”.
Na prática, a mensagem é direta para devs: conhecimento do seu problema (código, arquitetura, regras do domínio) permite extrair muito mais valor do mesmo modelo, guiando o LLM para soluções melhores e mais simples. Sem esse repertório, o sistema até ajuda a chegar a algum resultado, mas tende a ficar preso a respostas genéricas ou mal direcionadas.