A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
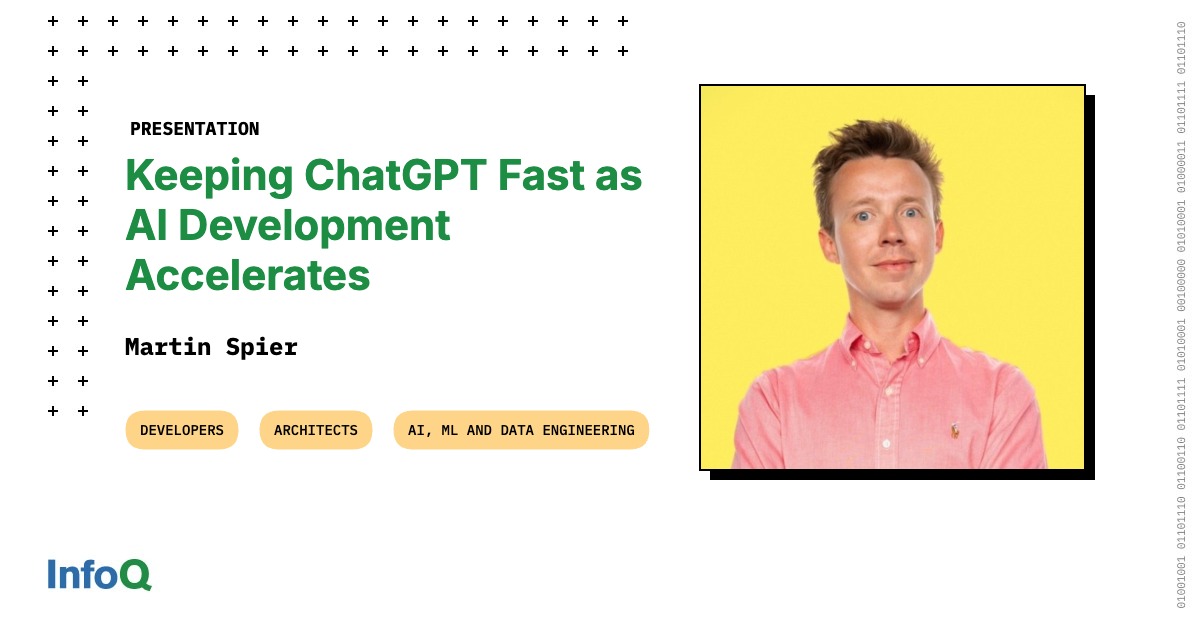
Martin Spier, líder do time de performance do ChatGPT na OpenAI, explicou no InfoQ como duas acelerações estão acontecendo ao mesmo tempo: crescimento explosivo de usuários e mudanças nas rotinas de desenvolvimento com “agentic coding”. Ele citou que empresas chegam a milhões de usuários mais rápido do que antes e que o volume de código/funcionalidades entregues aumenta com agentes, exigindo evolução das práticas de engenharia. Spier também trouxe números do ChatGPT: em fevereiro, a plataforma chegou a 900 milhões de usuários semanais ativos, e em um pico de geração de imagens, mais de 700 milhões de imagens foram criadas em apenas 7 dias por 130 milhões de usuários.
Com mais delegação de tarefas aos agentes, a equipe perde parte do controle detalhado sobre o que vai ser lançado — e isso pressiona a infraestrutura e a engenharia de performance. Na prática, o desafio passa a ser manter baixa latência, confiabilidade e eficiência mesmo com picos de demanda e mais “lógica” rodando no fluxo, adaptando práticas de performance engineering para acompanhar o ritmo de entrega.