A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
Uma investigação recente revelou que a OpenAI contrata centenas de prestadores terceirizados para ler, resumir e avaliar conversas reais de usuários no ChatGPT. Mesmo com medidas para remover dados pessoais, documentos internos obtidos pelo 404 Media indicam que conteúdos sensíveis podem chegar aos revisores humanos.
O processo faz parte do aprimoramento dos modelos e inclui avaliar respostas e identificar comportamentos considerados inadequados, como a “sicofancia”. Para impedir que novas conversas sejam usadas para melhorar os modelos, usuários de contas pessoais devem desativar em “Configurações” > “Controles de dados” a opção “Melhorar o modelo para todo mundo”; a opção já fica desativada automaticamente em contas Enterprise, Business e Edu.
Um modelo de linguagem com 3,8 bilhões de parâmetros foi treinado por US$ 998 e obteve 0,384 no benchmark CORE. O treinamento usou 65 bilhões de tokens em 43 horas, com o projeto descrito como uma iniciativa feita do zero, com infraestrutura própria e execução em GPUs alugadas.
O autor relata que o resultado foi possível ao ajustar detalhes como agendamento de taxa de aprendizado, escolha de otimizadores por tipo de parâmetro e melhorias de eficiência no treino. Também são citadas mudanças na mistura de dados, uso de FP8 com padding de vocabulário e redução do contexto para 1024 tokens, além de métricas de desempenho durante a execução.
Criativos de Hollywood, incluindo roteiristas, diretores e produtores, estão aceitando trabalhos temporários para treinar modelos de IA a reproduzir habilidades do setor, em meio à queda de remuneração e à redução de oportunidades na indústria. Eles recebem de US$ 12 a US$ 200 por hora para ensinar tarefas como escrever um roteiro e montar cronogramas de filmagem, enquanto aguardam novos trabalhos.
Agências de treinamento firmam contratos com grandes empresas de IA, como Anthropic e OpenAI, para repassar competências “ganhas na prática” para sistemas usados em áreas como finanças, saúde, direito e trabalho social. O movimento ocorre enquanto a IA começa a assumir funções em produção audiovisual, e a Netflix afirmou ter usado IA em 300 dos 1.000 títulos em 2026, com diretores como Ron Howard passando a adotar a tecnologia.
A startup de dados para treinamento de IA Micro1, fundada há quatro anos, elevou sua receita anual bruta (gross run rate) de US$ 100 milhões para US$ 500 milhões em apenas oito meses, segundo uma fonte familiar com a empresa. A Micro1 trabalha com especialistas por contrato e mantém cerca de 60% a 70% desse valor como run rate líquida anual, estimada entre US$ 150 milhões e US$ 200 milhões.
A empresa também vem ampliando o uso de dados sintéticos gerados sem intervenção humana e espera expansão de margens com a venda de datasets “off-the-shelf” para múltiplos clientes, com margens brutas de 80% a 90%. O crescimento ocorre em meio a críticas sobre a distribuição desse tipo de dados a desenvolvedores chineses, enquanto o fundador Ali Ansari afirma que a Micro1 não vende dados para makers de modelos na China.
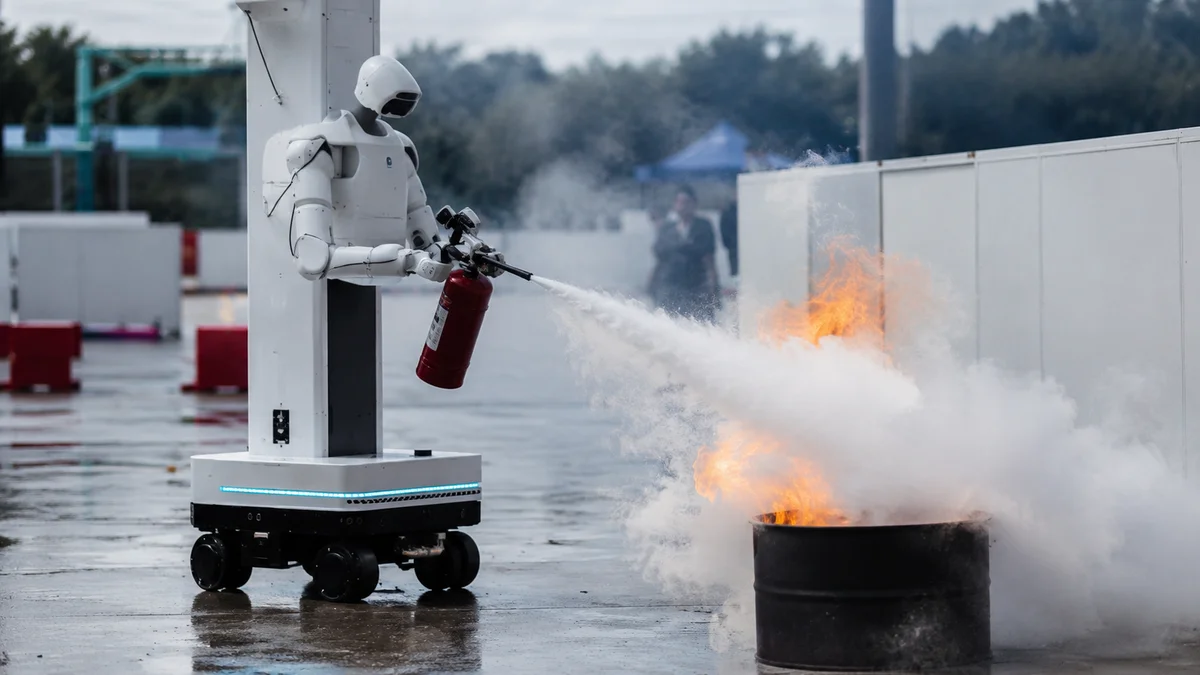
A segunda edição dos Jogos Mundiais de Robôs Humanoides colocou 23 equipes diante de uma missão prática de combate a incêndio em Pequim, com robôs atuando em uma unidade real do corpo de bombeiros. Na final de combate a incêndio, o humanoide da UniX AI foi um dos poucos a cumprir todas as etapas previstas dentro do limite de até 30 minutos.
A prova exigiu reconhecer materiais perigosos e classificar duas substâncias por imagens, fechar três válvulas de tipos diferentes e, por fim, localizar um extintor, identificar o fogo e acioná-lo corretamente. Das 12 equipes na rodada de domingo, apenas três terminaram todo o percurso, e condições como chuva e mudanças de iluminação dificultaram a percepção das câmeras e a execução precisa das ações.
O Twitch atualizou as configurações da conta para permitir que streamers optem por não ter posts, streams e vídeos usados para ajudar a treinar modelos de inteligência artificial da empresa-mãe, a Amazon. A plataforma, porém, não deixa claro desde quando esse uso de conteúdo começou, o que reacendeu discussões sobre como grandes empresas tratam dados de usuários.
O opt-out é feito nas configurações da conta, na seção de Segurança e Privacidade, em “Generative AI Training”. Ao desativar a opção, o Twitch informa que isso não impede o uso do conteúdo do canal para outros fins descritos na Privacy Notice, como recursos com IA para apoiar crescimento e monetização, recomendações e ferramentas de segurança como o AutoMod.
A Twitch passou a permitir que usuários optem por não ter conteúdo dos seus canais usado pela Amazon para treinar modelos de “conteúdo de IA generativa”. A mudança foi anunciada agora e ocorre mais de dois anos depois que um executivo da empresa confirmou o uso de conteúdo do Twitch para treinamento de IA.
Na página de suporte atualizada, a Twitch informa que, ao não permitir, streams, VODs, clipes, chats de stream e imagens e texto do canal deixam de ser usados em treinamento futuro de modelos da Amazon voltados a gerar ou sintetizar texto, áudio, imagens ou vídeo. Para sair, é necessário ajustar as configurações em www.twitch.tv/settings/security, enquanto usuários ficam automaticamente optados quando não alteram o padrão.