Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
O projeto ChatTJB, criado por Tucker Bryant, public speaker e ex-gerente de projetos na Google, usa um “chatbot” que não responde com um modelo de linguagem: ele próprio senta e responde manualmente aos prompts. A iniciativa ganhou tração após um outdoor de US$ 6 mil em São Francisco, que foi ao ar em 27 de julho, e já acumulou mais de 30 mil consultas até 6 de agosto, chegando a picos de cerca de 5 mil mensagens por hora.
Bryant diz que encara o ChatTJB como um projeto de arte e uma reflexão sobre a relação das pessoas com a tecnologia, incluindo o risco de “cognitive surrender” — aceitar respostas de IA sem questionar. Apesar de não ser contra a IA, ele quer provocar leveza e pensamento crítico, enquanto reúne voluntários e mantém a experiência no ar por tempo limitado, com uma opção de apoio mensal via “ChatTJB Pro”.
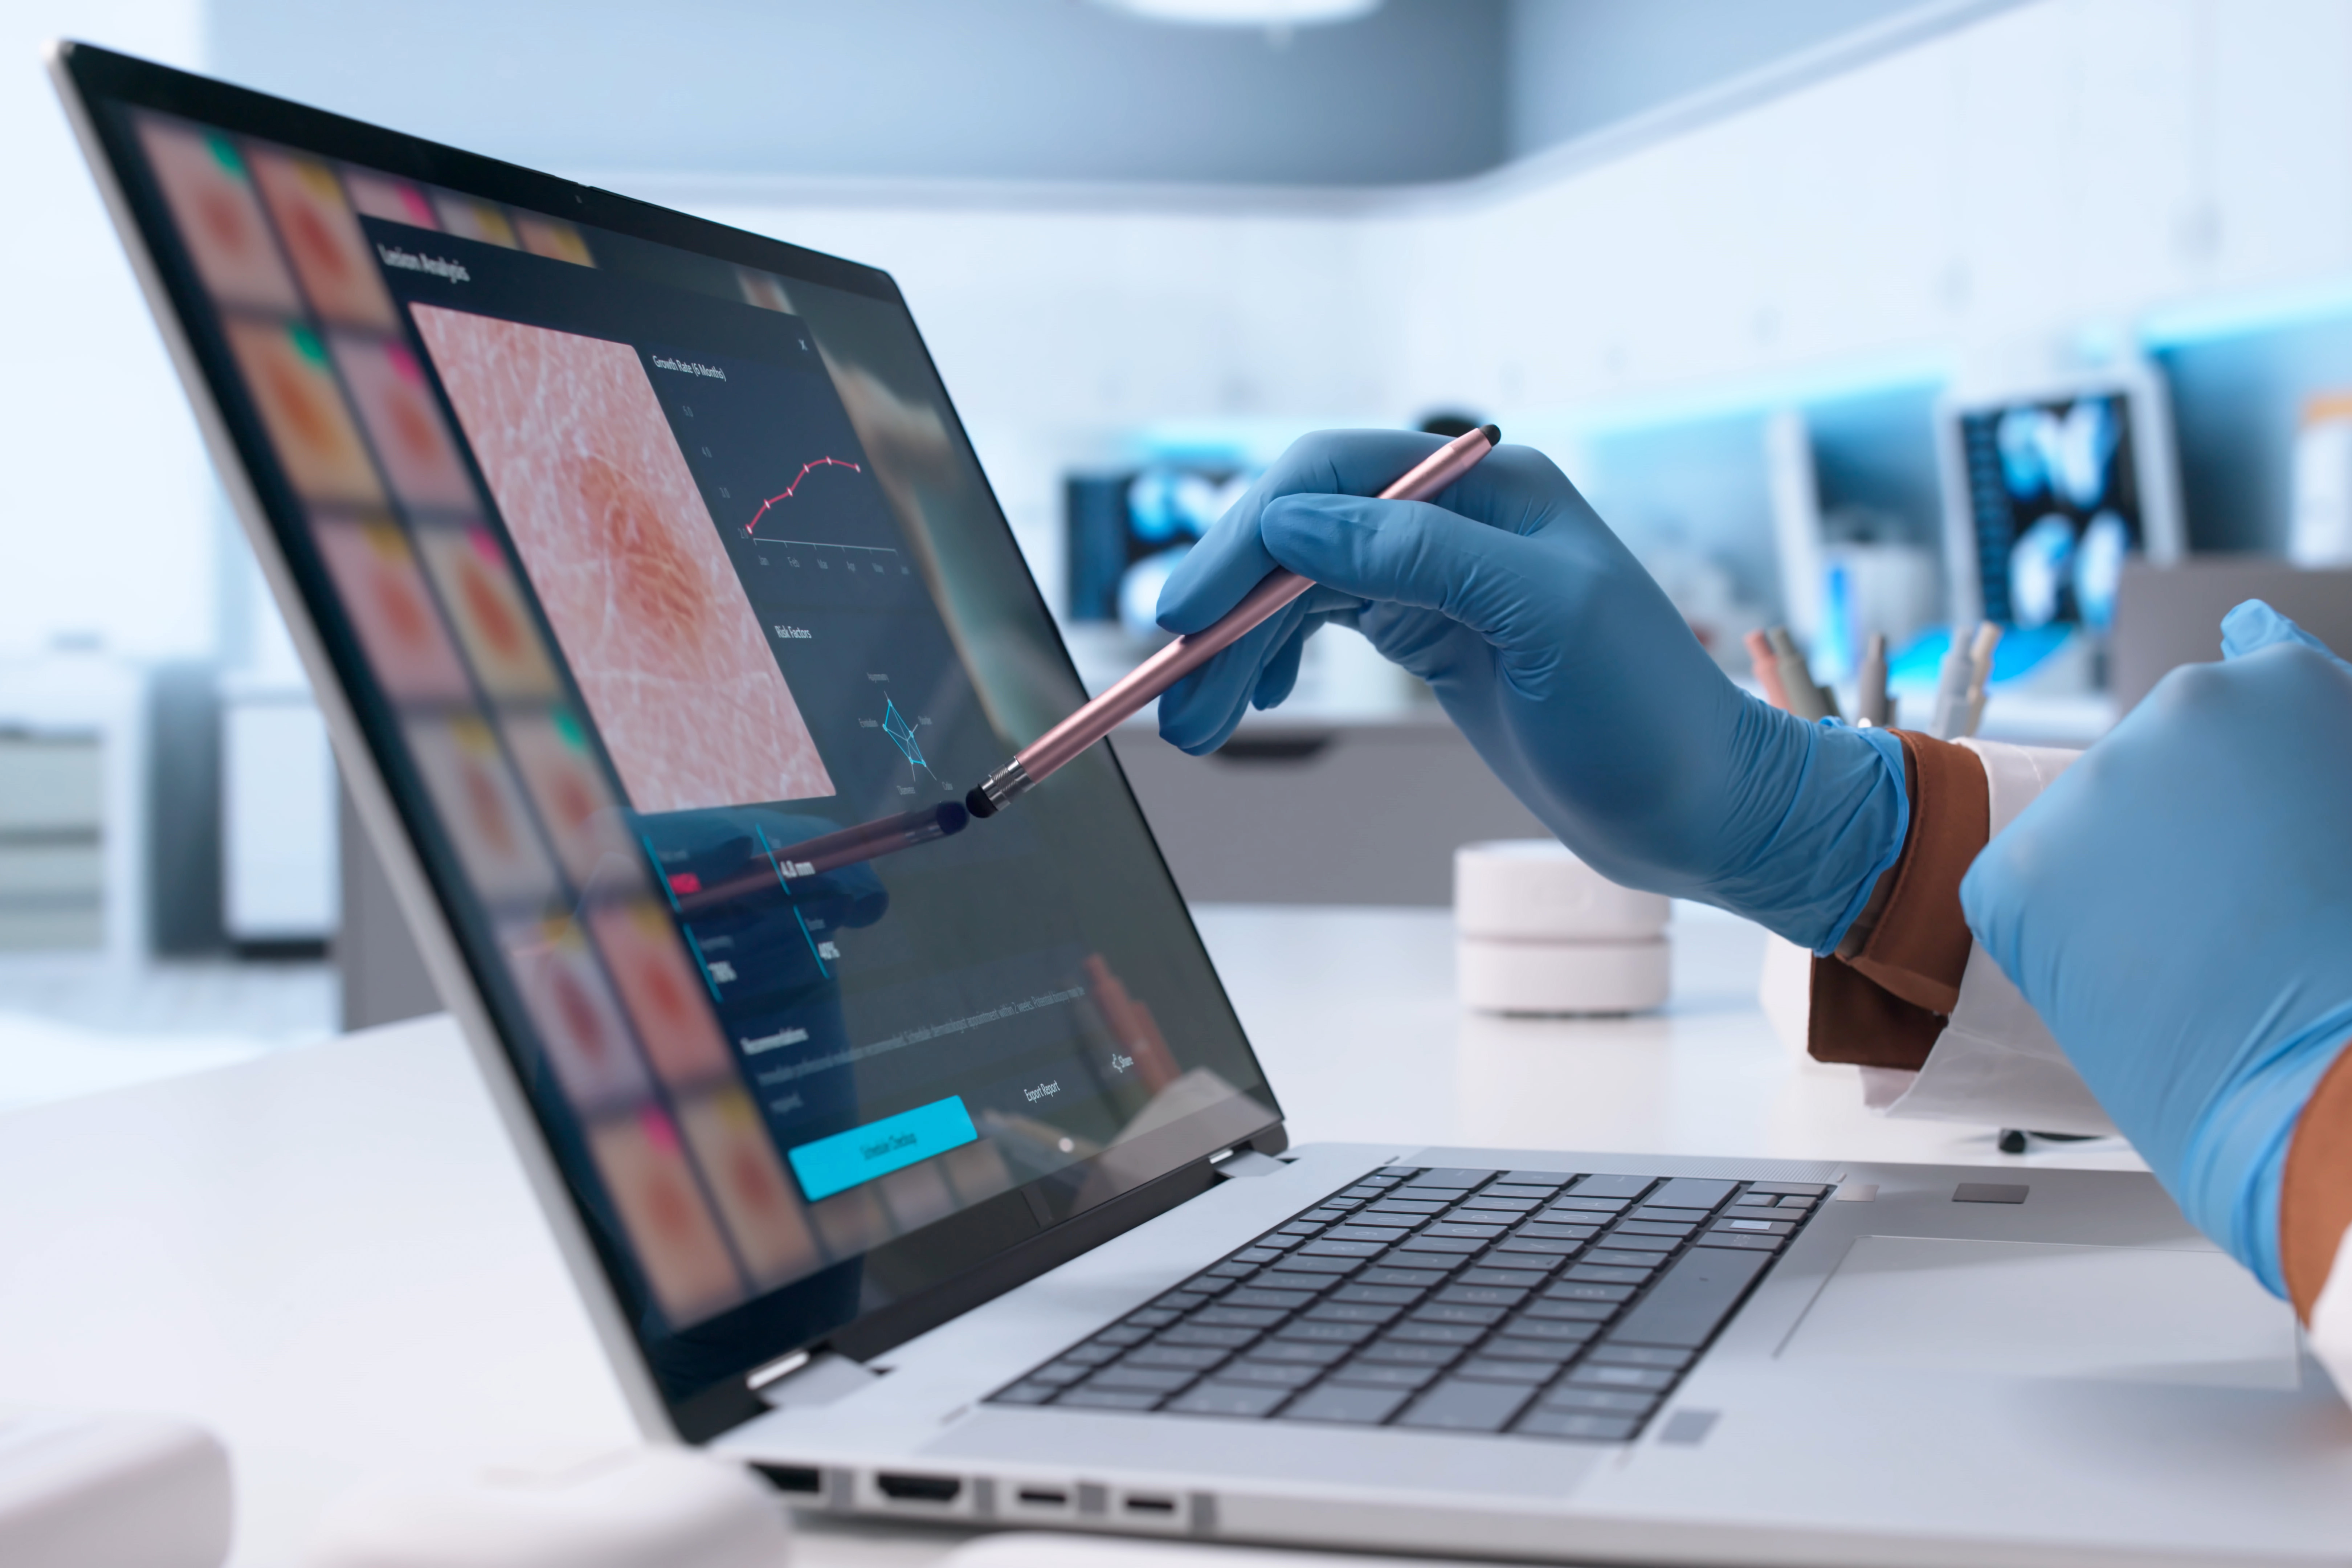
Um estudo conduzido por pesquisadores do MIT e parceiros avaliou como diferentes métodos de IA explicável afetam pessoas com níveis distintos de conhecimento na hora de diagnosticar doenças de pele. Os testes incluíram não especialistas e médicos de atenção primária, usando cenários com apenas a previsão do modelo ou com explicações como mapas de calor, imagens semelhantes e explicações em linguagem natural via LLM.
Os resultados mostram que não especialistas melhoraram a acurácia, mas em grande parte por “deferência” ao sistema: quando as explicações vinham de LLM, eles tendiam a confiar mesmo quando a previsão estava errada. Já os clínicos tiveram desempenho melhor quando recebiam apenas a predição, sem explicação, e foram menos afetados por explicações incorretas. A pesquisa reforça que a forma de apresentar a recomendação importa tanto quanto a qualidade do modelo — especialmente para quem tem menos base médica.
Um desenvolvedor relata que continua usando assistentes de código com LLMs em projetos pessoais, mas evita deixar o modelo “roam free” e gerar recursos inteiros sem revisão. A proposta é pedir que o LLM escreva o código no chat e, em seguida, digitar manualmente cada linha no editor, fazendo ajustes, refatorações e checagens para entender APIs e algoritmos (ex.: em um projeto Django, incluindo funcionalidades como tagging). Ele afirma que esse fluxo o deixa cerca de 2x mais rápido, porém com ganho de compreensão e menos risco de aceitar código com alucinações ou decisões ruins.
A ideia importa para devs porque troca produtividade imediata por controle e entendimento do que está sendo entregue. Na prática, o time pode usar LLMs para acelerar partes “chatas”, mas mantendo revisão ativa e construindo um “mapa” mental do códigobase — reduzindo a chance de o software ficar opaco demais para manutenção futura.